クロアチア語のRAG用LLMを3億パラメータでゼロから作ってみた。CPUで動く
前回の GPT-2 に続いて、今度はクロアチア語の LLM を RTX 4090 一枚でゼロから作ってみた。目的は RAG。渡した文章の中から答えを探して、根拠になる 1 文を引用しながら答えるモデル。そして本番は CPU で動かす前提。
先に結論。
- ゼロから完成まで GPU で約 68 時間(試行錯誤込み)。 うち事前学習が 51 時間
- 3.2 億パラメータ。段落の質問に 71%、3,000 トークン級の長文に 44% 正解
- CPU だけで 1 問 3〜16 秒で答える。文字がずらずら出てくるのが目で追える速さ
学習にかかった時間
| 工程 | 時間 | 内容 |
|---|---|---|
| 学習データ生成 | 約 4.5 時間 | EuroLLM-9B(vLLM)で Wikipedia QA 4.5 万件と会話の翻訳 5 万件 |
| トークナイザ・トークン化 | 約 2.5 時間(CPU) | クロアチア語用の語彙 3.2 万を自作 |
| 事前学習 | 50 時間 46 分 | 70 億トークン。最後の 1 割で文脈を 4,096 に伸ばす |
| SFT | 約 35 分 | 引用つきで答える・答えがなければ断る形を教える |
| 強化学習(GRPO) | 約 11 時間 | 400 ステップ+調整して 300 ステップ |
自作トークナイザはクロアチア語を GPT-2 のトークナイザの約半分のトークン数で表せる。4,096 トークンで約 1.7 万文字読める計算。
できたモデル
| 項目 | 内容 |
|---|---|
| パラメータ | 3.2 億(24 層・1024 次元) |
| 構造 | Llama / Qwen3 系(GQA、SwiGLU、RoPE、RMSNorm+QK-Norm) |
| 文脈長 | 4,096 トークン |
| 出力形式 | 答え+Izvor: „文脈からそのまま抜いた 1 文“。答えがなければ「U tekstu nema odgovora na ovo pitanje.(本文に答えはありません)」 |
| 実行 | CPU 前提(fp32 で約 1.3GB) |
さらに、生成した引用が本当に文脈にあるかをプログラムで照合して、なければ「答えなし」に差し替える仕組みを外側に付けた。モデルを信用しきらず、根拠を確かめられる形にするのがポイント。
作ってみて分かった問題
1. 答えがなくても、毎回でっち上げる。 最初は普通に質問応答だけ教えた。正解率は上がったけど、答えの入っていない文章を渡すと 100% それっぽい答えを作った。RAG で一番困るやつ。そこで引用と「断る」を教えたら、でっち上げは数 % まで減った。
2. 断りすぎる。 強化学習の採点を「間違えたら −0.5、断ったら 0」にしたら、難しい長文では断って逃げるのが得だと学んで、7 割も断るようになった。採点ルールの穴をきっちり突いてくる。断ったときを −0.3 にしたら、今度は逆に振れて全然断らなくなり、でっち上げが 4 割に。シーソーみたいに行ったり来たりした。
3. 引用の写し間違い。 長文では答えは合ってるのに、引用の語順を入れ替えたり、記事の 1 文目を引いたりする。引用まで正しかったのは長文脈で半分くらい。
4. 照合をすり抜ける間違い。 文脈に混ぜた別の記事の「〇〇で生まれた」という文を正確に引用して、別人の出身地を答えた。引用は本物なので照合では止められない。
5. 評価データ側の穴。 「答えのない文脈」のはずが答えの一部が残っていて、モデルは正しいのに「でっち上げ」と判定されていた例もあった。
最終的な性能
評価 300 問ずつ。使ったのは、調整した強化学習の 100 ステップ目のモデル(断る・答えるのバランスが一番よかった)。
| 文脈 | 正解 | 間違い | 断った |
|---|---|---|---|
| 段落(約 100〜400 トークン) | 71.3% | 16.7% | 12.0% |
| 長文脈(1,500〜3,500 トークン) | 44.0% | 20.3% | 35.7% |
| 答えのない文脈 | 正しく断った | でっち上げ |
|---|---|---|
| 段落 | 97.7% | 2.3% |
| 長文脈 | 92.3% | 7.7% |
照合を通したあとで「答えた中で正しかった割合」は 73.8%。目標の 90% にはまだ遠い。
ちなみに、1 問を 8 回解かせて 1 回でも正解すれば OK とすると、段落 91%、長文 74% まで解けていた(最後のチェックポイントで測定)。強化学習の前後でこの数字はほぼ変わらず、変わったのは「毎回解けるか」のほう。強化学習は新しい力を足すというより、たまに解ける問題を毎回解けるようにするものだというのが数字ではっきり出た。
CPU で動かしてみた
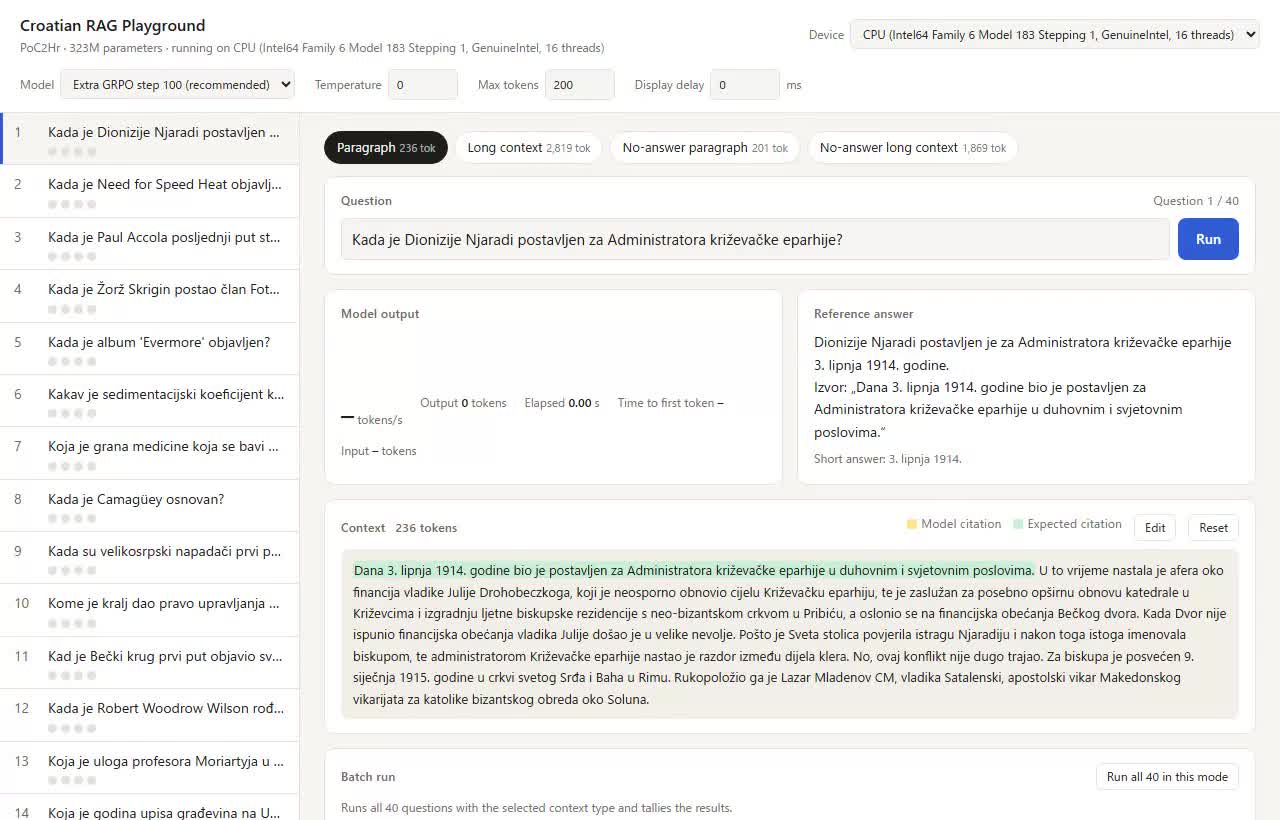
テスト用の Web UI を作って、CPU(i7-13700K)だけで動かした。文字が出てくる速さがそのまま生成速度。
段落(263 トークン): 最初の文字まで 0.3 秒、約 11 トークン/秒、全体 7 秒
長文脈(3,215 トークン): 文章を読み込むのに約 5 秒、約 5 トークン/秒、全体 19 秒。黄色が引用した文で、ちゃんと 3,000 トークンの中から正しい 1 文を見つけてる
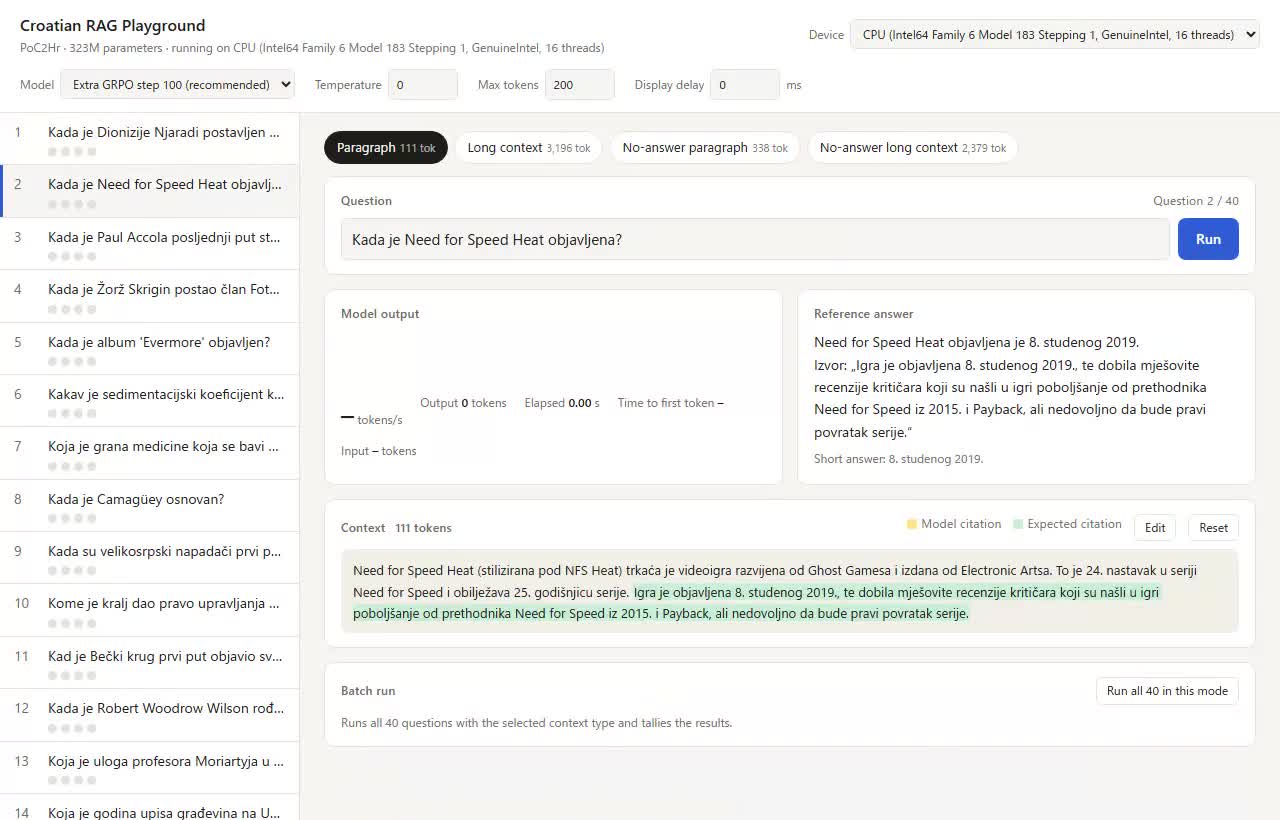
動画は録画しながらなので少し遅め。録画なしで 20 問ずつ測ると、段落 15 トークン/秒・1 問 3.4 秒、長文脈 7 トークン/秒・1 問 16 秒だった。答えは 50 トークン前後と短いので、CPU でも実用になりそうな速さ。
考察
- 小さいモデルは「知らないことを知らない」と言わせるのが一番大事。 正解率より、でっち上げを減らすほうが RAG では効く。引用+断る+外側で照合、の組み合わせはかなり効いた
- 3 億だと長文が限界。 8 回解かせても長文は 74% しか届かない。長文で 9 割を狙うなら 10 億パラメータくらいは欲しい
- 照合は「引用が本当にあるか」だけでは足りない。 引用に答えの数字や名前が入っているか、主語が質問の人物と同じかまで確かめる必要がある
- CPU で動く 3 億モデルは、ネットに出せない文書の Q&A にちょうどいい。 GPU なしのノート PC やサーバーで、手元の文書だけを根拠に答えさせられる。速度は 1 問数秒〜十数秒で、量子化すればもっと速くなるはず(未検証)
次は 10 億パラメータ版で、長文脈 9 割を狙ってみたい。