RTX 4090一枚でGPT-2をゼロから作ってみた。1日で本家超え、チャットもできるようにした
自宅のRTX 4090一枚で、GPT-2(124M)をゼロから学習してみた。データの準備から事前学習、チャットできるようにする指示チューニング(SFT)まで、全部自分のPCでやってる。
先に結論を書くと、こんな感じ。
- 事前学習は約21時間で完了。 常識推論テストのHellaSwagで30.5%。本家GPT-2 124Mの29.4%を超えた
- SFTは2時間弱。 学習開始からわずか5分で会話っぽい返事をするようになった
- ただし中身はハルシネーションだらけ。「パリの人口は24億人」「12+7=30」とか平気で言ってくる
GPT-2がだんだん賢くなっていく様子が面白かったので、その過程をまとめておく。
環境
- GPU: RTX 4090(24GB)
- CPU: i7-13700K / メモリ64GB
- OS: Windows 11(WSLは使わず、Windowsでそのまま)
- PyTorch 2.11 nightly(CUDA 12.8)+ triton-windows
コードはKarpathyのnanoGPT/build-nanogptと同じやり方。Claude Codeに「このPCのGPUで1日でできる範囲のGPT-2を作って」と頼んで、構成の提案からスクリプト作成、学習の監視まで一緒にやってもらった。
データの準備:10Bトークンが12分で揃った
学習データはFineWeb-Edu(教育系の高品質な英語Webテキスト)の10Bトークン版。parquetで約27GB。
最初は素のHugging Faceのダウンロードで1.7MB/sしか出なくて、全部落とすのに4時間以上かかる計算だった。hf_transferを入れたら60〜70MB/sになって、2GBのファイルが30秒で落ちてくる。ボトルネックがトークナイズ側に移って、ダウンロードとトークナイズ合わせて約12分で全部揃った。
ちなみに最初、キャッシュの保存先を変えるHF_HOMEをhuggingface_hubのimportの後に書いてたせいで、設定が効かずに別ドライブにダウンロードされてた。この環境変数はimport時に読まれるので、importより前に設定すること。地味にハマる。
学習の設定
| 項目 | 内容 |
|---|---|
| モデル | GPT-2 small(12層・768次元、1億2400万パラメータ) |
| 1ステップ | 約52万トークン(16×1024を32回の勾配累積) |
| ステップ数 | 16,000(約8.4Bトークン) |
| 速度 | 約12万トークン/秒 |
| VRAM | 約12GB |
Windowsだとtorch.compileは動かないからWSLで、という話をよく聞くけど、triton-windows入りの環境ではそのまま動いた。
10Bトークン全部だと24時間を超えるので、1日に収まるように8.4Bトークンに削ってる。
小ワザとして、語彙数を50257から**50304(128の倍数)**に切り上げてる。GPUの行列計算が速くなるKarpathyの有名なテクニックで、これが後のチャット化で思わぬ形で役に立った。
事件:2.5時間で学習が止まった
途中経過を見たら、学習が止まってた。原因はHellaSwagの評価データ。nanoGPT系のコードはGitHubのrowanz/hellaswagからデータを取ってくるんだけど、そこが**「451 Unavailable For Legal Reasons」**(法的理由で公開停止)になってた。404エラーで評価ごと学習が落ちてた。
Hugging Face上のRowan/hellaswag(中身は同じ10,042問)から読むように直して、500ステップごとに保存してたチェックポイントから再開。評価が失敗しても学習は止めないように、try/exceptで囲んだ。
長時間の学習では、評価やログみたいな「本体以外」の失敗で学習を落とさない。 これ大事。
結果:本家GPT-2を超えた
検証データのlossはこんな感じ。最初の1時間で一気に下がって、あとはじわじわ下がっていく。
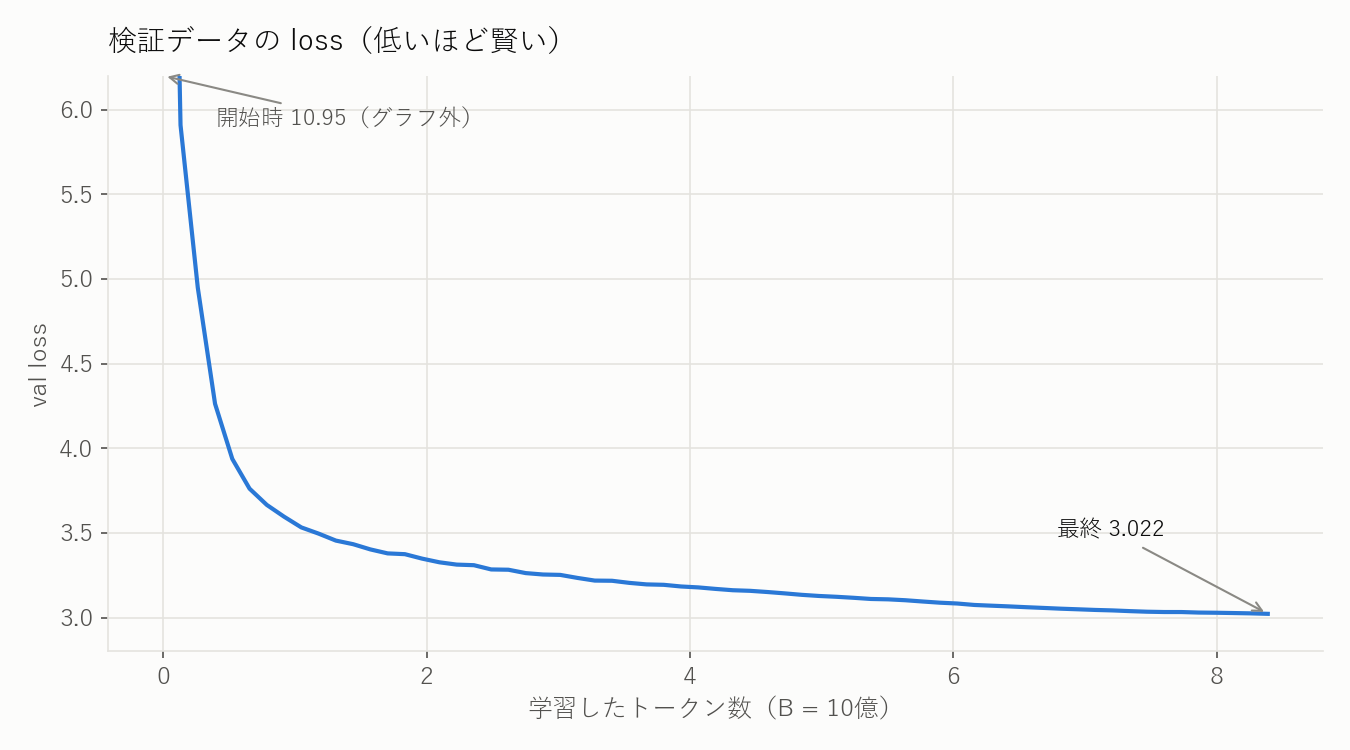
開始時のlossの10.95は、ln(50304)≒10.83とほぼ同じ。つまり5万語から完全にあてずっぽうで選んでる状態からスタートしてる。
HellaSwagの正答率はこう。
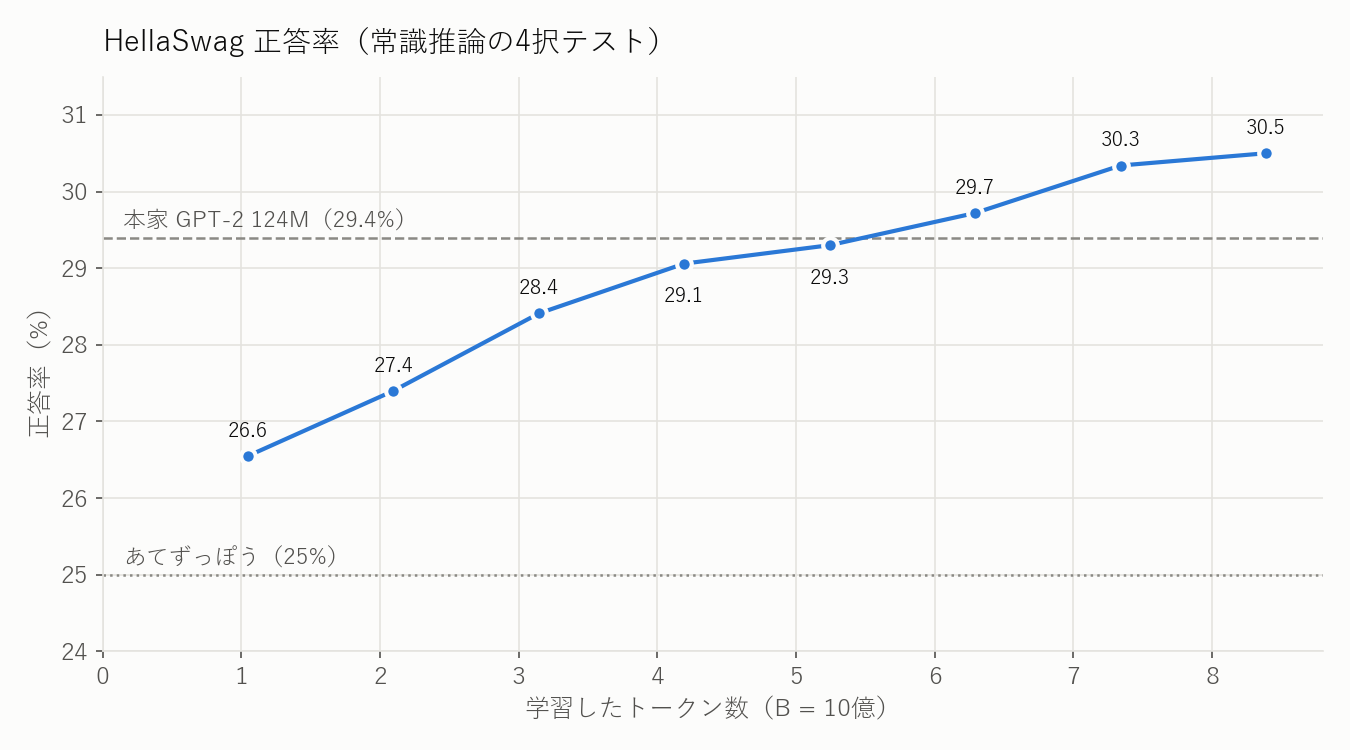
約6.3Bトークン(step 12,000)で本家GPT-2 124Mの29.4%を超えて、最終的に30.5%。本家GPT-2はWebTextで学習してる。こっちはFineWeb-Eduで、教育系の質の高いデータを使ったのが効いてると思う。
だんだん賢くなっていく様子
学習中、1時間ごとに同じプロンプトで文章を生成して記録してた。これが一番面白かった。
学習前(ランダムな状態)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
単語が完全にランダムに並んでるだけ。
37分後(0.26Bトークン)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
文の形にはなってる。「首都の話」なのは分かってるのに、フランスの首都をスコットランドの首都って言ってる。
約2時間後(0.79Bトークン)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
文法はかなり自然になった。そのかわり、専門用語を並べてそれっぽいウソをつくようになった。ハルシネーションの原型って感じ。
約2.1Bトークン
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
ついにParisって言えた!……と思ったら、直後に「フランスは世界の鉄鋼の50%を生産」とウソの統計を付け足してくる。
完成したベースモデルに質問してみた
Question: ... Answer:の形で10問聞いてみた。
- What is the capital of France? → (a)〜(i)の選択肢を並べて、問題集を作り始める
- Who was Albert Einstein? → 「1918年11月16日、ミズーリ州セントルイス生まれ。父は鉱夫で、本人は学校の先生」。全部ウソだけど、伝記っぽい書き方はできてる
- What is 12 plus 7? → 「12 plus 7 is an arithmetic expression.」。計算せずに定義を語りだす
知識はそこそこ持ってるけど、「質問に答える」という振る舞いを知らない。ベースモデルはあくまで「文章の続きを書く」機械なので、そこは当然。
SFTでチャットできるようにした
ここから、ChatGPTみたいに質問に答えられるようにする**指示チューニング(SFT)**をやった。
- データ: Hugging Faceの
smol-smoltalk(約46万会話、2.7億トークン) - チャット形式:
<|user|><|assistant|><|end|>みたいな区切り記号を追加。ここで、さっき語彙を50304に切り上げた空き番号を使い回した。モデルの構造を変えずに特殊トークンを追加できたので、速度目的の小ワザがここで役に立った - 学習するのは回答部分だけ: 質問文は読むだけで、真似させるのはアシスタントの回答と、最後の
<|end|>だけ - 2エポック、約1時間50分
ポイントは<|end|>まで学習させること。これで、モデルが言い終わったら自分で止まるようになる。ChatGPTとかも、終わりの記号を出したら生成を止めるっていう同じ仕組み。
たった5分で会話っぽくなった
SFTを始める前(step 0)は、知らない区切り記号に混乱して「jakjakjakjak…」と無限ループしてた。それが500ステップ(約5分)でもう会話っぽくなった。
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
しかもちゃんと言い終わって止まる。話し方を覚えるのは一瞬だった。
ただし知識は相変わらず。途中のモデルは「パリは世界最大の都市で、人口は約24億人」とか言ってた。
SFT前後で比べてみた
同じ質問でSFT前(ベースモデル)と後を比べた。
| 質問 | SFT前 | SFT後 |
|---|---|---|
| What is the capital of France? | 選択肢(a)〜(i)を並べだす | 「The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.」 |
| Who are you? | 「I am the person who has the gift for all that I do.」 | 「I'm a language learning AI assistant with over 10 years of experience」(AIなのに経験10年) |
| Translate "Good morning" into French. | 質問と関係ない話をしだす | 「Bonjour!」(正解。でもその後「Good morning (modifier)」を延々繰り返す) |
| What is 12 plus 7? | 「arithmetic expressionです」 | 「12 + 7 = 21」→「12 + 7 = 30」→「35 + 7 = 34」と、それっぽい解き方でどんどん間違える |
| Who was Albert Einstein? | 父は鉱夫の学校の先生 | 「prominent physicist」と大枠は合ってる。ただし「1905年2月24日ウィーン生まれ」はウソ |
口調や形式は完全にアシスタント。中身はウソが多い。 計算は壊滅的だった。
実際にチャットしてみた
ターミナルで会話できるchat.pyを作って、話しかけてみた。
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
「1文で」っていう指示に従えてる。 これはベースモデルにはできなかったこと。
別の会話で、首都を聞いたあとに続けて人口を聞いてみた。
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
前の会話を受けて「there=日本」と理解はしてる。でも人口5万人と言った直後に北部に15億人住んでるとか、もう滅茶苦茶。
日本語で「日本の首都は?」と聞いたら、こう返ってきた。
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
英語のデータしか学習してないので、日本語は「添削してほしい謎の文章」に見えたらしい。
最後に「GPUについての俳句を書いて」と頼んだら、「I see the world, the thoughts, the emotions」を延々と繰り返す詩になった。俳句とは。
やってみて分かったこと
- 4090一枚で、1日あれば本家GPT-2を超えるモデルが作れる。 GPUの電力は約430W。電気代はGPUだけでざっくり300円くらい(推定)
- 話し方は一瞬で身につくけど、知識は事前学習で決まる。 SFTは5分で会話形式になったけど、事実の正確さはほとんど変わらない
- 124Mのモデルは、文法はほぼ完璧だけど中身はウソだらけ。 流暢さと正しさは別物っていうのが、手に取るように分かる
- 長時間学習はインフラ側でコケる。 今回止まったのは、モデルじゃなくて評価データの置き場所が消えてたせい
自分で一から作ると、ChatGPTみたいなAIが「文章の続きを予測する機械」に「会話の作法」を教えたものなんだっていうのが、体感で分かる。次は、もう少し実用に寄せたモデル作りもやってみたい。