Qwen-Image 2.1完全ガイド:7Bで画像生成・編集・透過PNGを統合、Redditで話題の作例100選
2026年9月20日、Qwenチームは画像生成モデル「Qwen-Image 2.1」を公開した。最大の特徴は、テキストからの画像生成、参照画像を使った編集、複数画像の合成、ローカル編集、そして透明背景(RGBA)の生成・編集を、ひとつのモデルにまとめたことだ。画像生成部は70億パラメータ。巨大化一辺倒ではなく、ローカル環境でも扱いやすいサイズと処理効率を狙っている。
結論から言えば、Qwen-Image 2.1は「何もないところから最高の一枚を描くモデル」というより、「既存画像を壊しすぎず、複数の素材を組み合わせ、狙った部分を変える制作モデル」として特に面白い。Redditでも評価が集中しているのは編集、キャラクター整合性、商品合成、アウトペイント、透過素材である。一方、手指、遠景の顔、細部ノイズ、黒つぶれ、古写真復元、アニメ調などには明確な弱点報告もある。
この記事では公式情報をもとに全機能を整理し、Redditの主要スレッドを横断して、話題になった生成・編集テストを「作例100選」としてまとめる。なお、100件は100個の独立投稿という意味ではなく、複数の人気投稿・ギャラリー・ワークフロー内で検証された個別の作画テーマや編集操作を数えたものだ。
Qwen-Image 2.1とは
Qwen-Image 2.1は、Qwenファミリーの統合型画像生成・編集モデルである。公式説明では、生成部に32層のSingle-Stream DiTと70億パラメータを採用。Qwen3-VL 8Bが文章指示と条件画像を共通の表現に変換し、64チャンネルのRGBA VAEが16倍の空間圧縮とネイティブ透明度を担う。
公式が掲げる改善点は次の4つだ。
- 小型・高効率:混合粒度アテンションとprefix KV cache再利用で、品質と計算コストのバランスを改善。
- 生成と編集の統合:通常画像と透明画像を同じモデルで生成・編集できる。
- 多用途編集:最大10枚の参照画像、マスクや描き込みによる局所指定、人物・商品の同一性保持に対応。
- 質感と美観:タイポグラフィ、ポートレート照明、微細な質感を改善。
出典:Qwen公式ブログ、公式GitHub、Diffusersドキュメント
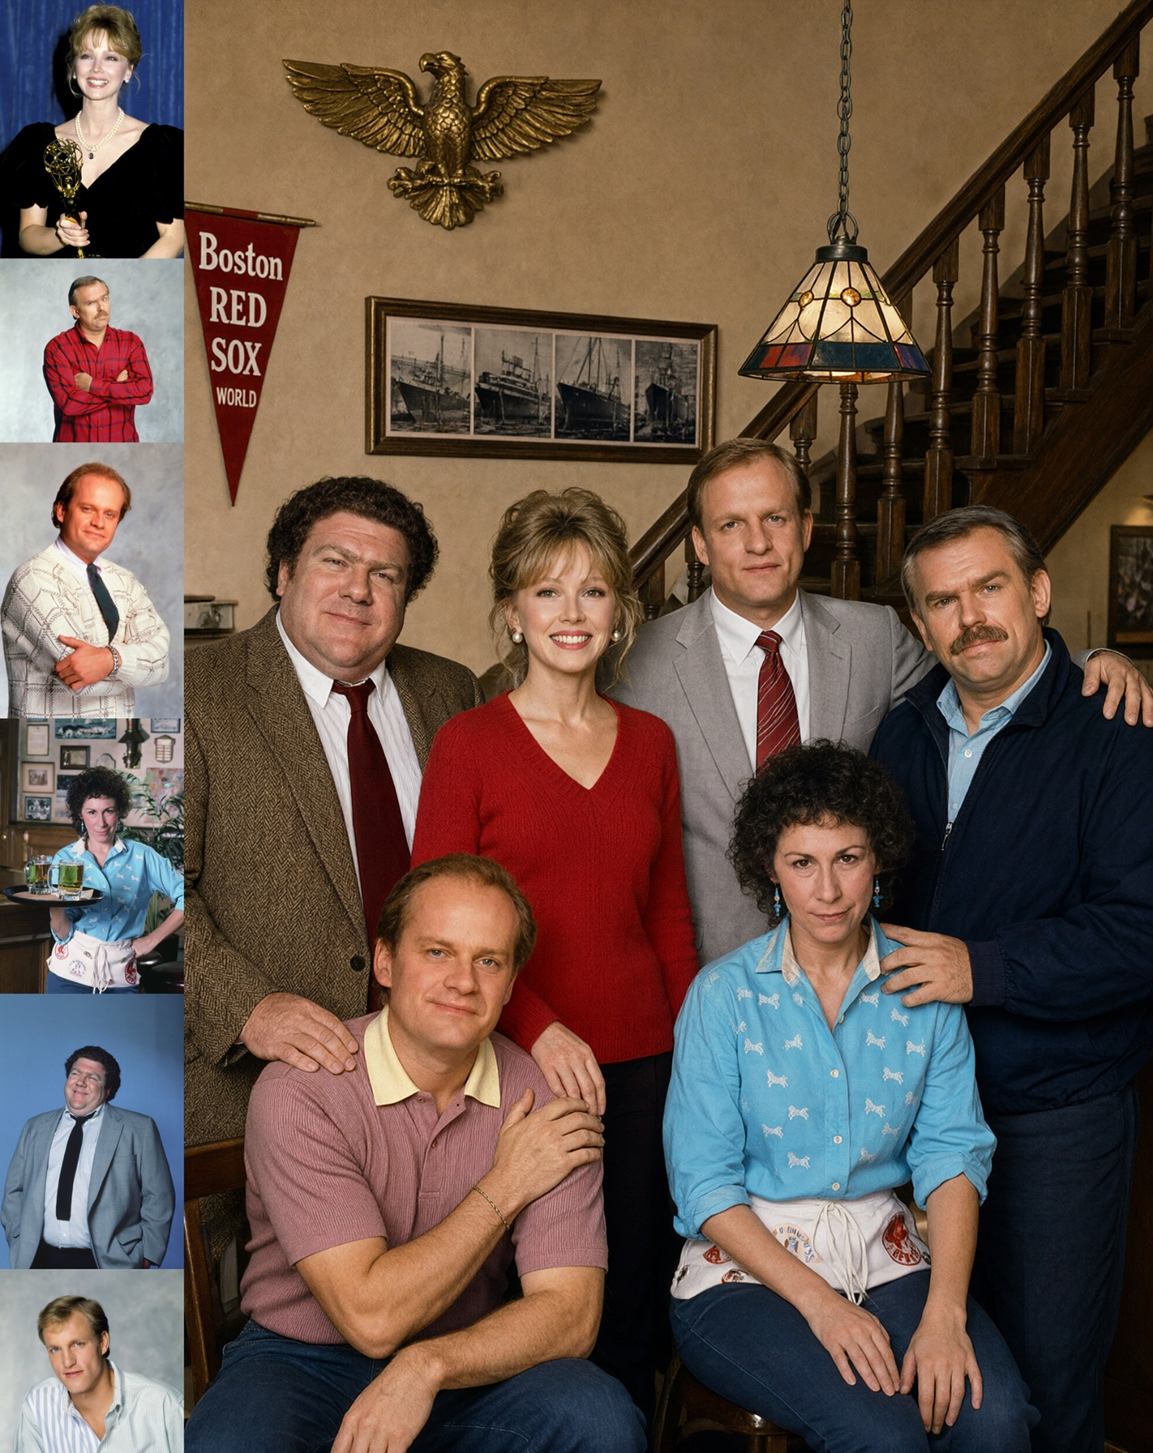
全機能を整理する
1. テキストから画像生成
通常のText-to-Imageに対応する。短い指示だけでなく、Qwen3-VLを介した長い自然文、構図、光、材質、前景・背景、文字要素を含む複雑な指示を扱える。公式例は40ステップを基本にしているが、コミュニティでは8~16ステップの高速化LoRA、30~40ステップの品質重視設定も試されている。
2. 画像編集
入力画像と指示文を同時に与え、色、天候、背景、服、ポーズ、材質、照明、カメラ角度などを変更できる。Redditでは、純粋なT2Iより編集のほうが強いという意見が多い。
3. 最大10枚の参照画像
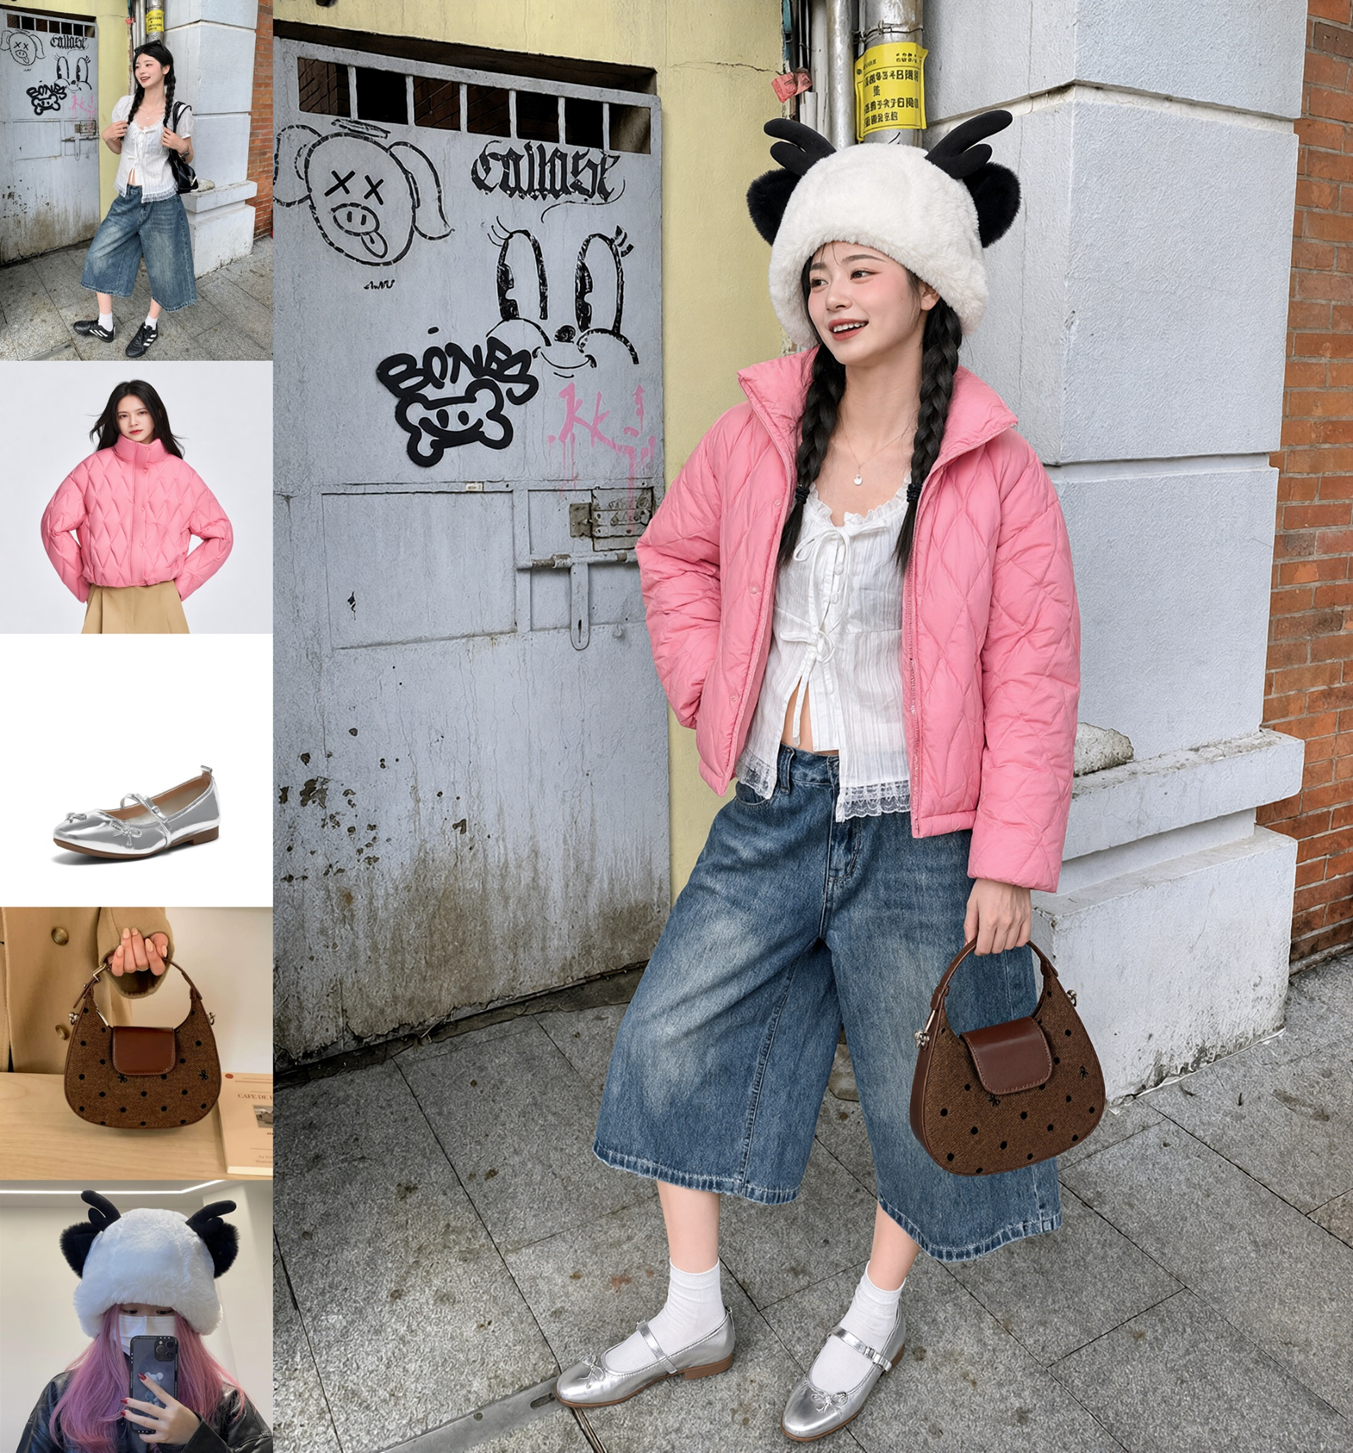
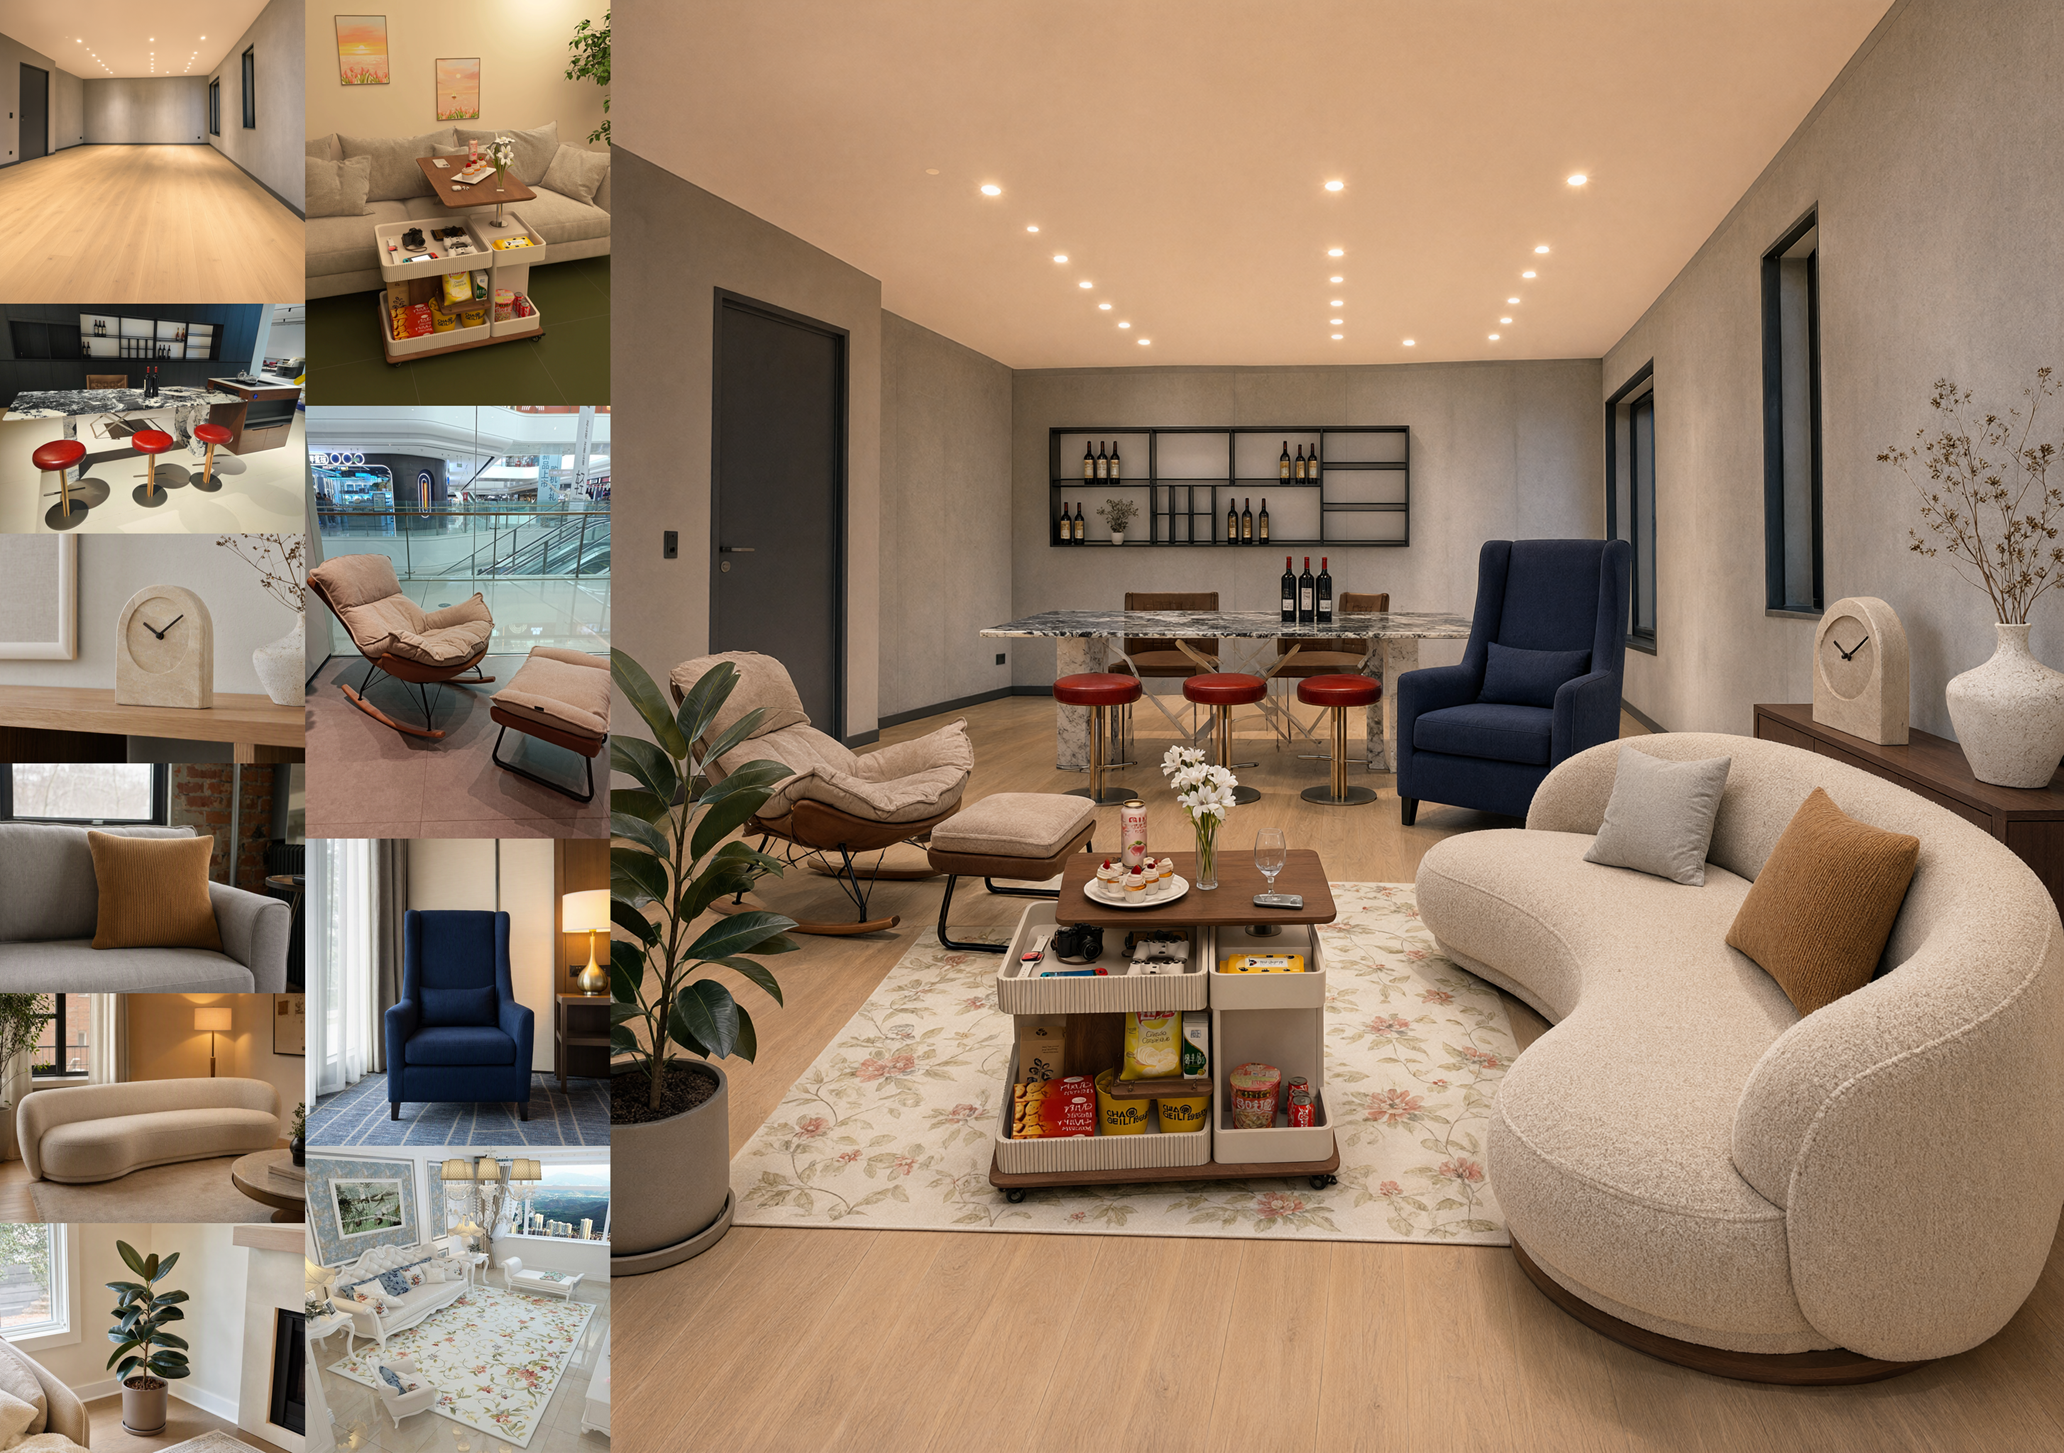
人物、衣服、靴、バッグ、帽子、家具、商品などを別々の画像から取り込み、ひとつのシーンへ統合できる。公式例には6人分の顔をまとめた集合写真、5素材のバーチャル試着、10点の家具による室内設計がある。ただし参照が増えるほど、競合する指示や属性混合が起きやすいというコミュニティ報告もある。
4. ネイティブRGBA・透明背景
背景を後処理で消すだけでなく、透明チャンネルを含む画像を直接生成できる。写真から被写体を切り出す、透明素材の形状を編集する、複数要素を含む透過アセットを作る、といった用途に向く。
5. 局所編集とマスク編集
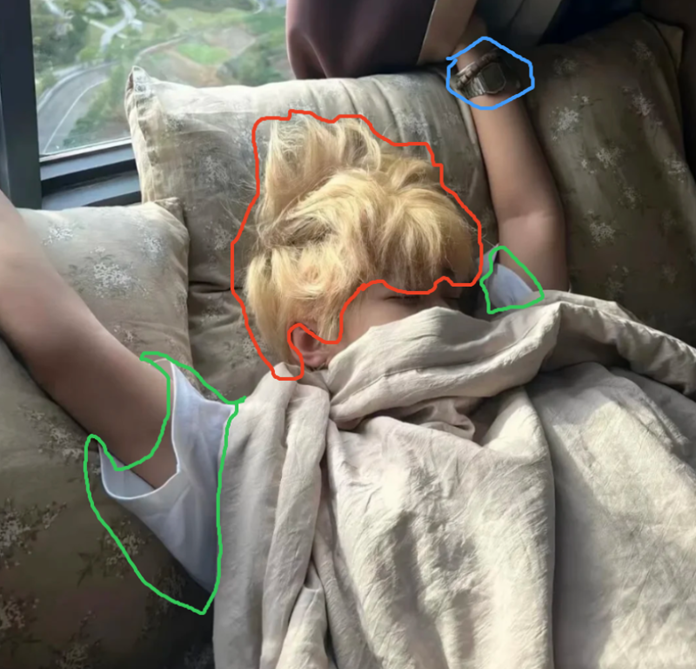
円、塗りつぶし注釈、独立マスクで変更箇所を指定できる。ComfyUIでは画像上に色を塗り、「赤い領域の服だけ変更」のような指示が試されている。LanPaintとの組み合わせでは、色だけでなくアルファチャンネル自体のインペイントも可能だ。
6. アウトペイント
キャンバスの上下左右を広げ、空白部分を元画像の文脈に合わせて描き足せる。Redditでは複数方向を一度に拡張でき、従来の専用ワークフローより速いという報告が注目された。
7. 同一性保持
人物の顔、衣装、姿勢、商品の形状やブランド要素を保持しながら、背景や一部属性だけを変える用途が中心。キャラクターシートや連続カット制作で特に話題だが、極端な角度、強い表情、長い連続シーケンスではドリフトの検証が必要である。
8. テキスト描画とデザイン
ポスター、パッケージ、看板、タイポグラフィを含む画像に対応する。構図、情報階層、文字サイズ、余白を外部LLMで整理してから渡すワークフローが人気。ただし英語インフォグラフィックで意図しない中国語が混ざるという報告もある。
9. プロンプトリライト
公式リポジトリにはT2I用とI2I用のプロンプトリライターがある。短い要求を詳細な構図へ展開し、編集時には変更箇所以外を維持する指示へ書き換える。コミュニティからは、標準リライトより用途別テンプレートのほうが良い場合があるとの報告も出ている。
10. 高速化・省メモリ・量子化
DiffusersのCPU offload、vLLM-Omniのprefix KV cache、CUDA Graph、FP8、テンソル並列、SGLangのメモリオフロードと最適化カーネルに対応する。ComfyUI向けにはBF16、INT8 ConvRot、GGUF、4bit系の派生版も登場している。4ステップLoRAで約2倍高速というユーザー報告や、8GB VRAMでプロンプト拡張を動かすカスタムノードもあるが、速度と品質の交換条件は必ず確認したい。
11. 対応環境
公式実装、Hugging Face Diffusers、ComfyUI、vLLM-Omni、SGLang-Diffusion、LightX2V、ModelScopeが案内されている。AMD Radeon向けROCm例や、FlagOS経由の複数チップ対応も紹介されている。
12. ライセンス上の注意
モデルは重みが公開されているが、Apache 2.0ではなく「Qwen Research License Agreement」で提供される。公式ライセンスは、商用利用に別途商用ライセンスが必要だと明記している。再配布時の通知義務、派生AIモデルの文書での「Built with Qwen」または「Improved using Qwen」表示などもある。業務導入前に必ず原文を確認してほしい。
出典:公式ライセンス
公式作例で見る50の視点
ここでは、Qwenチームが公開したQwen-Image 2.1の公式サンプルを中心に、Redditで特に議論された論点と対応させながら50点を掲載する。単なる「きれいな一枚」だけでなく、入力、編集結果、マスク、複数参照、カメラ変更、資料生成まで含め、モデルが制作工程のどこで役立つかを見られる構成にした。
透過素材とイラスト生成
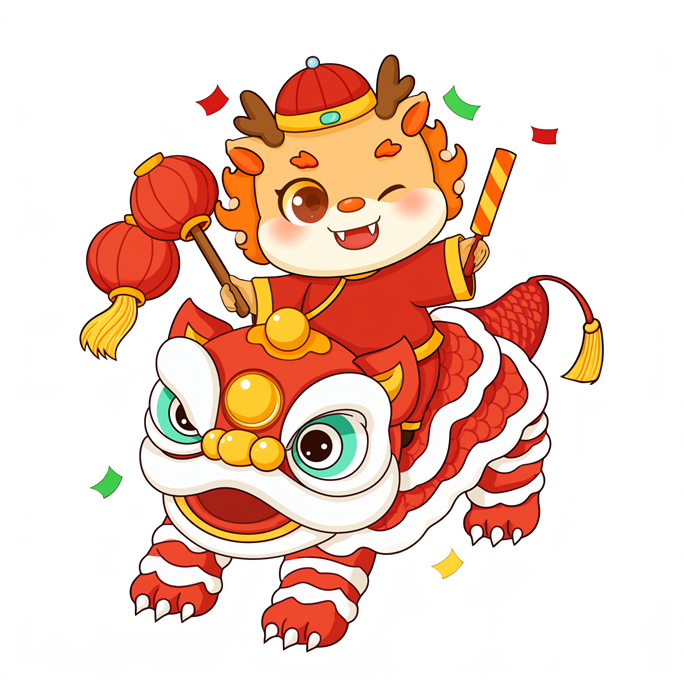
作例1:獅子舞モチーフの透過イラスト。 輪郭の細かい装飾とアルファ背景を同時に扱う例。
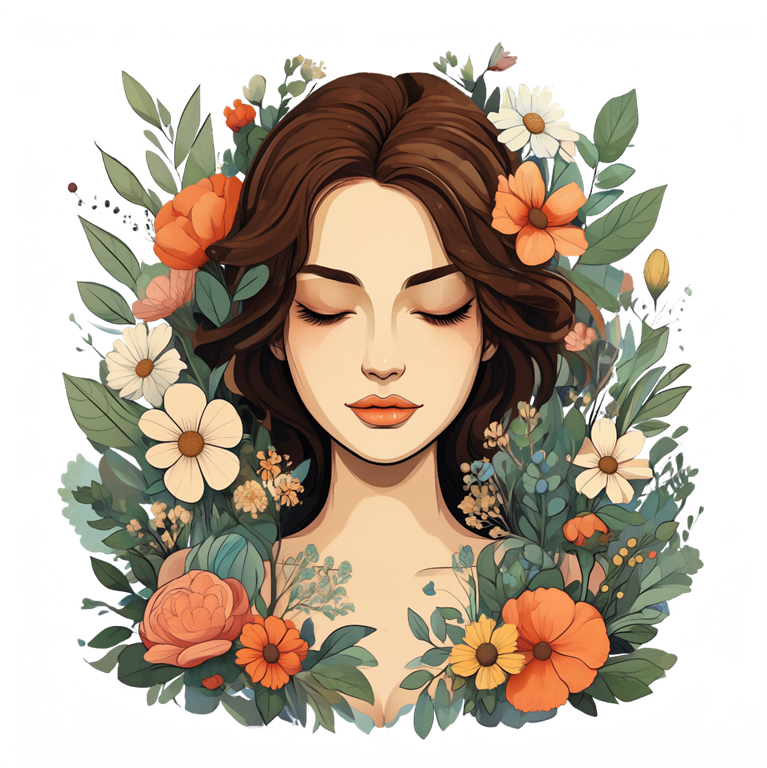
作例2:花に囲まれた女性の装飾イラスト。 髪、花弁、葉の複雑な境界を含む。
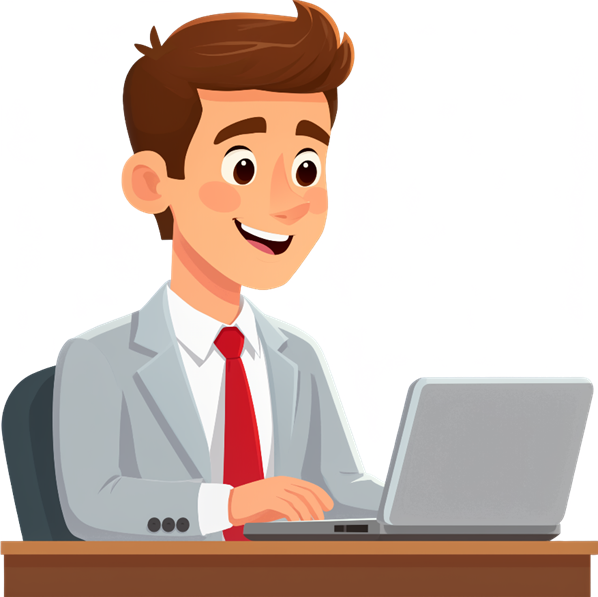
作例3:ノートPCを使うビジネス人物。 Webやプレゼン素材向けのカットイラスト。
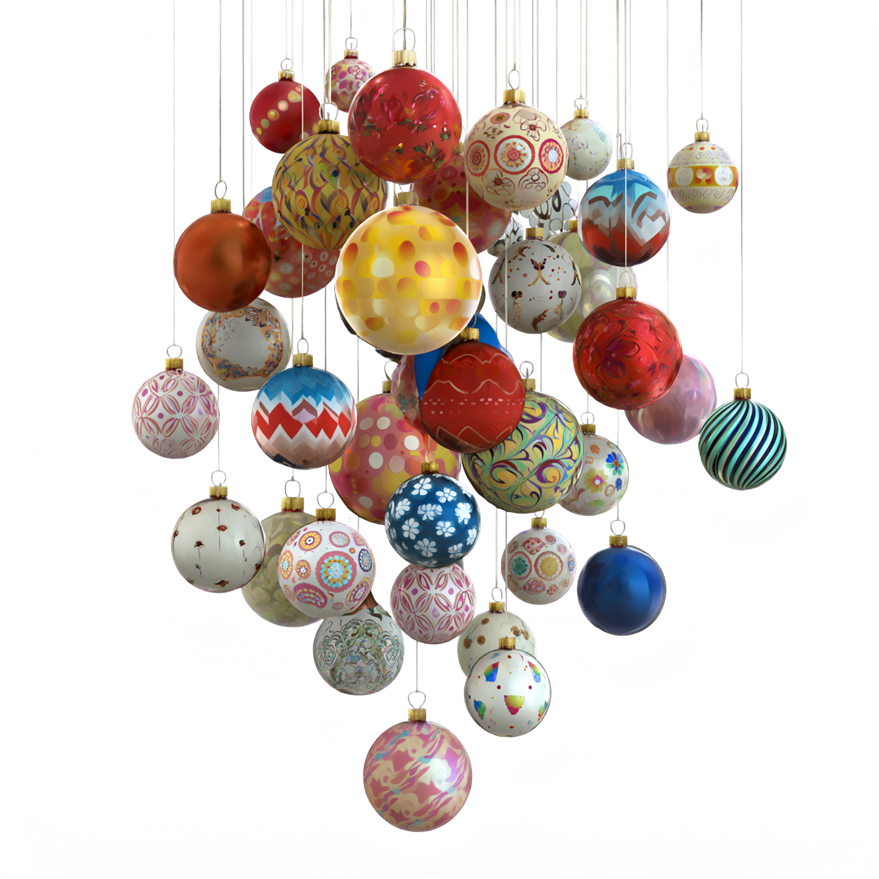
作例4:複数の吊り下げ装飾。 半透明感、細い糸、異なる素材感を一枚へ統合する。
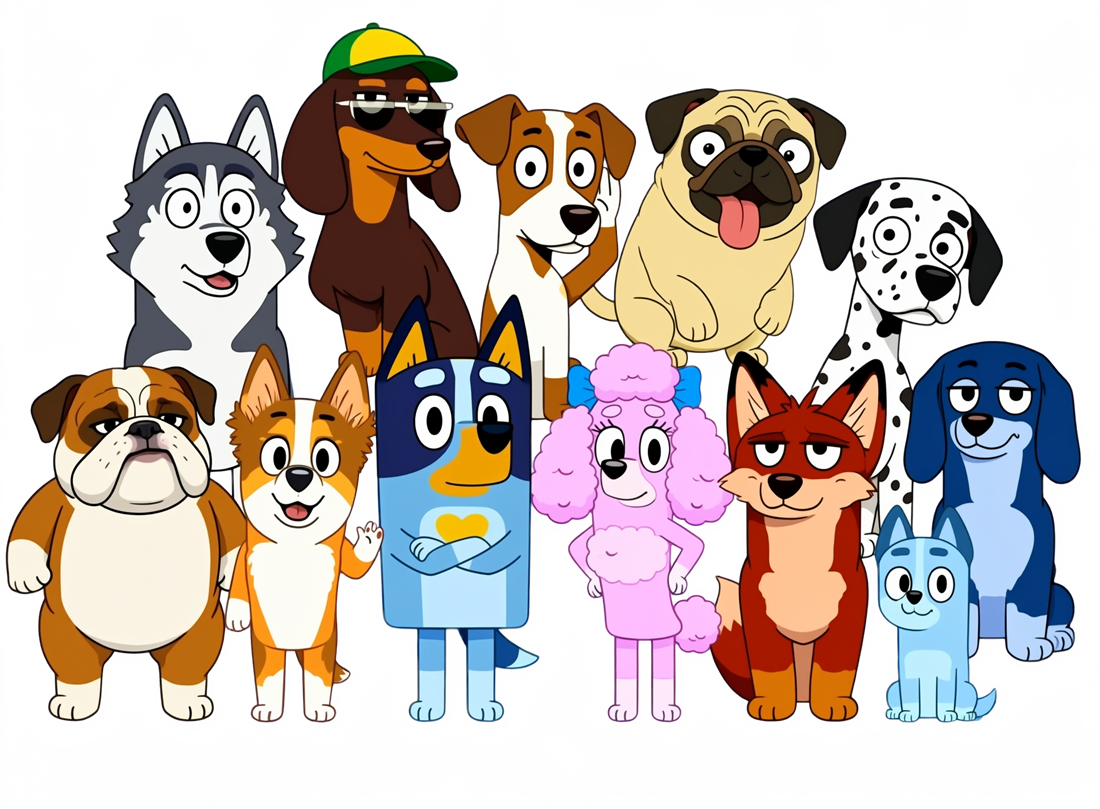
作例5:多数の犬キャラクター。 複数主体の描き分けと集合構図の例。
画像編集と文字の差し替え
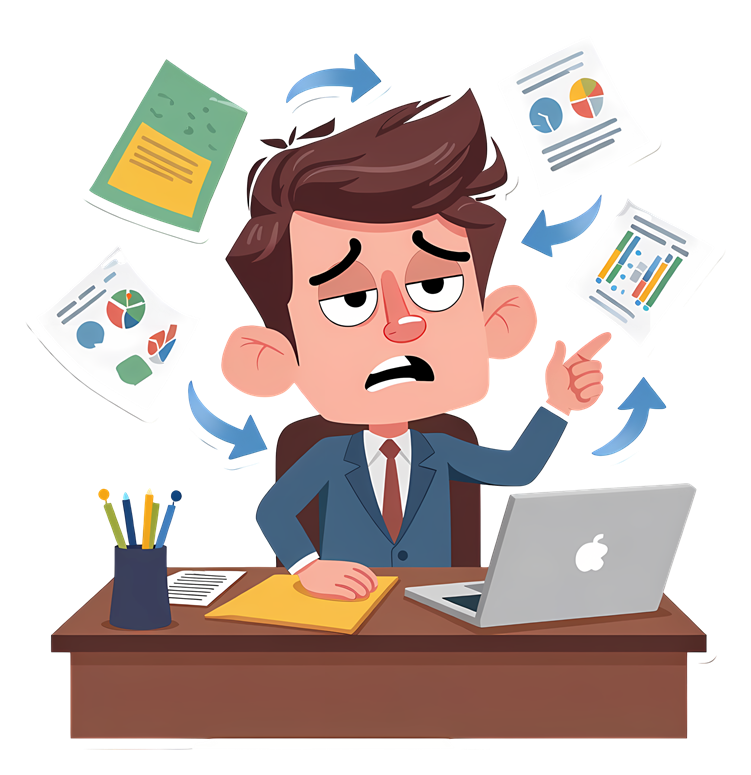
作例6:疲れた会社員の元画像。 次の編集結果と比較するための条件画像。
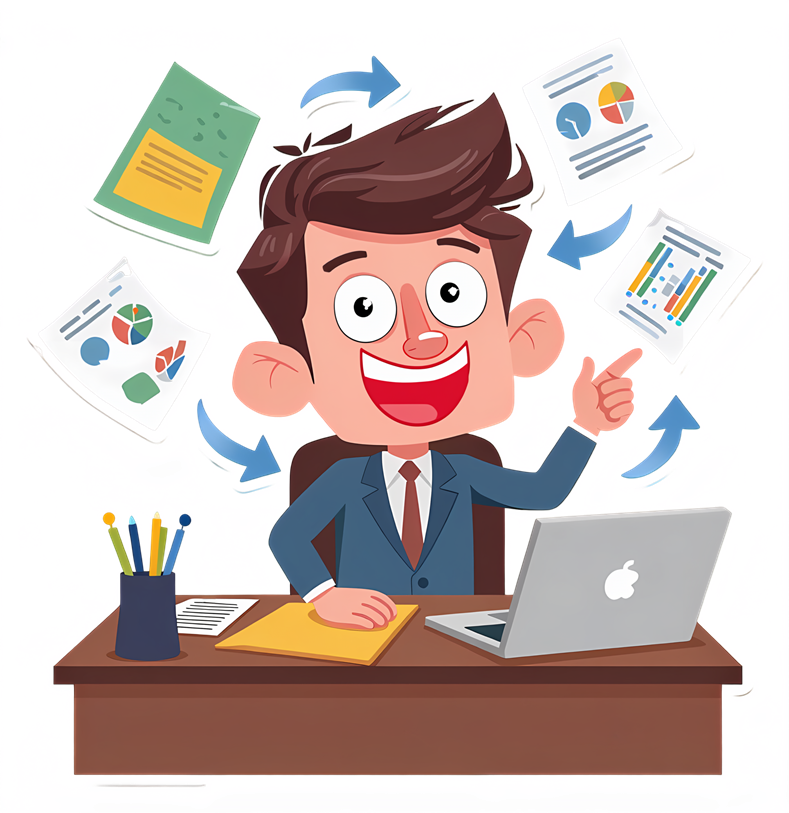
作例7:表情と雰囲気を変更した会社員。 レイアウトを保ちつつ人物の感情を変えている。
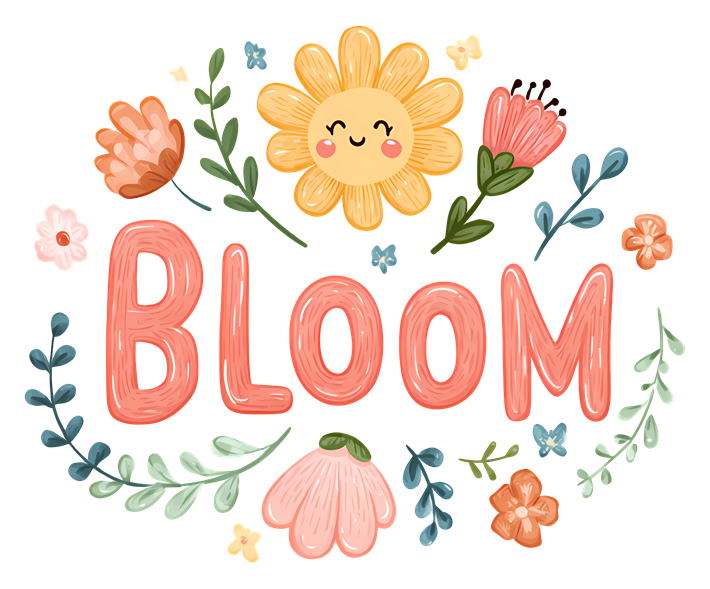
作例8:「BLOOM」の花文字。 文字、装飾、中央配置の基準例。
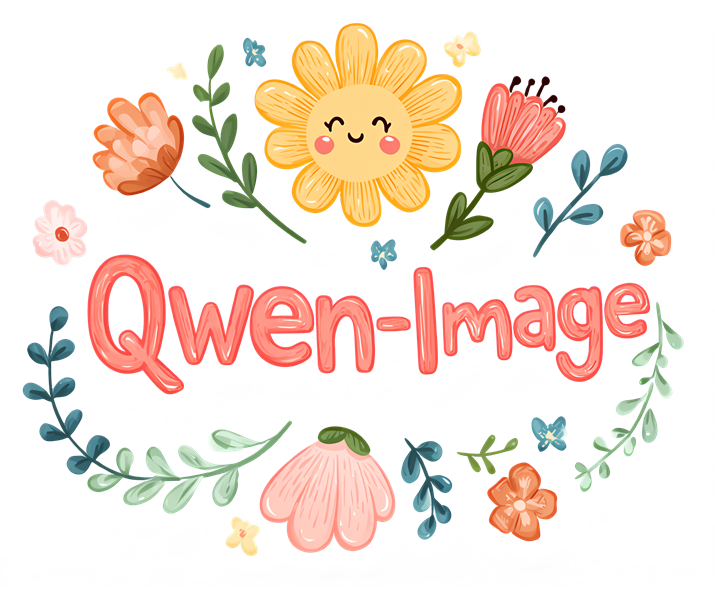
作例9:「Qwen-Image」への文字差し替え。 花のスタイルを保ったタイポグラフィ編集。
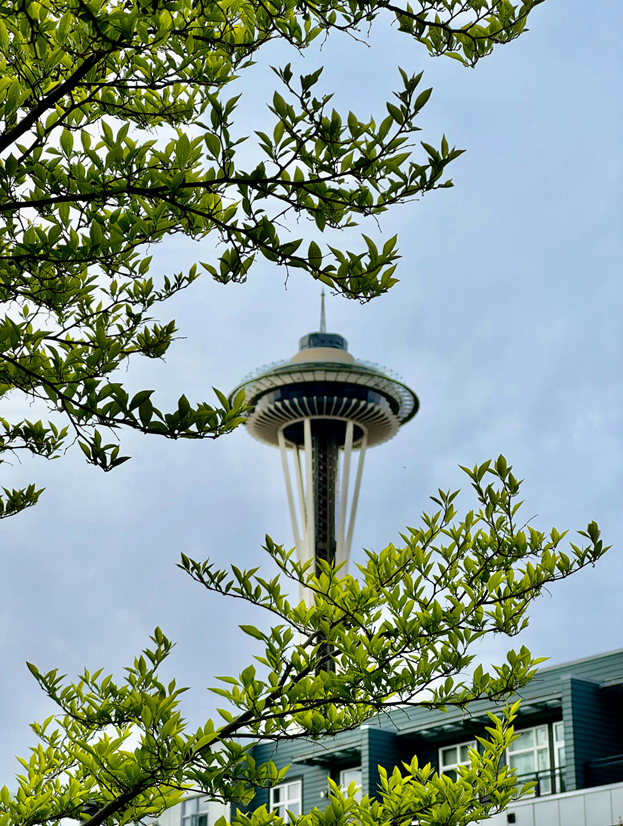
作例10:昼のタワー写真。 時間帯・背景編集の入力例。
背景・時間帯・複数人物
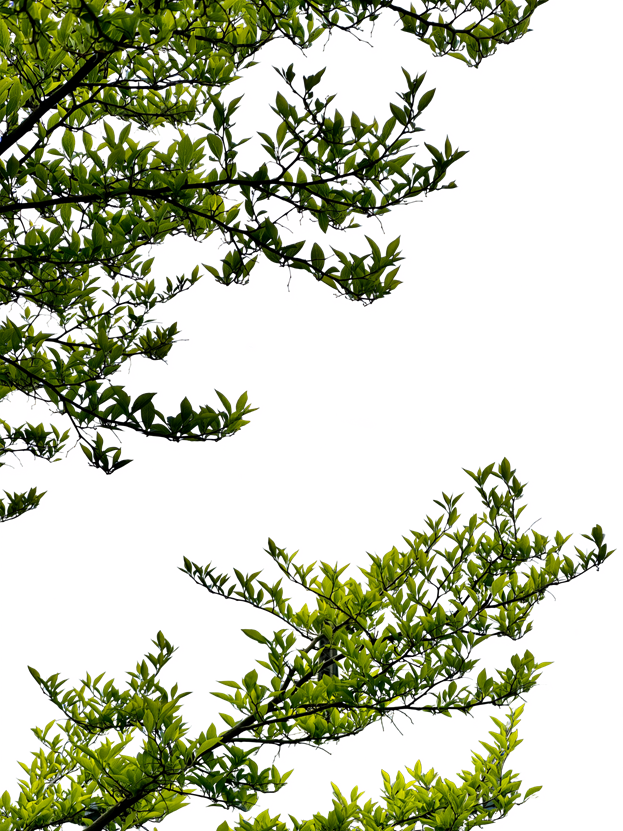
作例11:夜の花木。 日中写真から夜景や雰囲気を変える編集能力を見る例。
作例12:複数の人物参照から集合写真を生成。 最大10参照という機能の中核を示す。
作例13:衣服と人物の複数参照によるコーディネート。 バーチャル試着の考え方に近い。
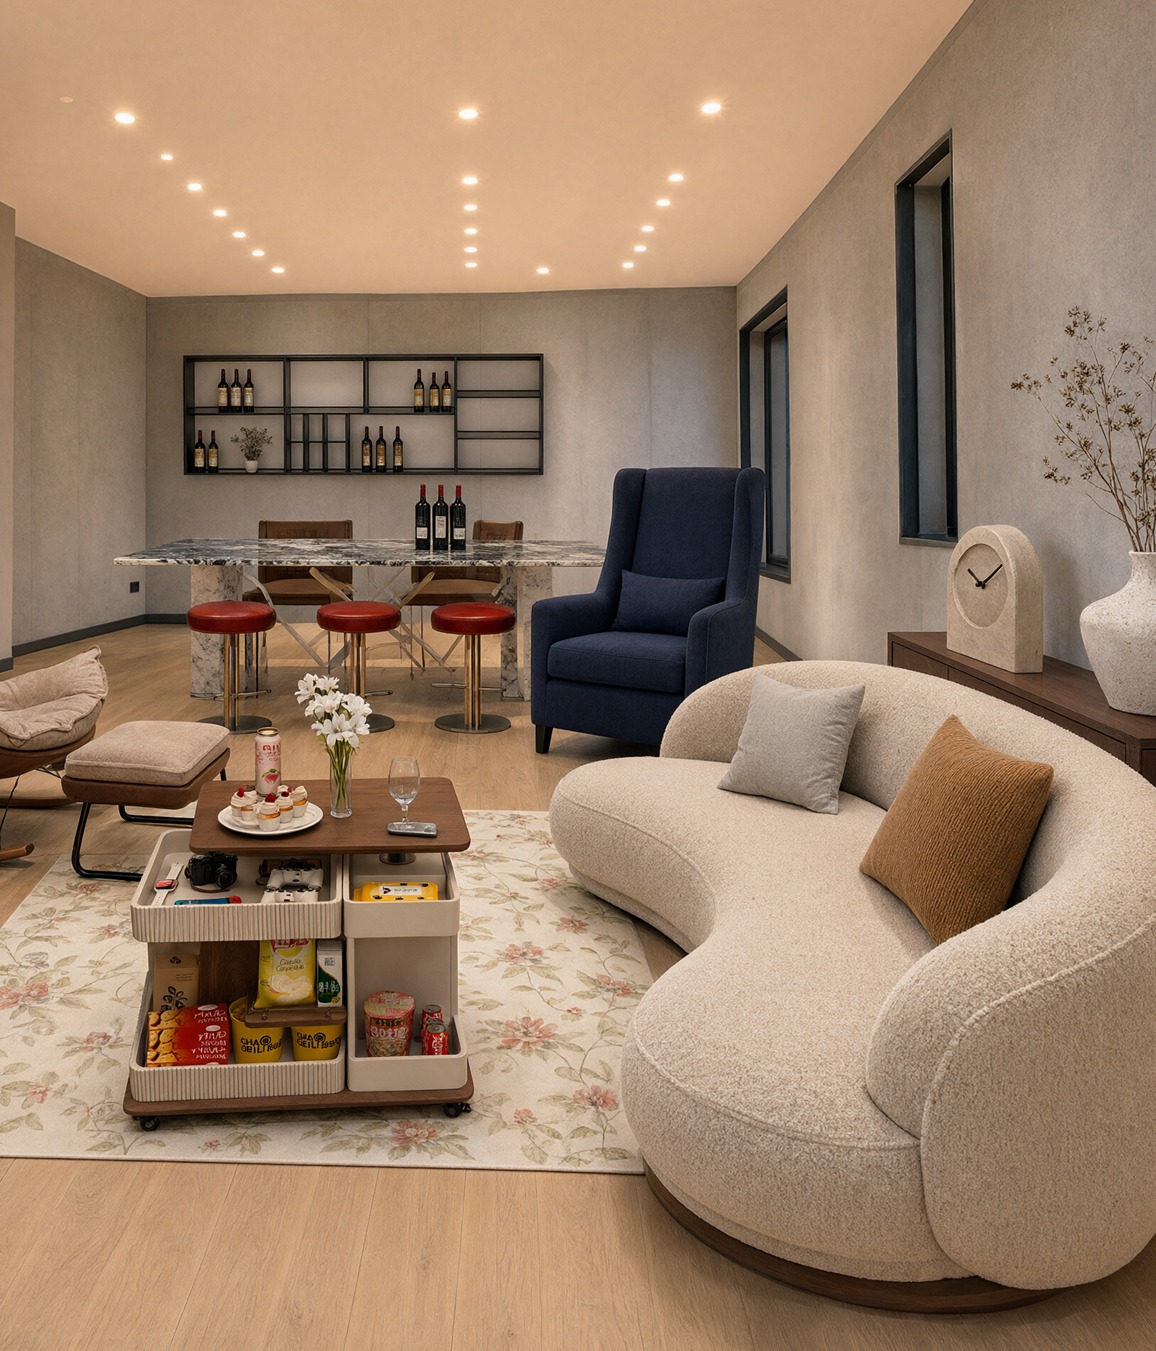
作例14:多数の家具画像から室内を構成。 商品カタログを部屋へ配置する用途。
作例15:猫の周囲へ色で指示を描き込む。 描画注釈による局所指定の入力。
局所編集・マスク・合成
作例16:指定領域だけで猫を変更。 寝具や人物を保ちながら被写体を置き換える。
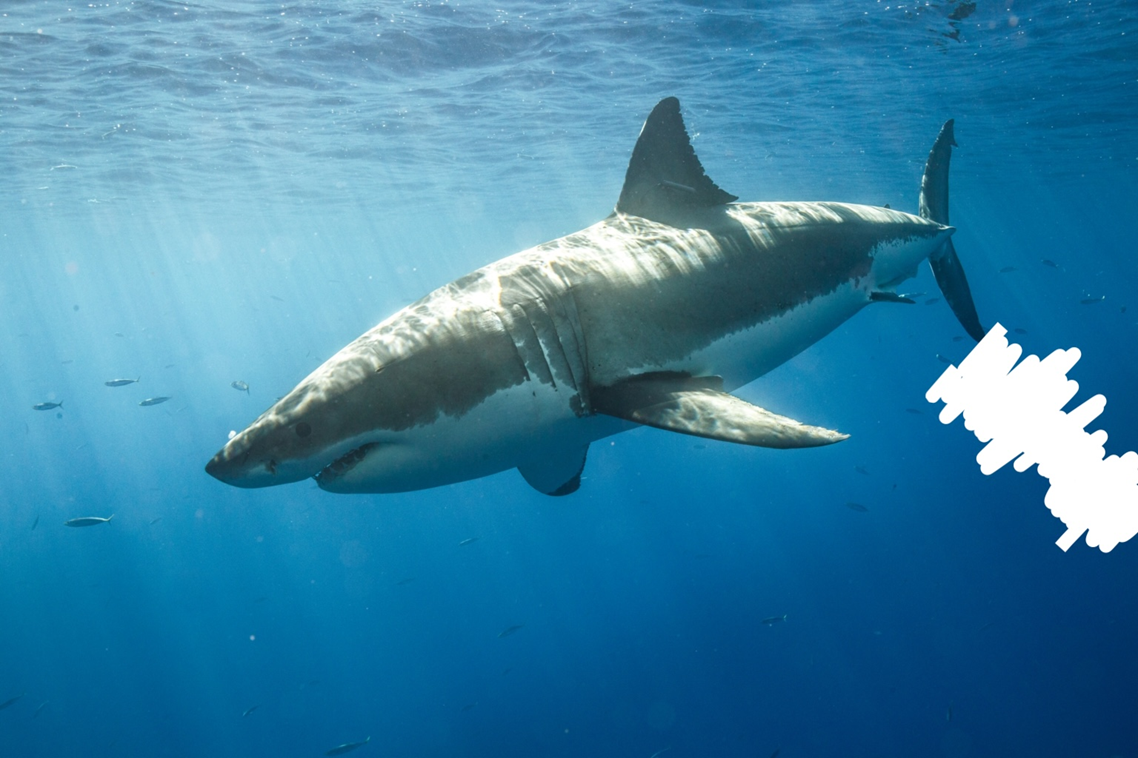
作例17:海中のサメと局所指示。 対象物へ直接描き込む編集入力。
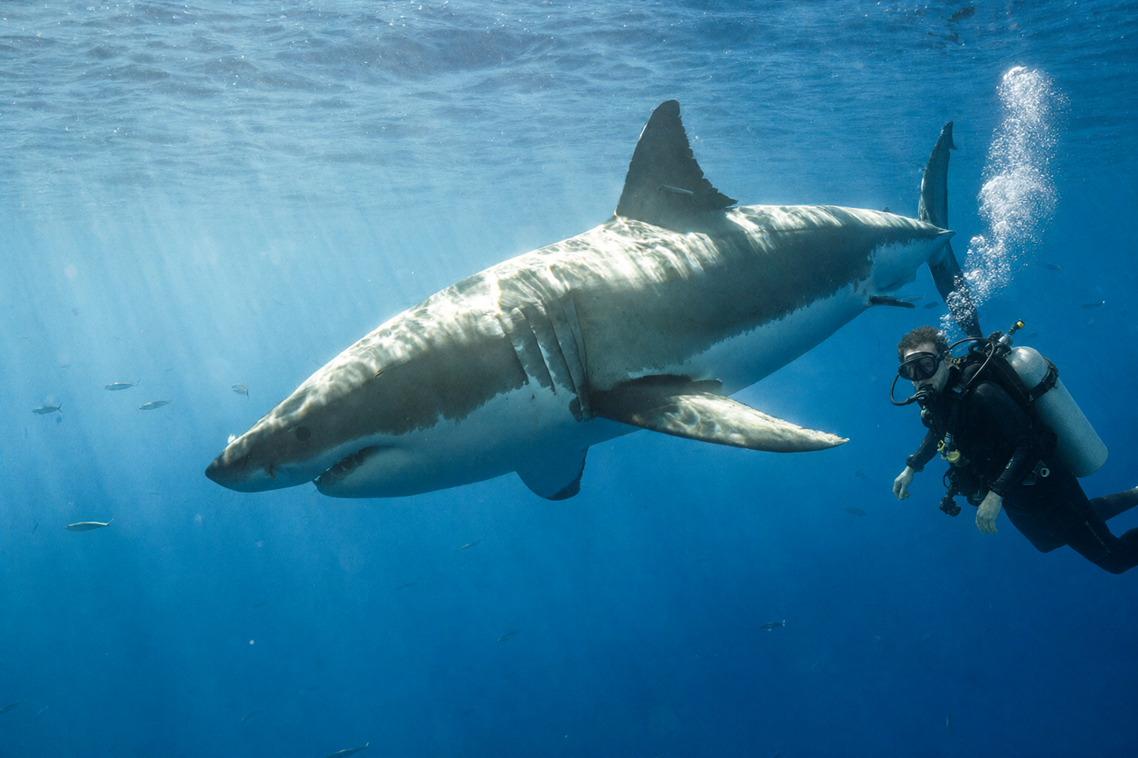
作例18:ダイバーを追加した海中シーン。 水中の光とスケールを合わせた合成。
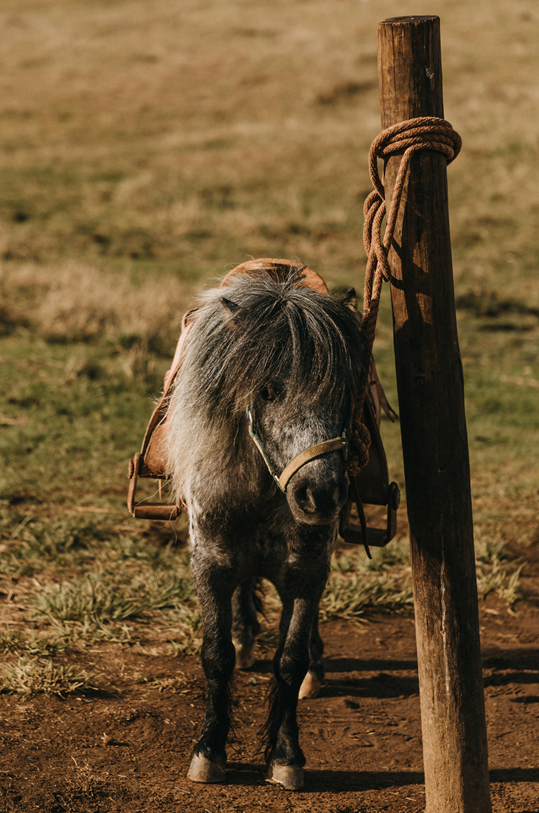
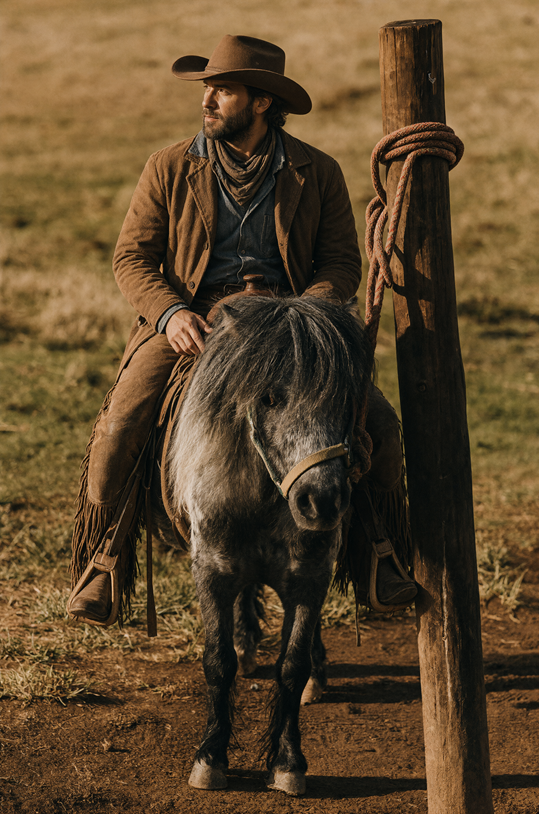
作例19:ロバに乗る人物の元画像。 マスク編集の基準となる写真。
作例20:人物とロバを示すマスク。 変更領域を白黒で明示する別方式。
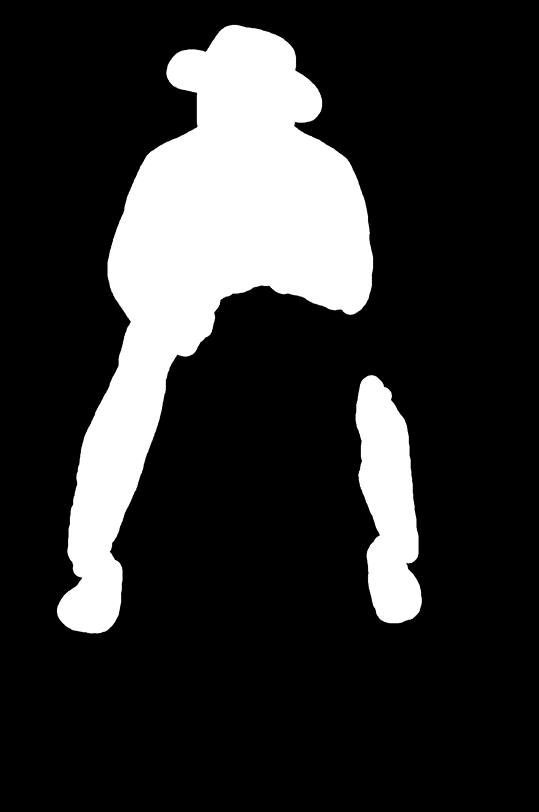
人物の再配置と顔の保持
作例21:マスクを使った人物編集の結果。 背景の草原との整合性も比較できる。
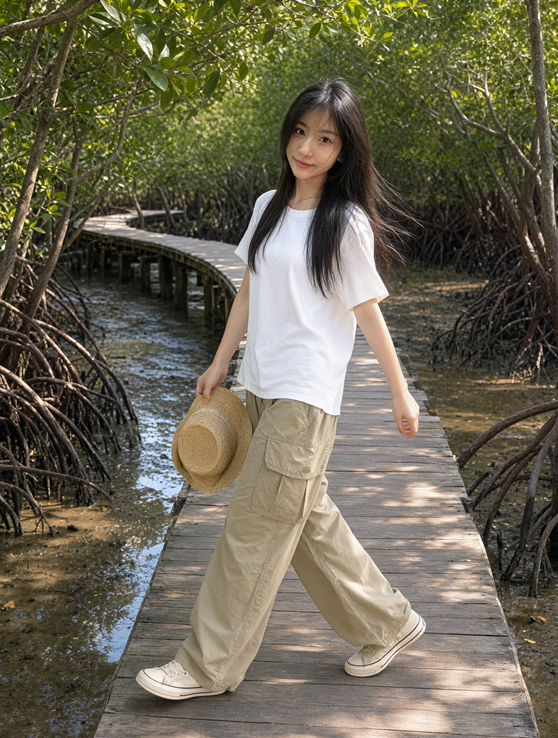
作例22:顔参照用のポートレート。 次の全身・新環境生成に使う基準画像。
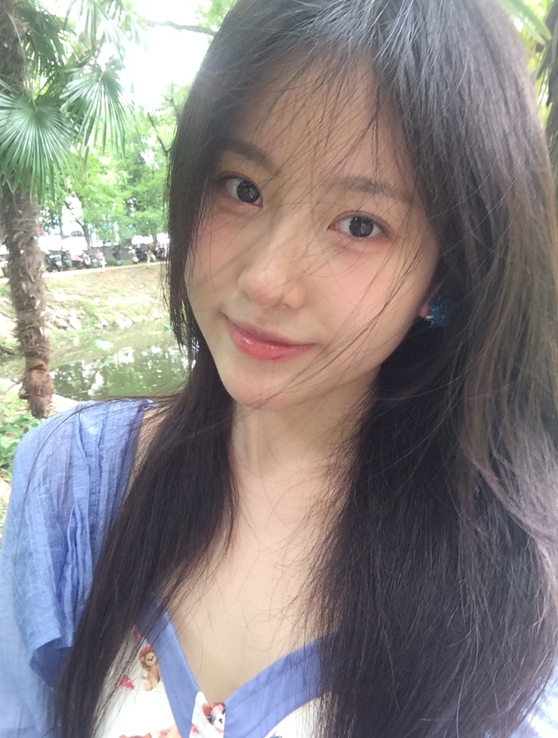
作例23:参照人物を屋外の全身写真へ展開。 顔と服装を新しい構図へ移す。
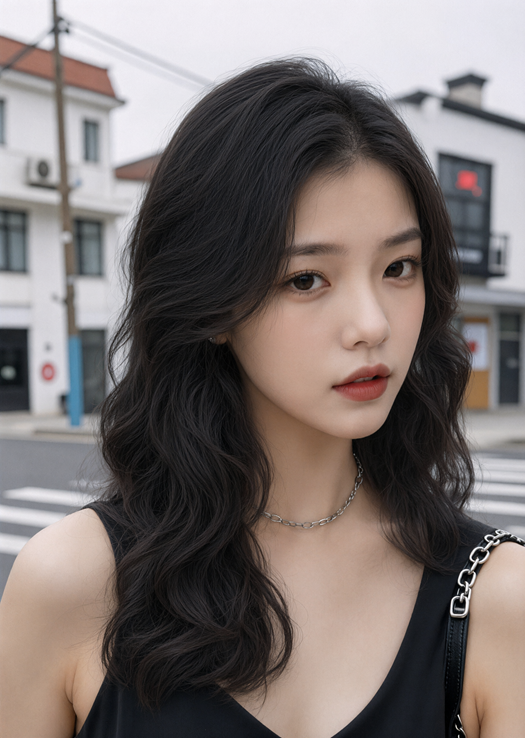
作例24:正面寄りの顔写真。 髪型編集の入力条件。
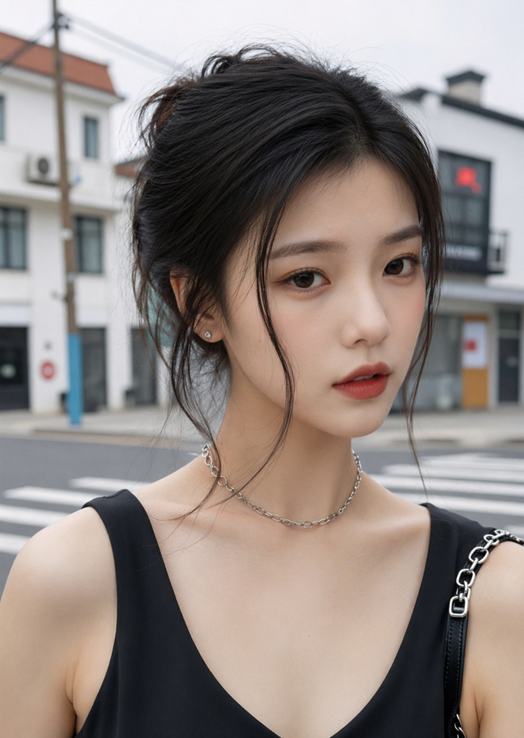
作例25:髪型を変更した顔写真。 顔立ちや背景を保ち、髪だけを長くする。
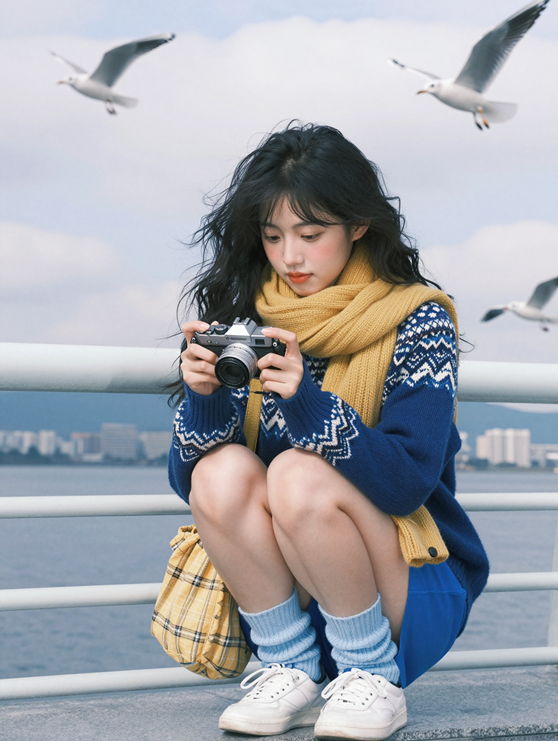
ポーズ・場面・商品写真
作例26:港でしゃがむ人物。 複雑な姿勢、小物、遠景を含む例。
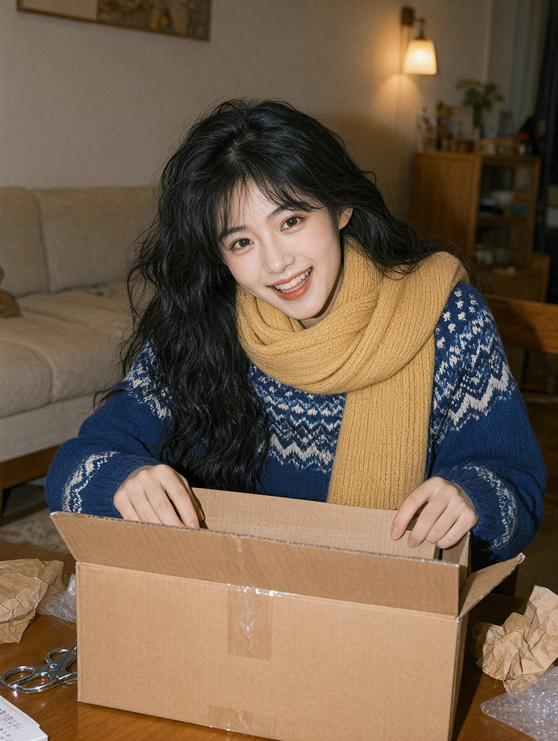
作例27:室内で箱を開ける人物。 手指、箱、身体の重なりを見る構図。
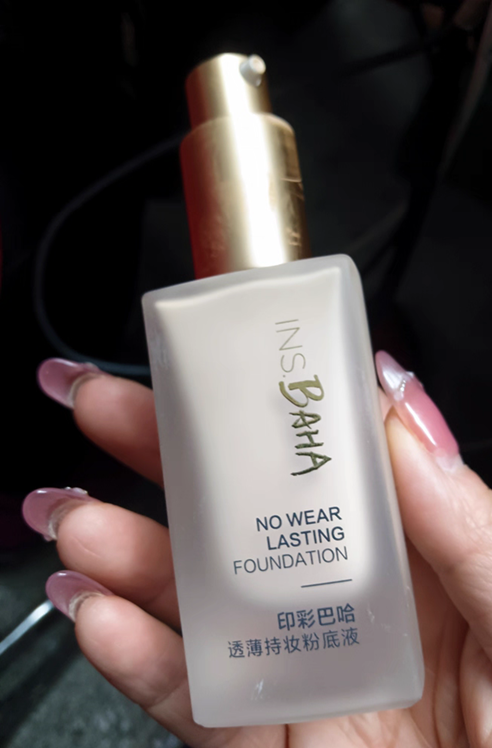
作例28:手に持った化粧品。 ラベル文字と指の接触を含む商品写真。
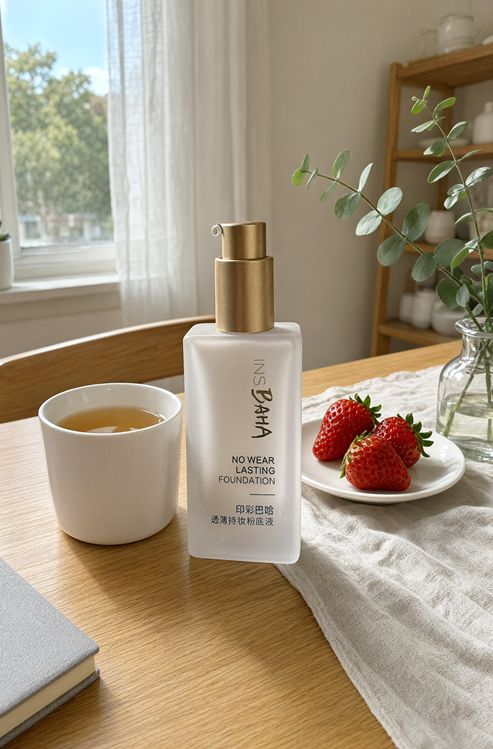
作例29:化粧品を室内の商品カットへ変更。 自然光、テーブル、食品小物を追加。
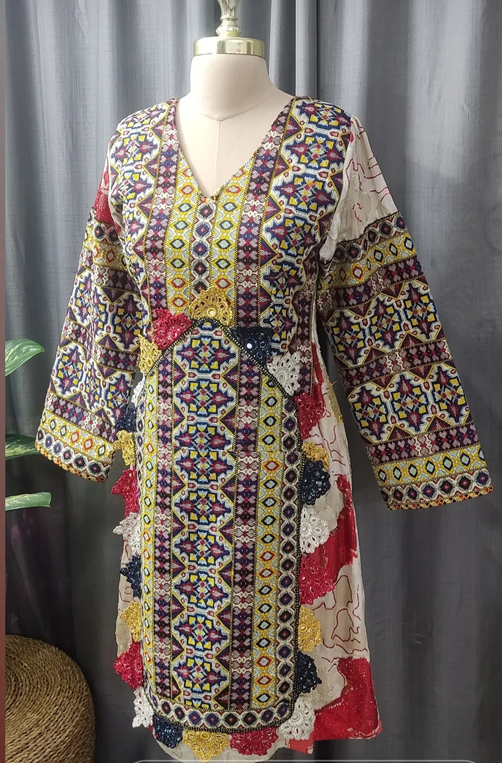
作例30:マネキンに着せた衣服。 次の人物試着生成に使う商品参照。
バーチャル試着と装着合成
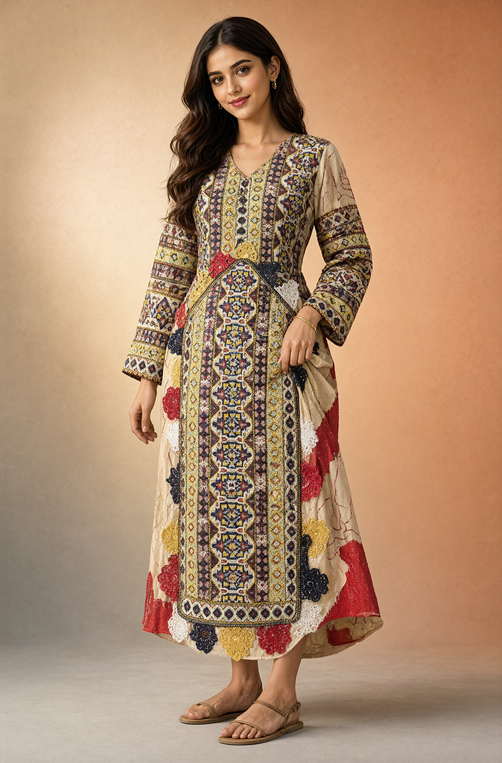
作例31:参照衣服を人物へ着せる。 柄、丈、シルエットを人体へ合わせている。
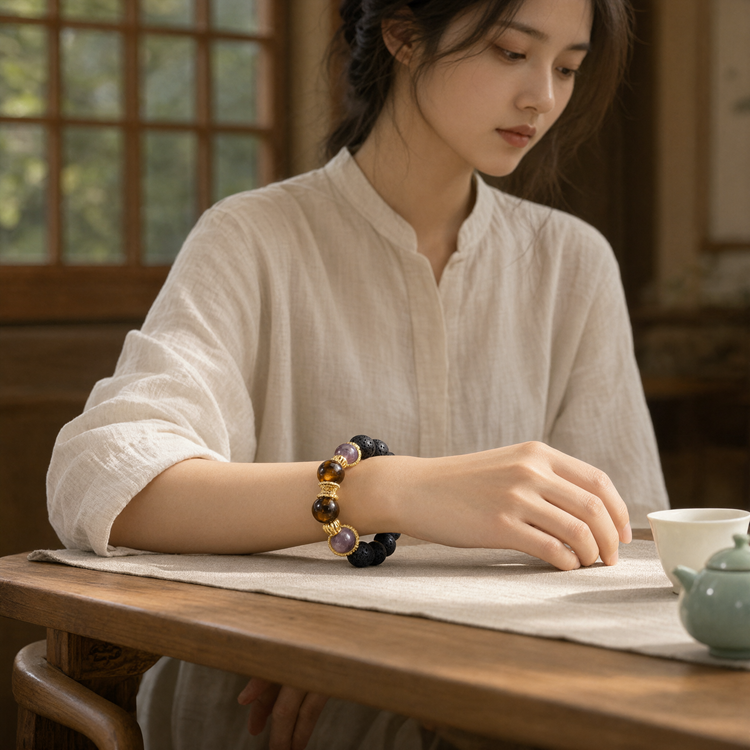
作例32:ブレスレット単体の商品写真。 装着合成の条件画像。
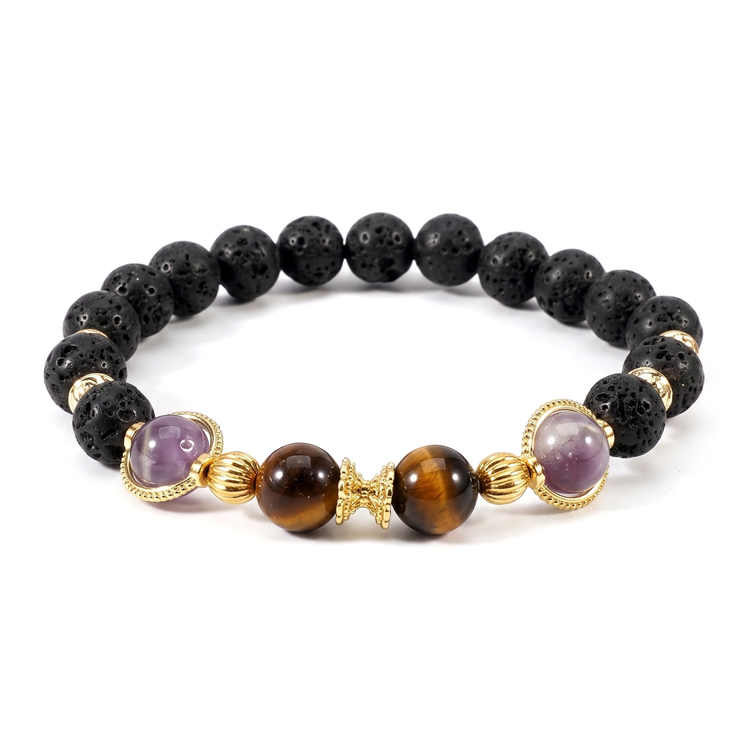
作例33:ブレスレットを人物の手首へ装着。 肌への接触と影を自然に合わせる。
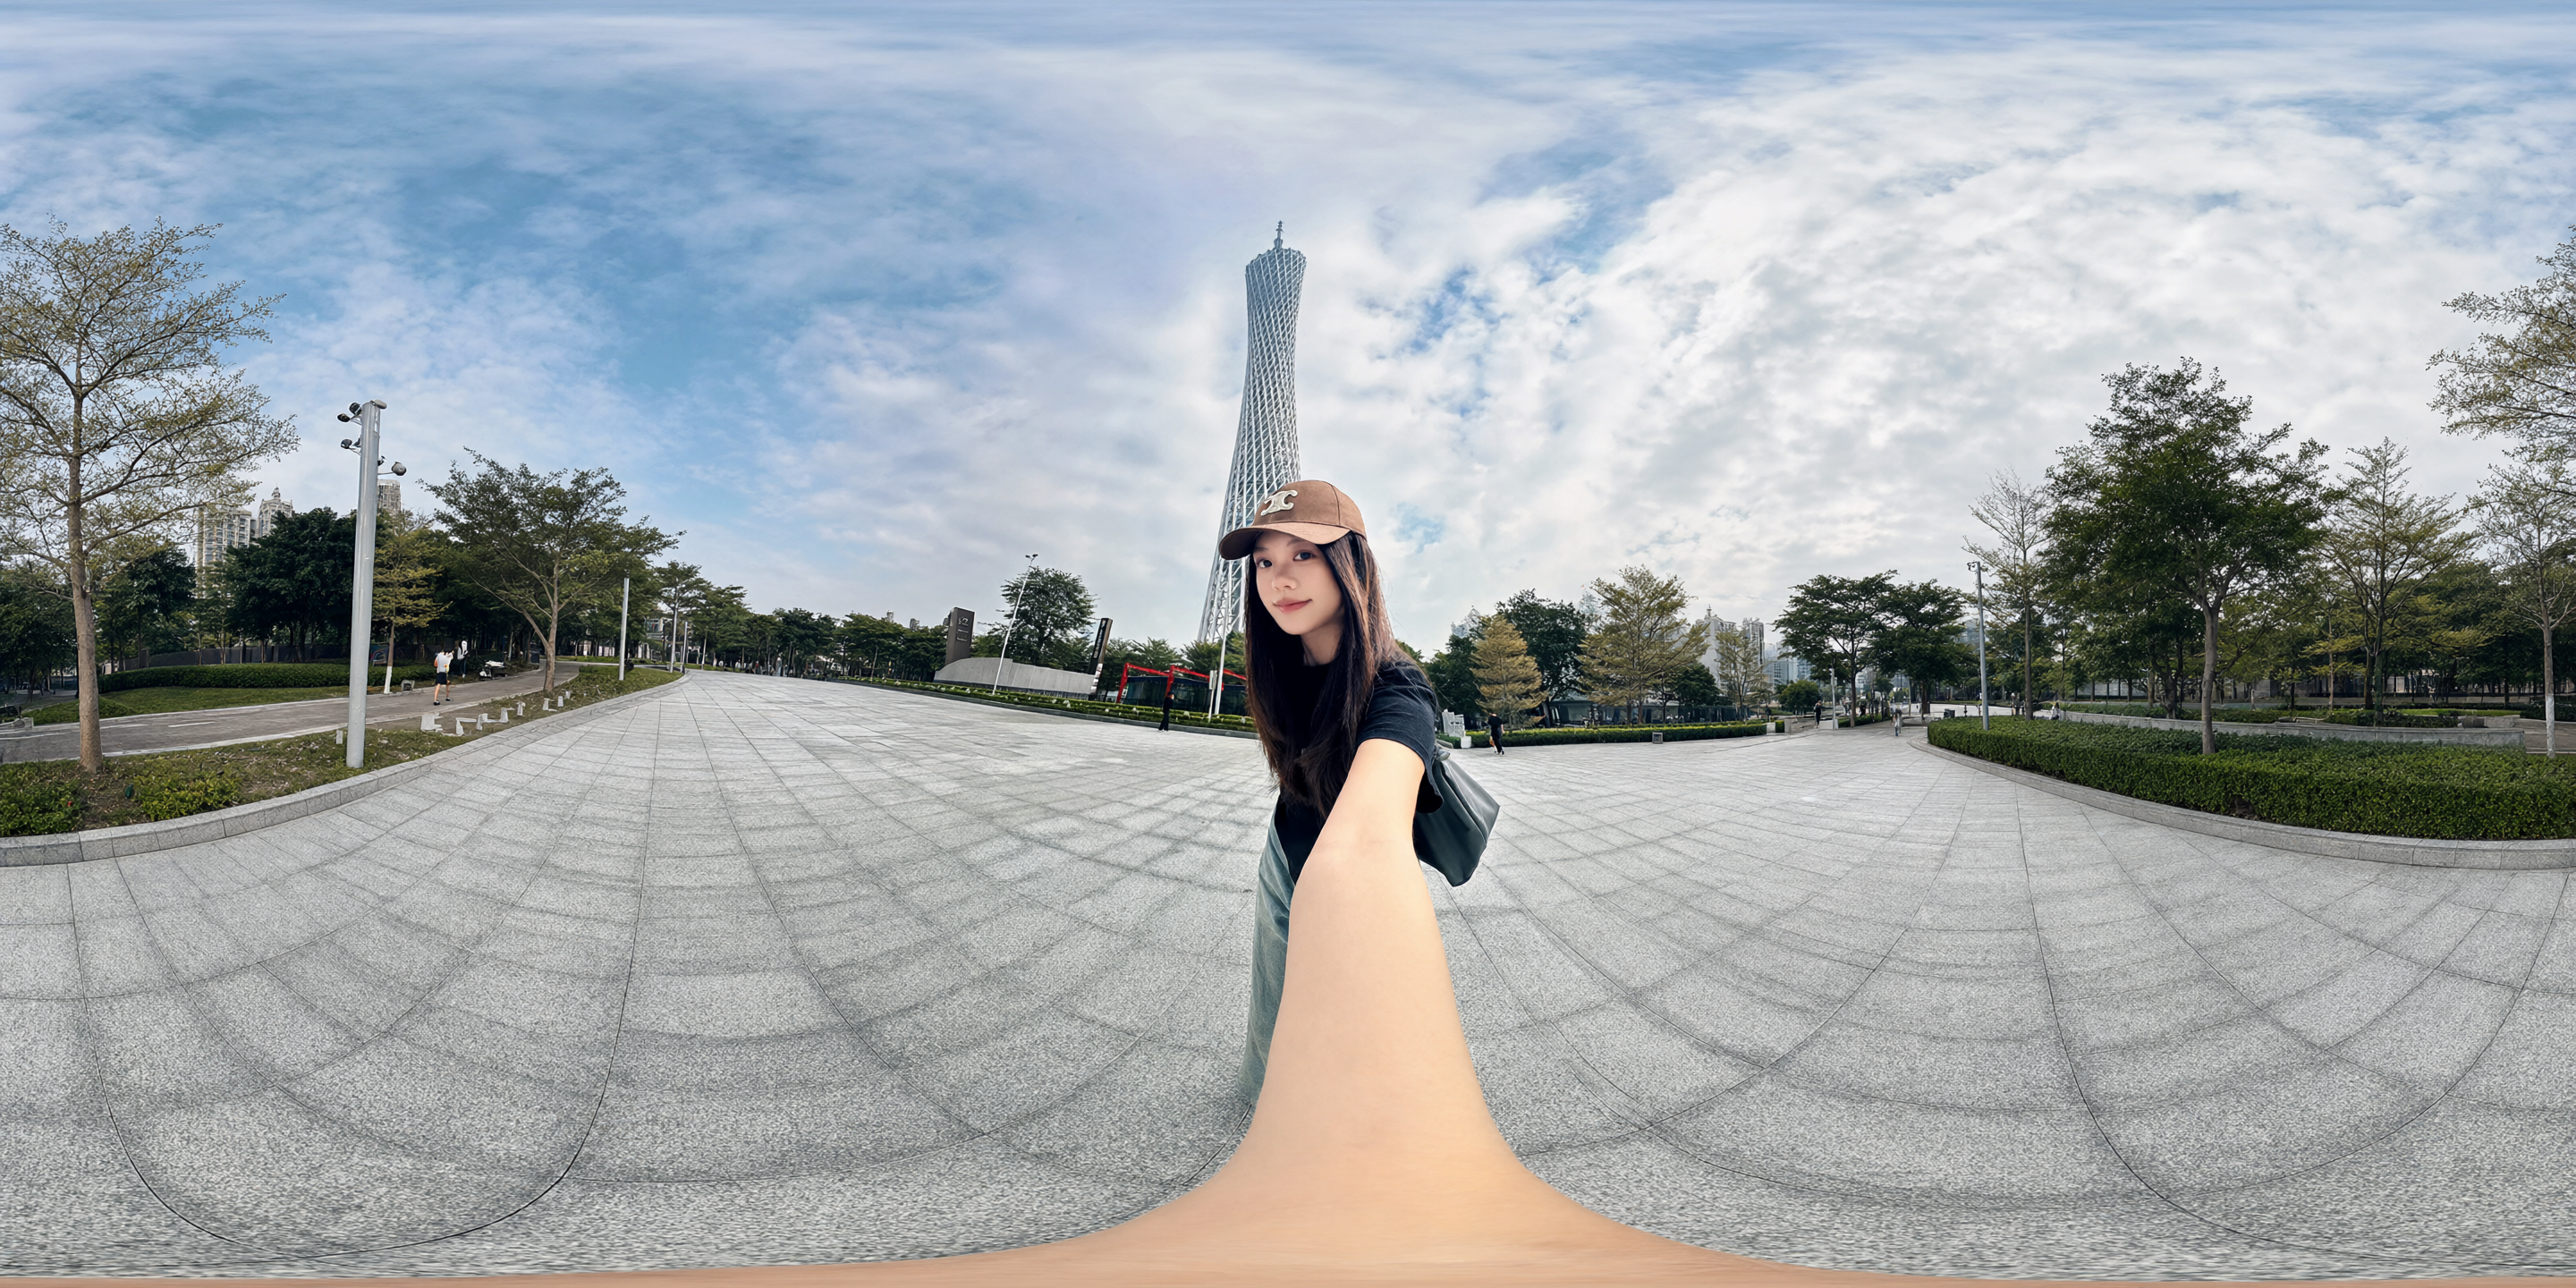
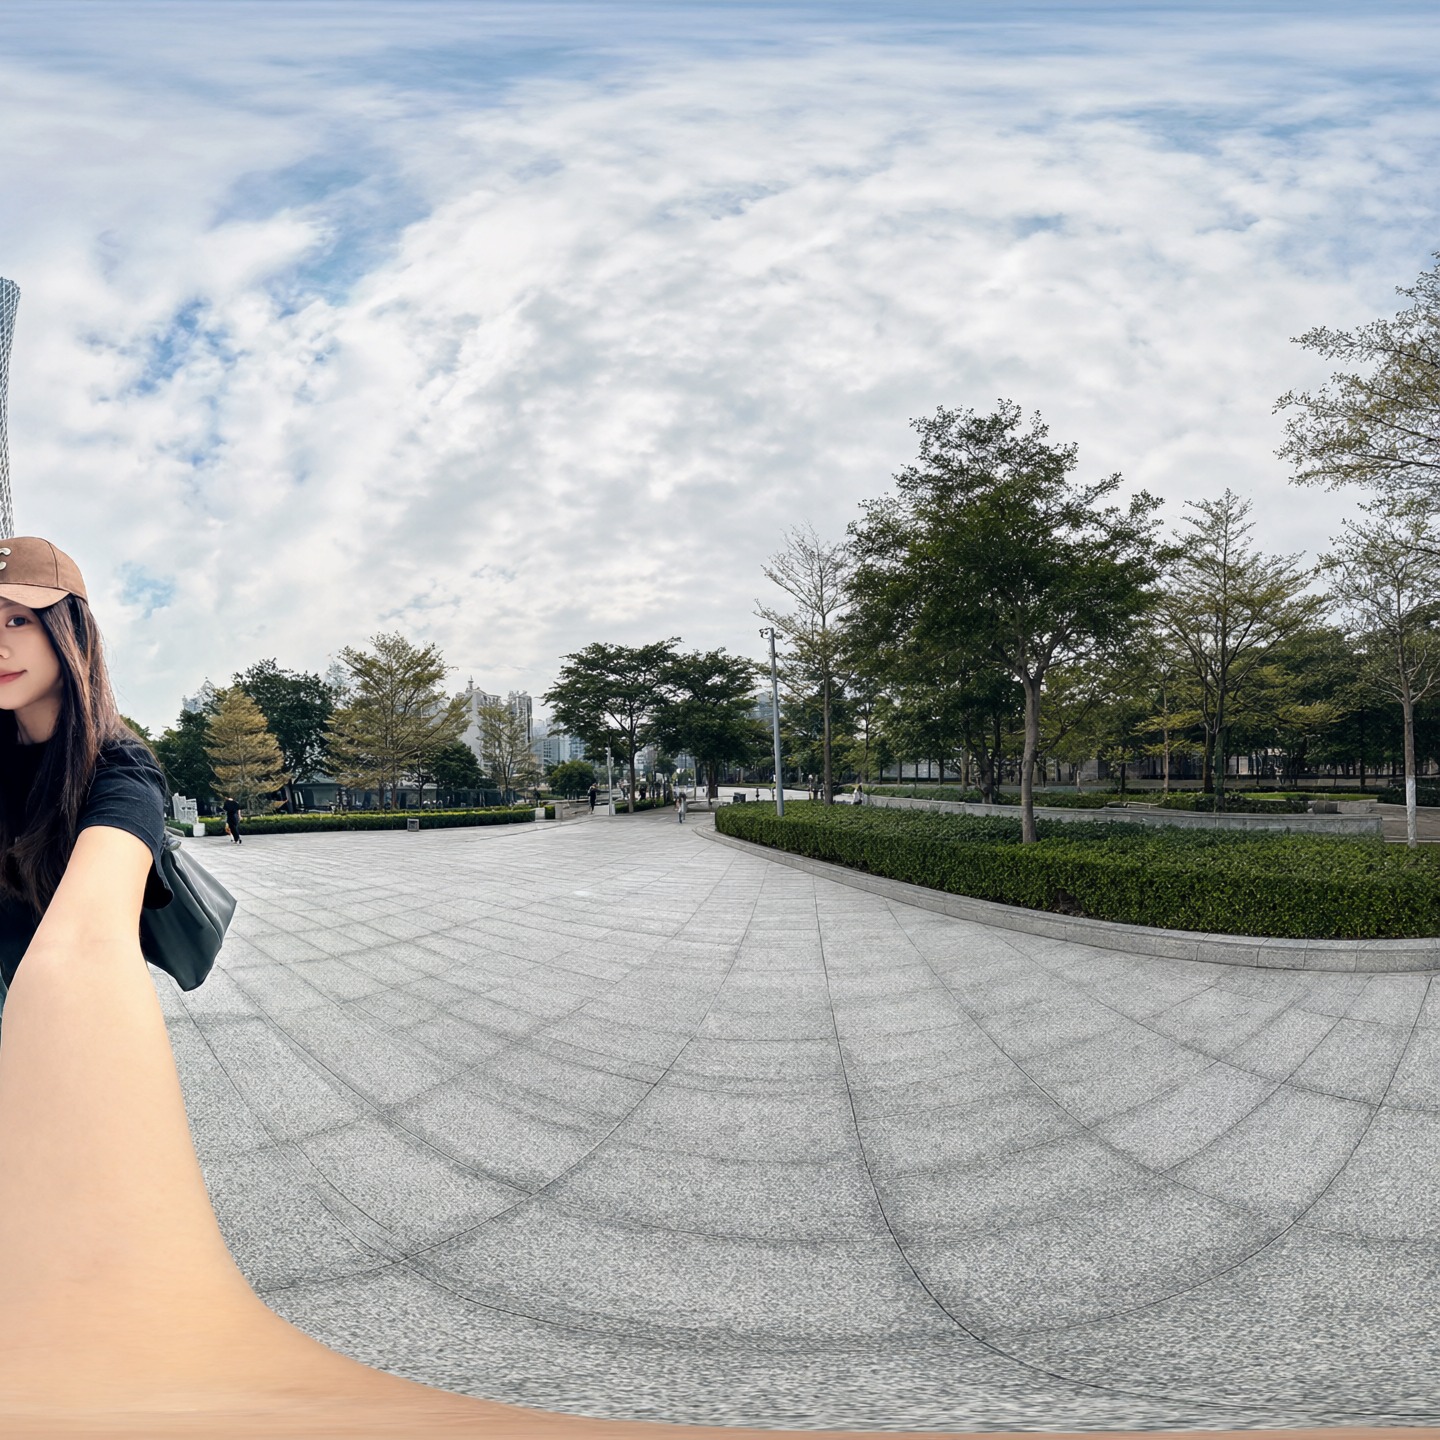
作例34:タワー前のセルフィー。 視点変更に使う入力写真。
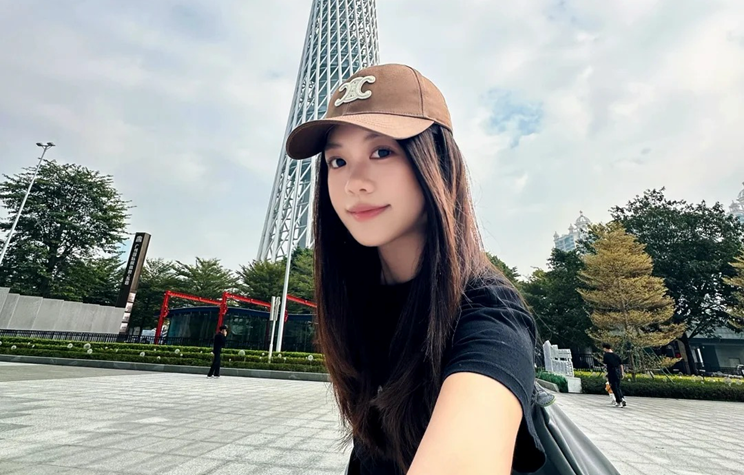
作例35:セルフィーから第三者視点へ。 同じ人物と場所を広い画角へ再構成する。
キャラクターシートと連続性
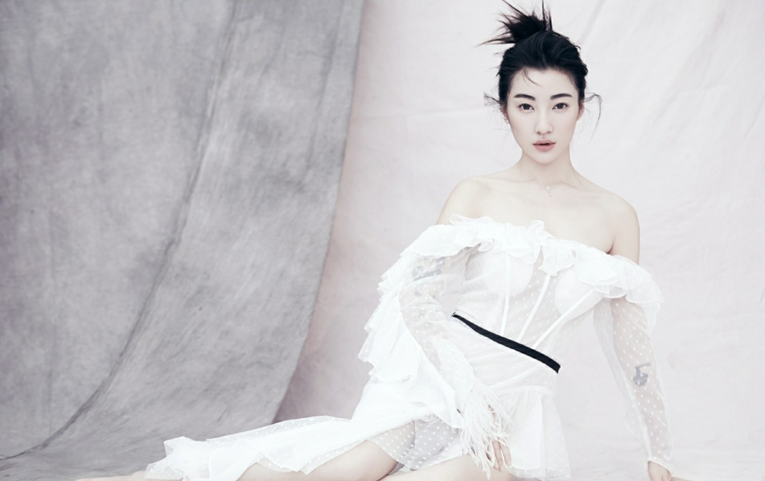
作例36:白い衣装の人物ポートレート。 キャラクター設定資料の入力。
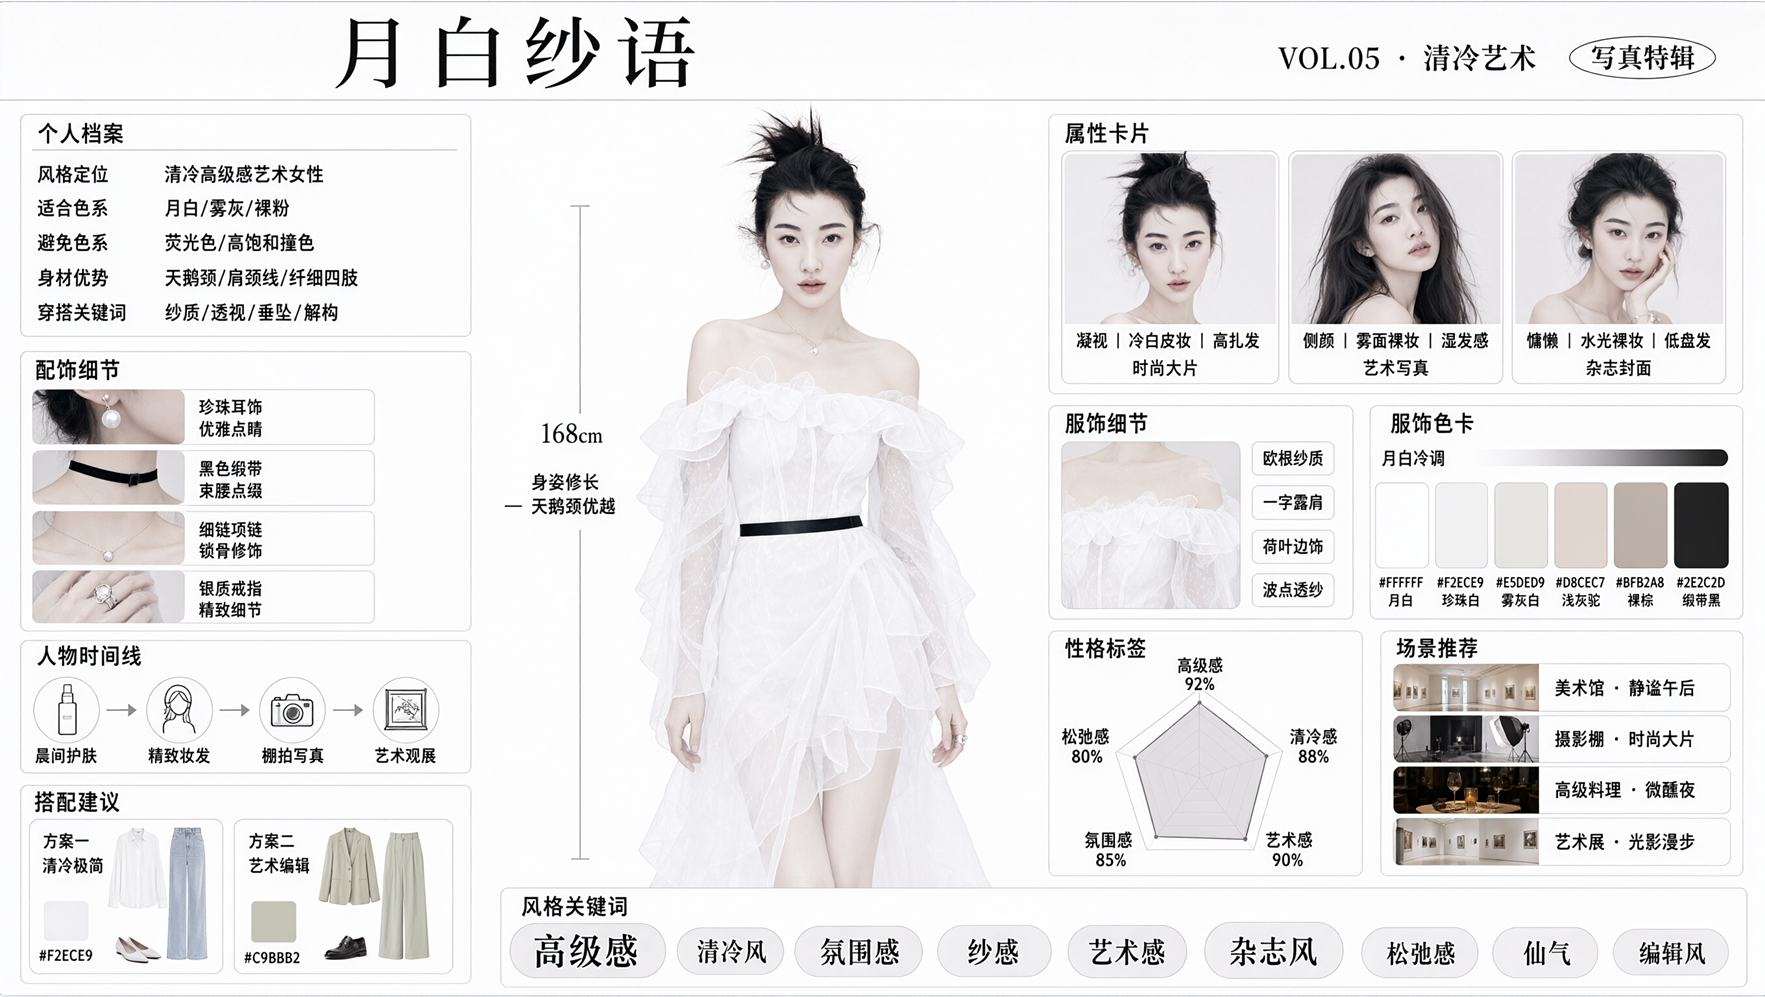
作例37:人物設定を一枚にまとめたデザインシート。 顔、服、小物、文字情報を統合。
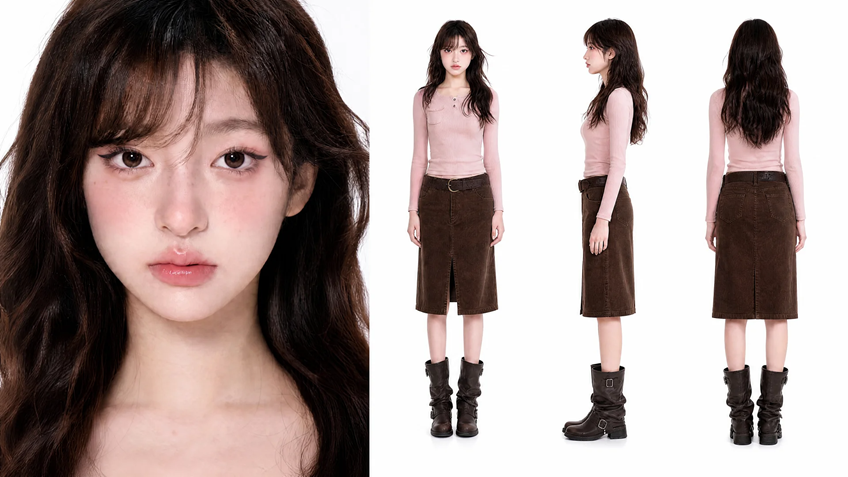
作例38:正面・側面・背面を含むキャラクターシート。 動画や漫画の参照素材向け。
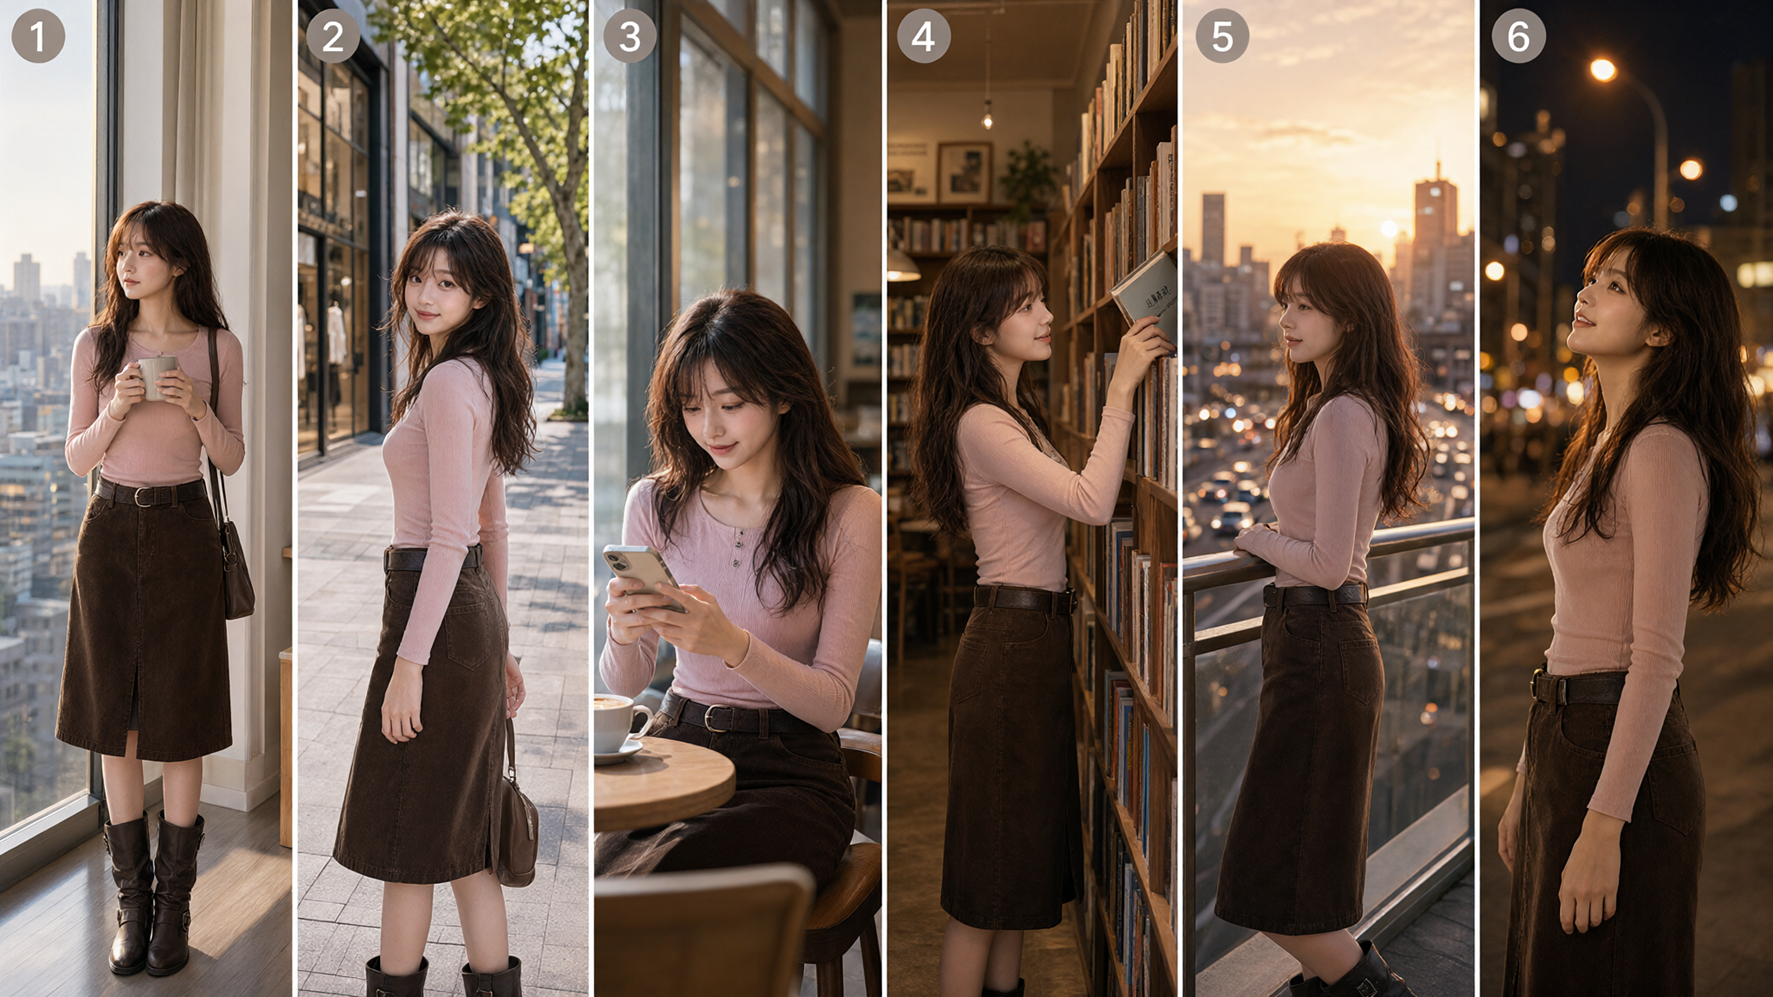
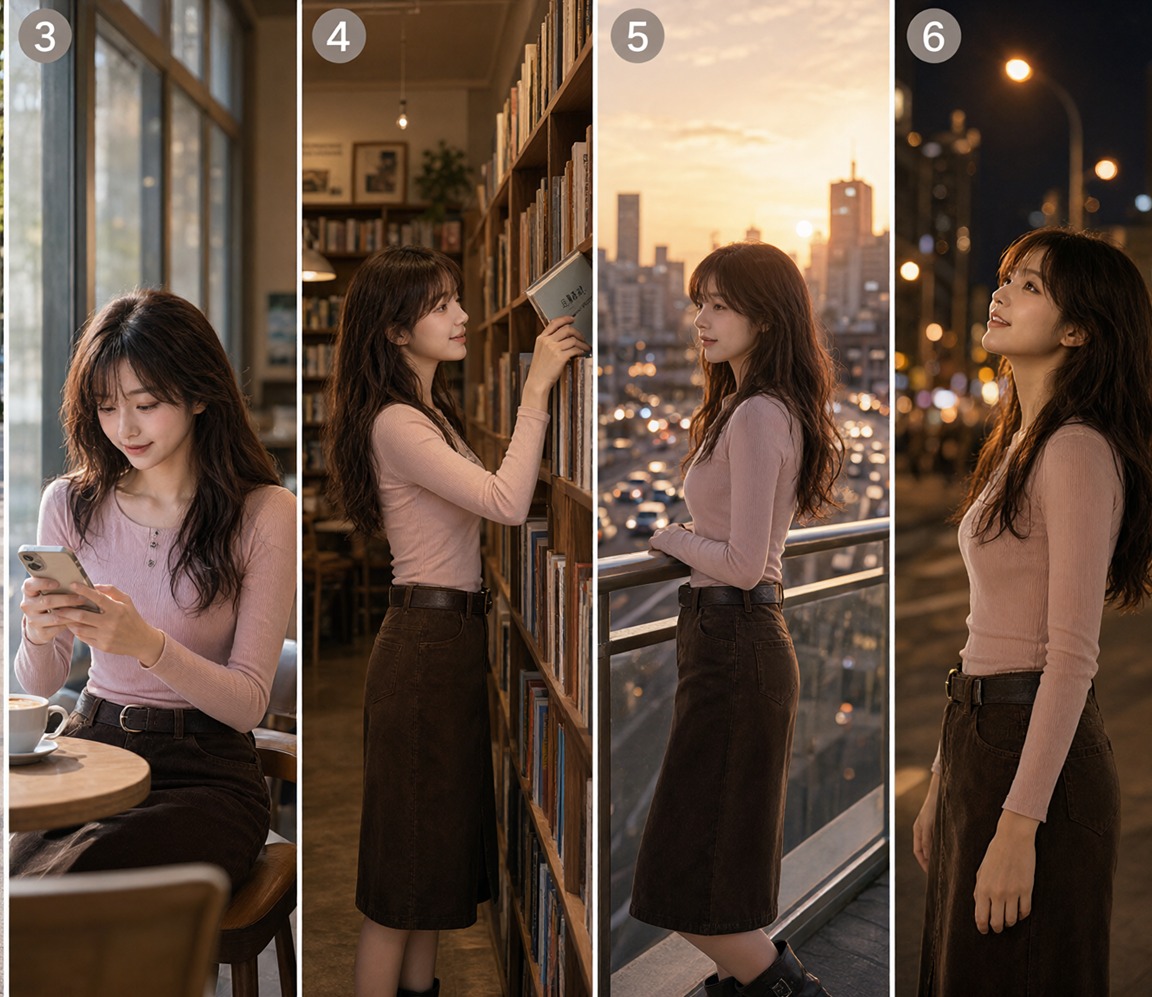
作例39:同一人物を複数シーンへ配置。 姿勢や場所を変えたときの顔と服の保持を見る。
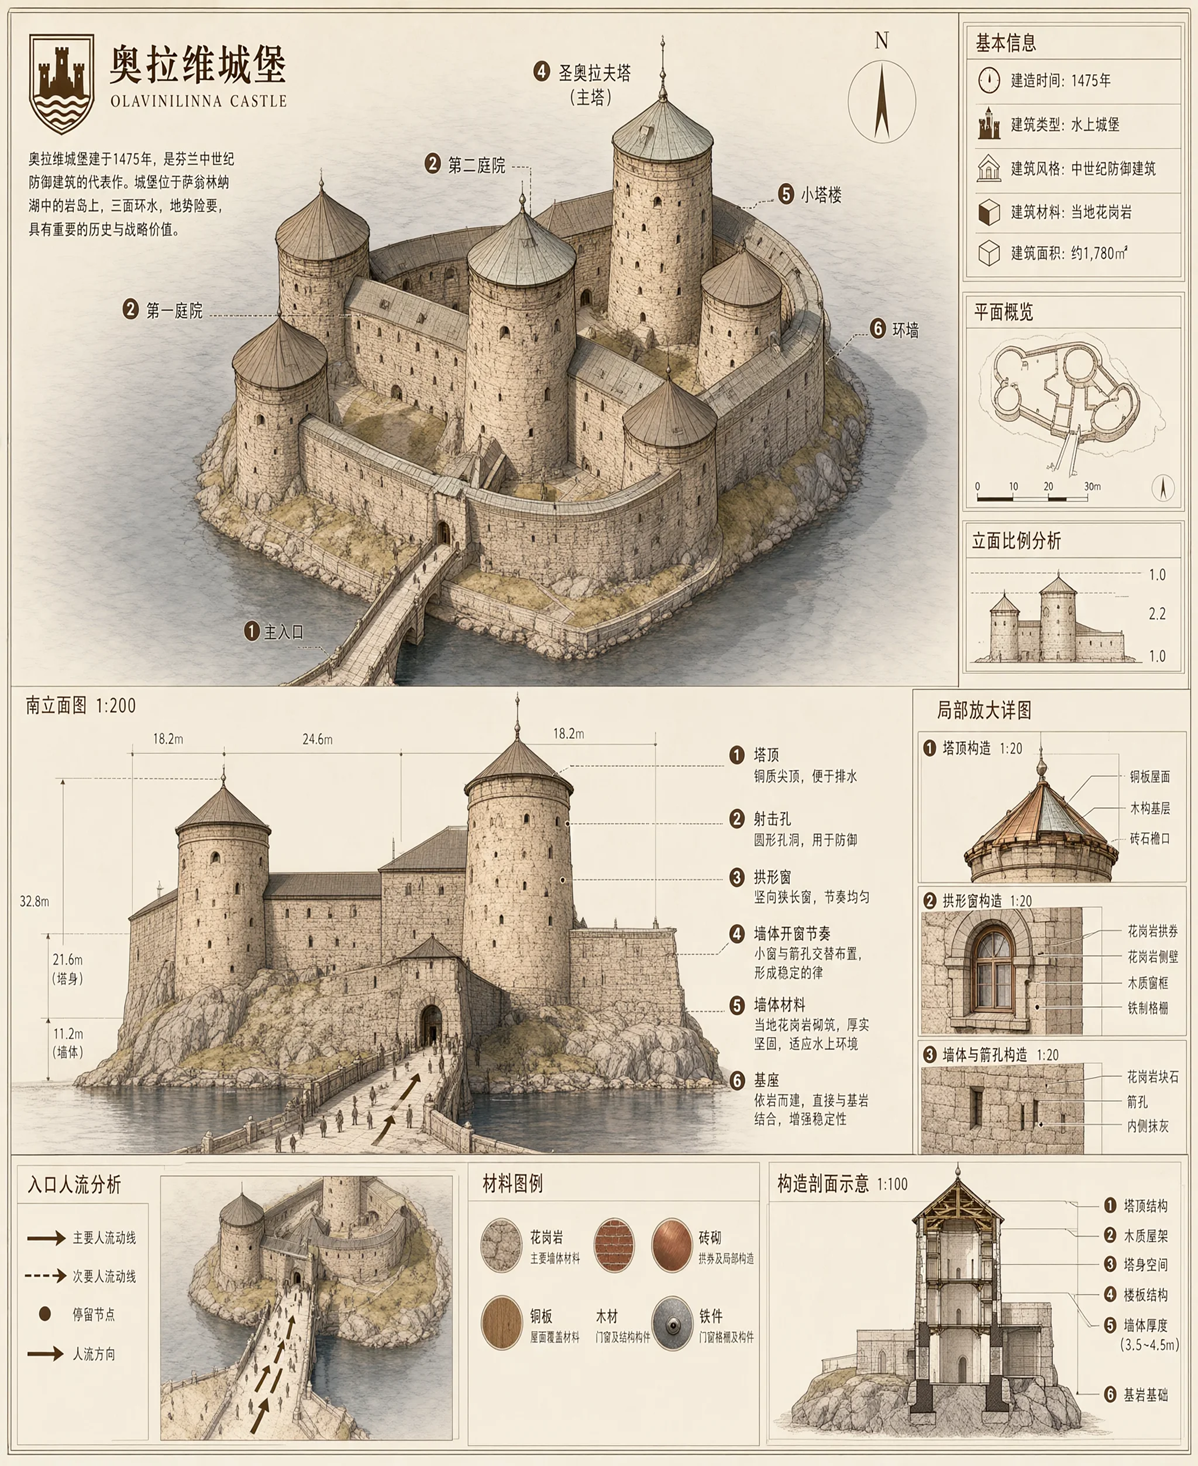
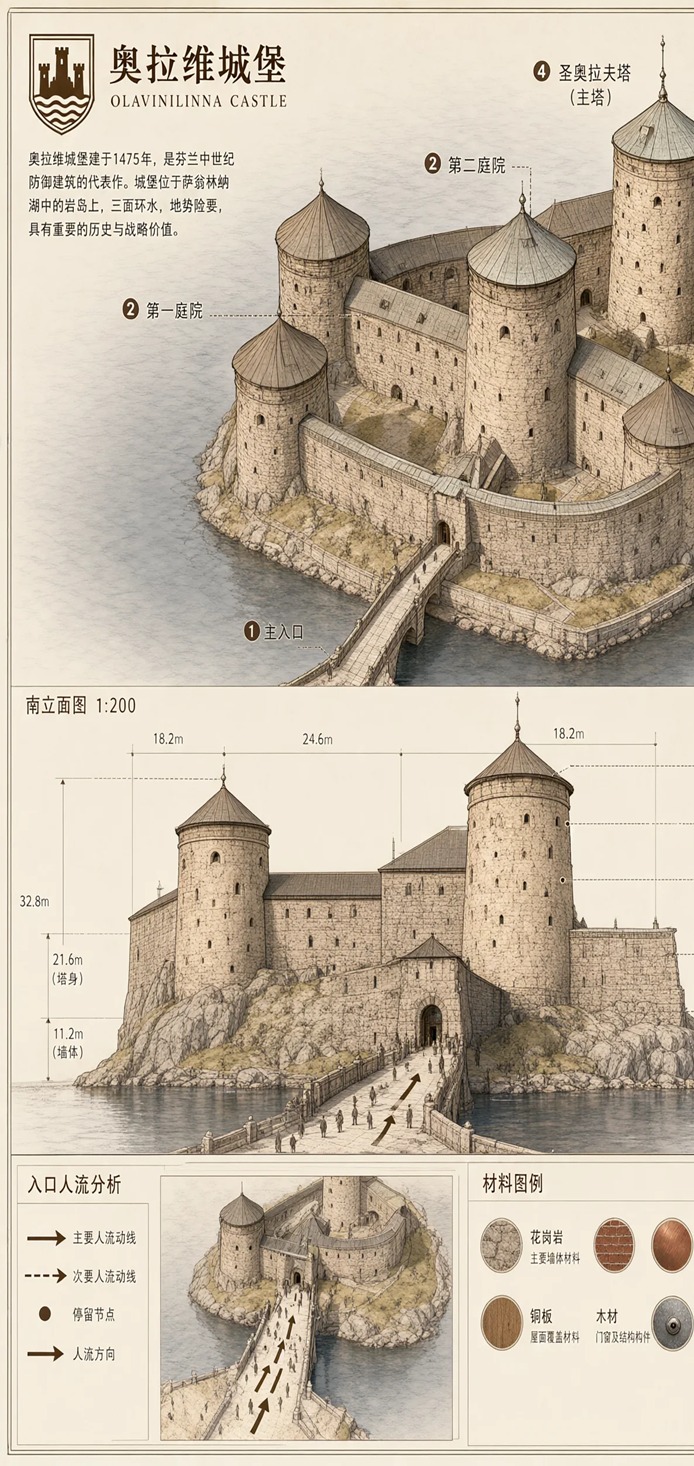
作例40:建築物の説明図。 文字、図面、素材見本、注釈を一枚へ統合する資料生成。
UI・文書・自然な人物写真
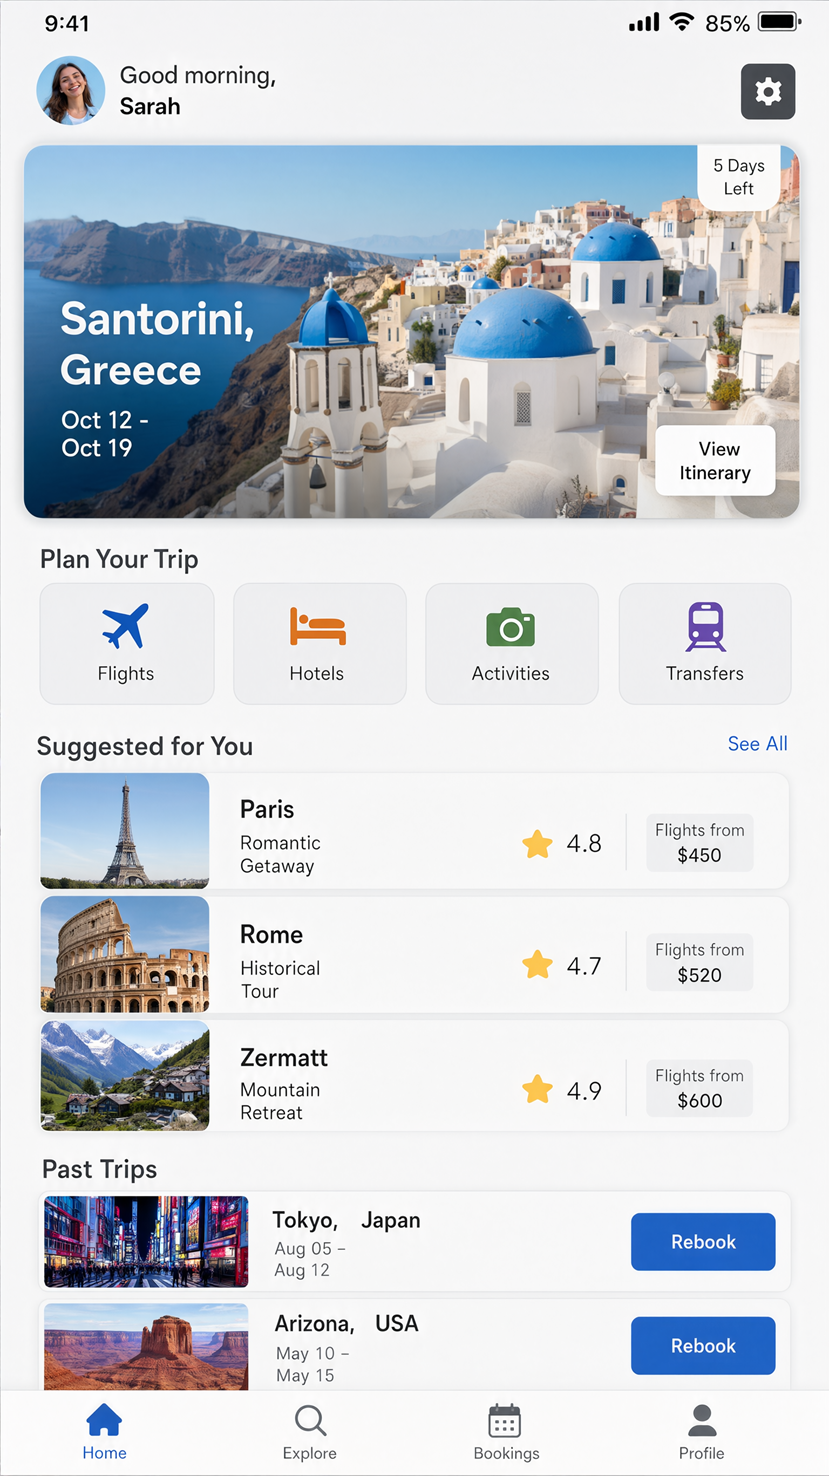
作例41:旅行予約アプリのUI。 小さな文字、カード、写真、ボタンを含む画面設計。
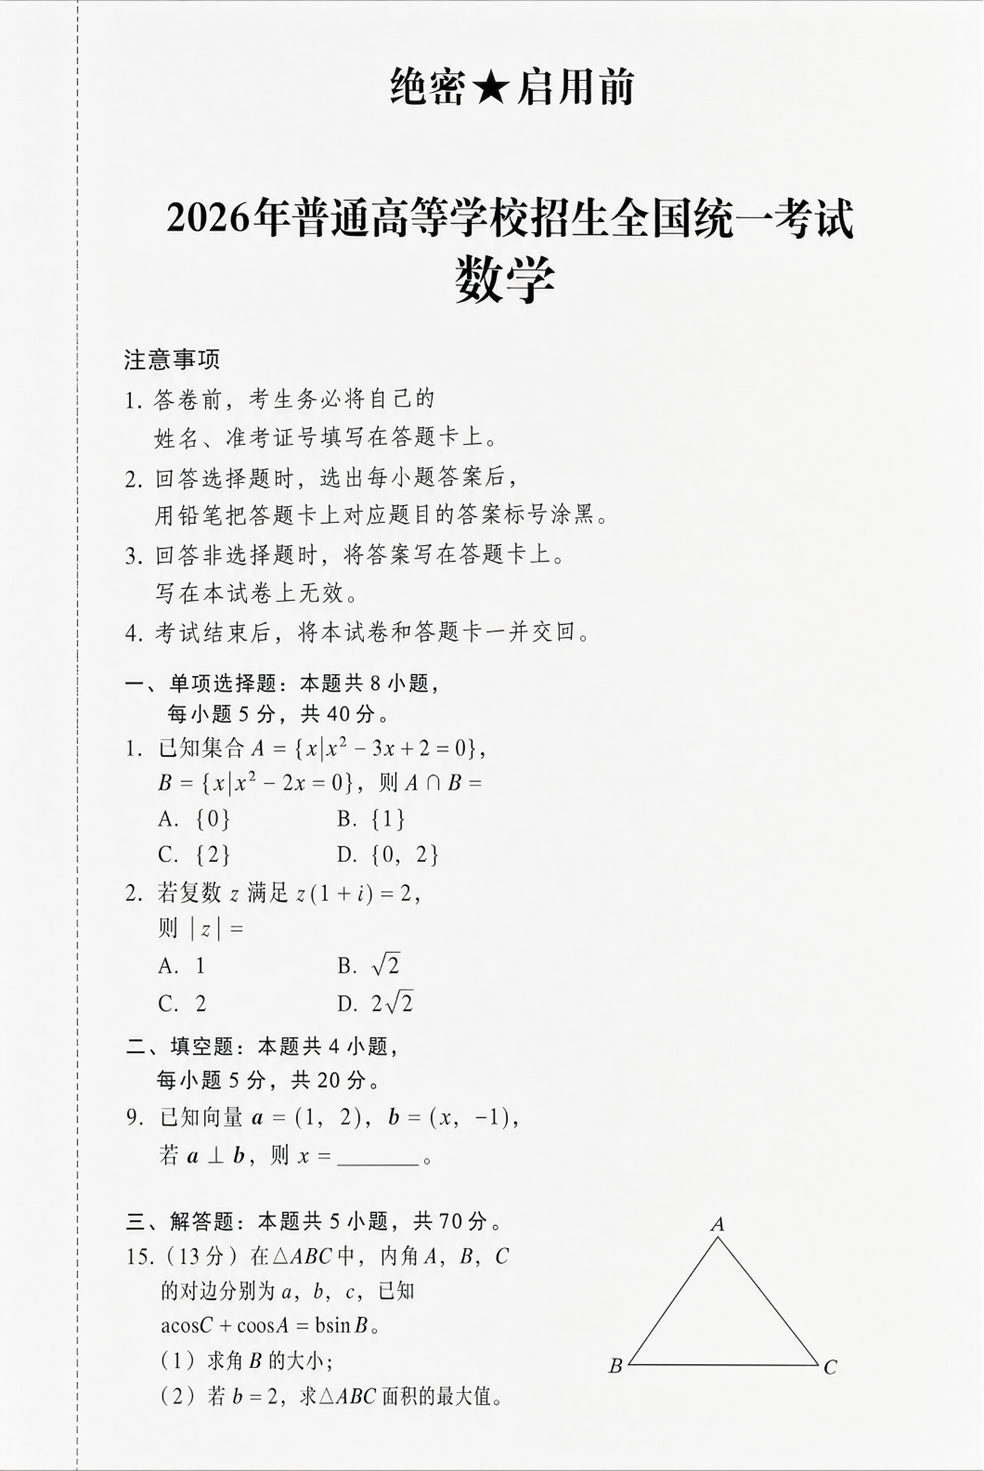
作例42:幾何学問題を含む文書。 長文と図形を含むページ生成の難しさを見る。
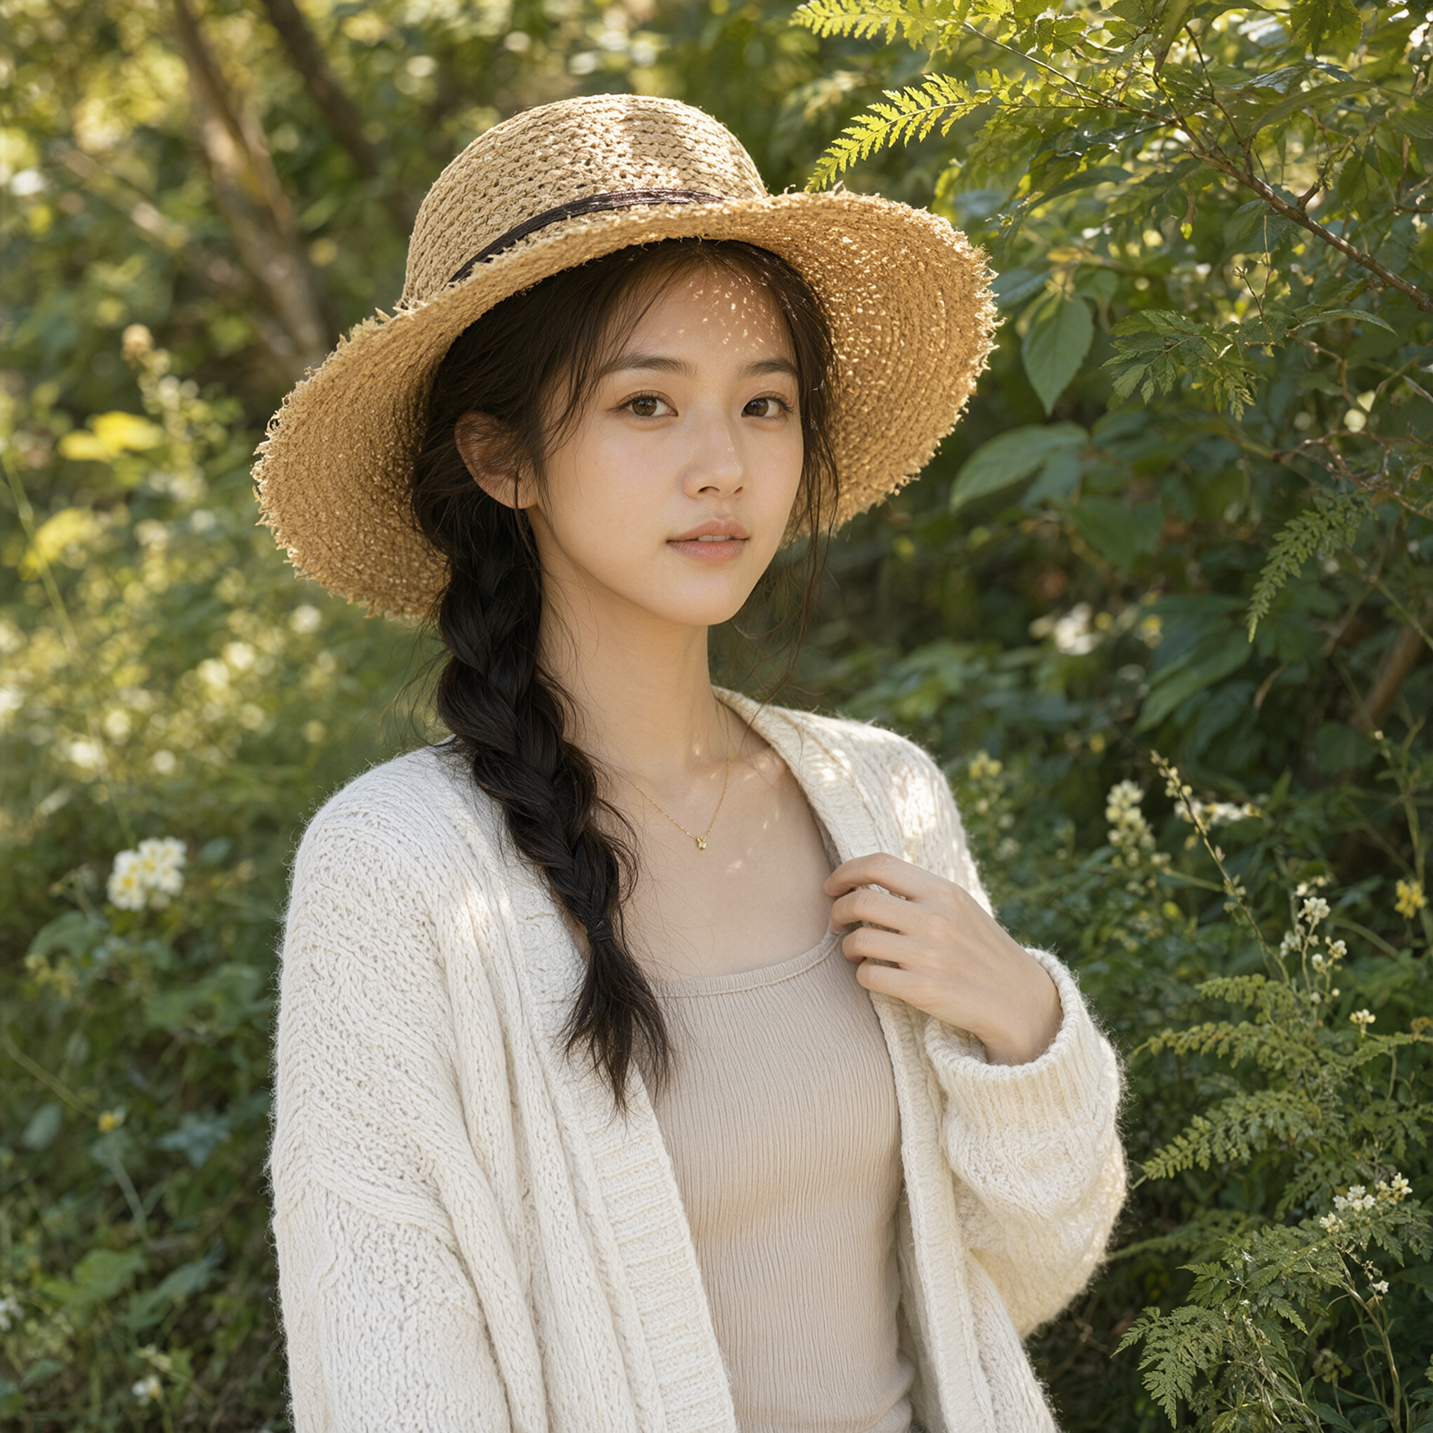
作例43:屋外の自然光ポートレート。 帽子、髪、木漏れ日の表現。
作例44:マリーナの人物写真。 ロープ、船、工具など細かな背景を含む写実例。
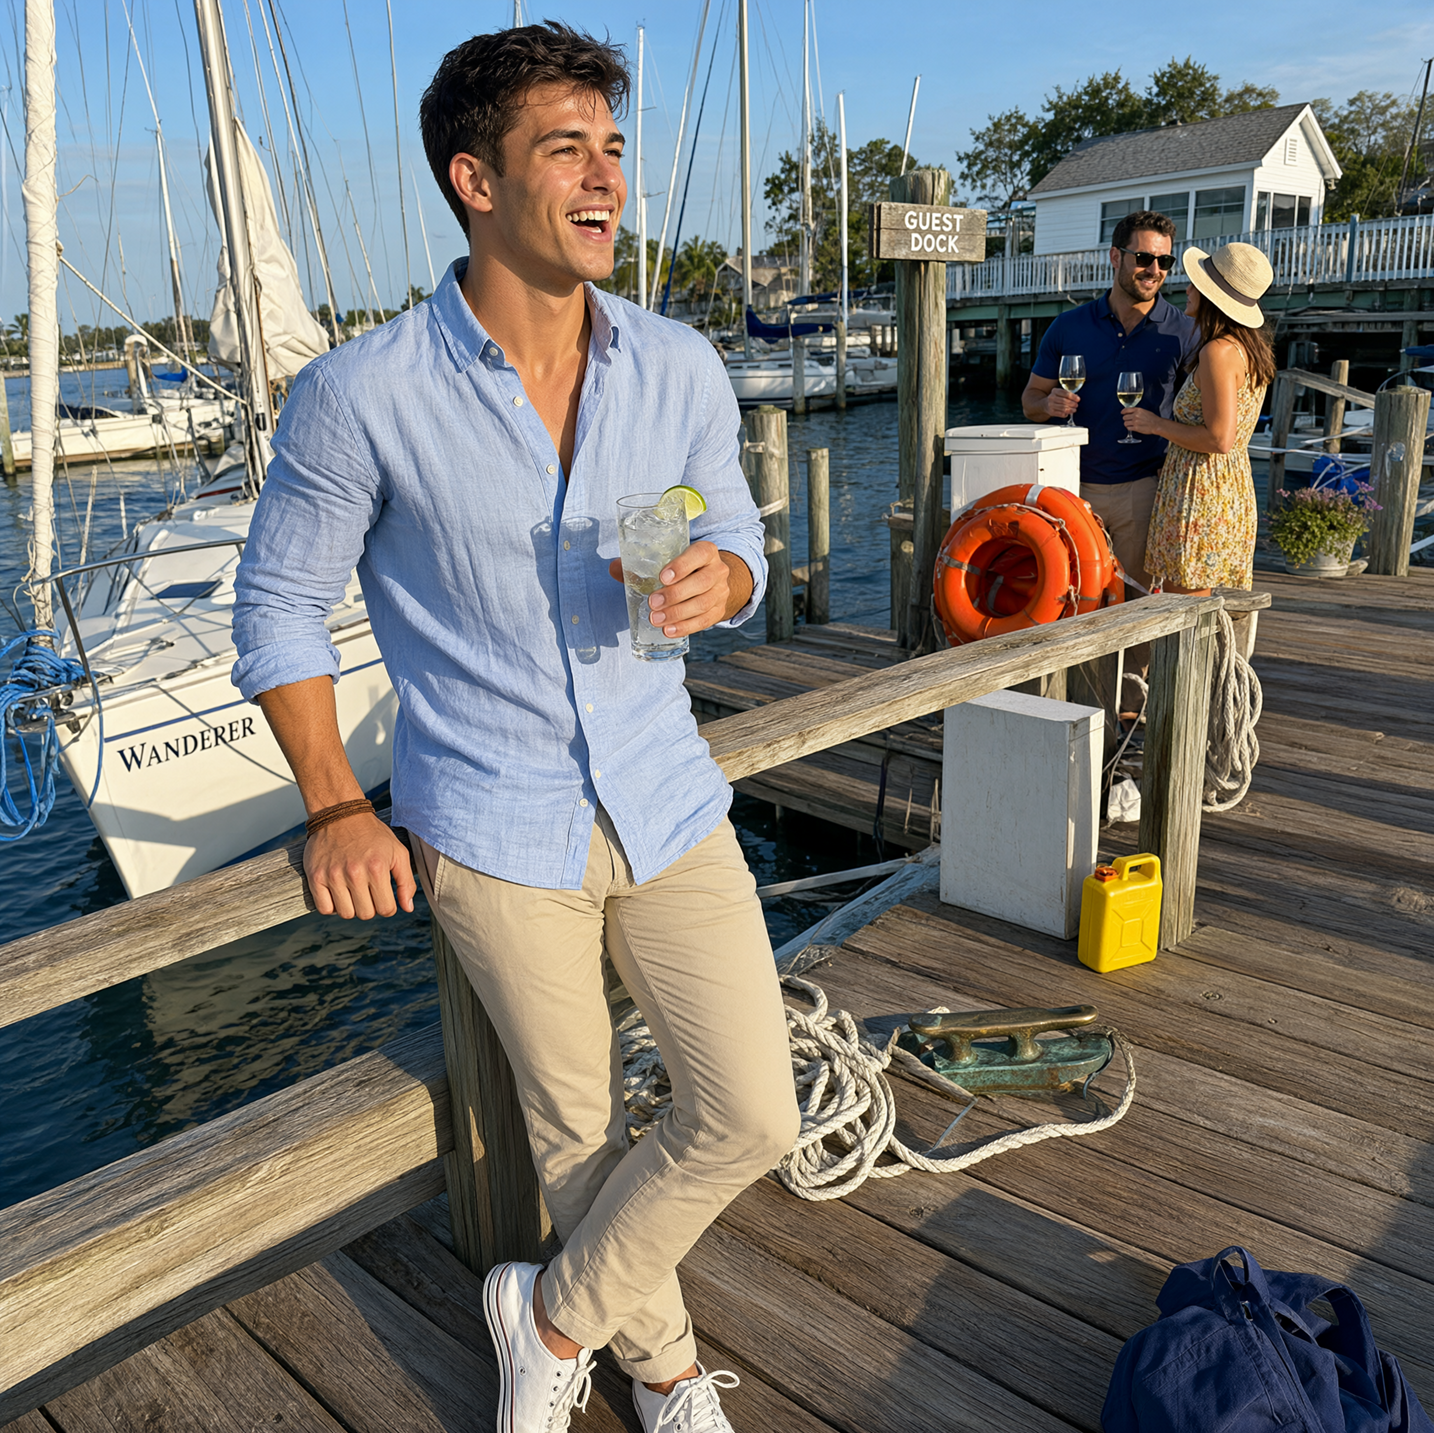
比較しやすい拡大・別視点
作例45:集合写真の結果部分を拡大。 複数参照を一つの空間へまとめた際の顔、姿勢、照明を確認する。
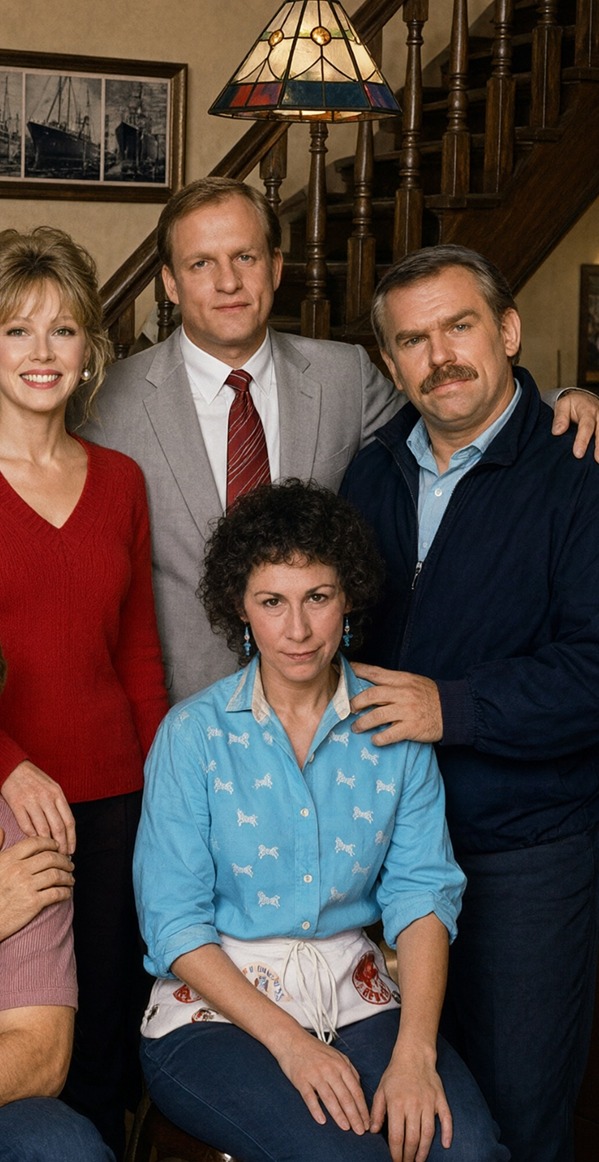
作例46:家具統合後の室内を拡大。 個別の商品参照から部屋全体の遠近と光を作る。
作例47:カメラ視点変更後の正方形クロップ。 背景の塔と人物のスケール関係を見やすくした。
作例48:キャラクターデザインシートの拡大。 顔差分、文字、小物の局所品質を確認できる。
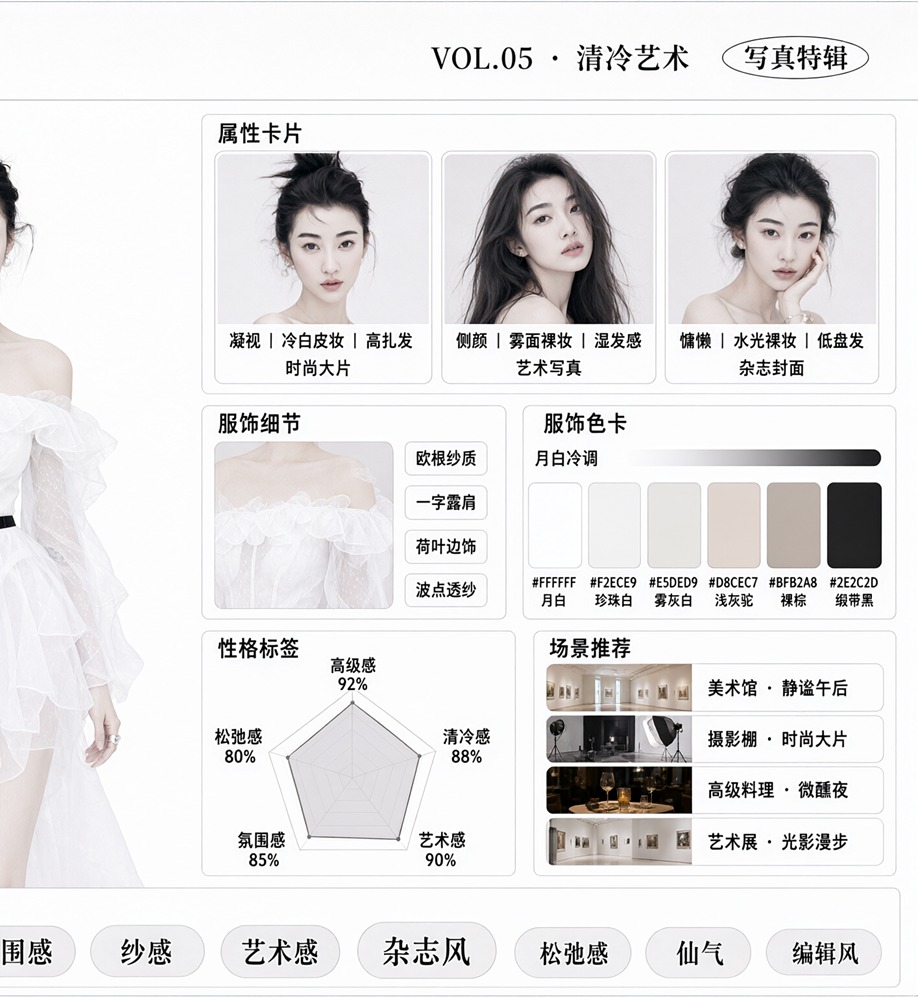
作例49:同一人物を複数シーンへ展開した部分の拡大。 長い制作で重要な服装と顔の一貫性を見る。
作例50:建築インフォグラフィックの拡大。 線画、素材、注釈、余白設計の複合課題を示す。
画像出典:Qwen Team「Qwen-Image-2.1」公式サンプル。拡大表示6点は比較説明のための編集クロップ。
Redditで話題になった作例・検証100選
以下は、Redditの主要なQwen-Image 2.1投稿から、実際に話題になった作画・編集の型を100項目に整理したもの。投稿者の主観や環境差を含むため、ベンチマークではなく「何を試すとモデルの性格が見えるか」という実践カタログとして読んでほしい。
A. 人物写真とポートレート(1~10)
- スマートフォンで撮ったようなアマチュア女性写真。
- スーパーの売り場で撮影した日常ポートレート。
- 映画的な逆光を使った人物写真。
- 夜景を背景にした人物の再照明。
- 雨天の夜へ天候と時間帯を同時変更。
- 肌の質感を残したファッション写真。
- 低いカメラ位置からの右側面ショット。
- 正面写真から三四分角度へのカメラ変更。
- 大きな表情変化を伴う顔の再生成。
- 複数照明条件から統合した「基準顔」の生成。
注目元:200枚超の1girlテスト(約1,483票)、初期レビュー
B. キャラクター整合性(11~20)
- 同一キャラクターの正面・側面・背面シート。
- 顔のアップと全身像を一枚にまとめた設定資料。
- 2×2の顔参照から単一の一貫した顔を生成。
- 同じ人物を別の場所へ移して顔を維持。
- 同じ人物で服だけ変更。
- 同じ人物で髪型だけ変更。
- 同じ人物でポーズだけ置換。
- 同じ人物を写実版とコミック版で描き分け。
- 連続カット用の複数ポーズ作成。
- キャラクターシートを動画生成の参照素材に利用。
注目元:キャラクターデザインシート、4方向の顔参照(約157票)、Qwen対FLUX.2 Krea(約116票)
C. ポーズ・カメラ・構図転写(21~30)
- 参照1の人物へ参照2のポーズを移植。
- 座っている人物を別画像の黄色い椅子へ配置。
- 立ち姿を座り姿へ変更しつつ衣装を保持。
- 正面構図を低角度の中景へ変更。
- 被写体サイズを保ったまま画角だけ拡張。
- ポーズスタジオ画像から写実人物へ姿勢を転写。
- 写実人物をシンプソンズ風にして姿勢を保持。
- カメラ角度を変えても商品の装着位置を維持。
- 前景と背景の両方へ深い被写界深度を適用。
- 複数人物の並びを崩さず集合写真化。
注目元:編集Tips(約513票)、Editing Beast(約840票)
D. 商品・広告・バーチャル試着(31~40)
- つぶれたコーラ缶を別商品の缶へ一括置換。
- 缶の変形を保持したまま色とデザインだけ変更。
- 商品色を周囲の白い面へ反射させる。
- 別画像の腕時計を人物の手首へ自然に装着。
- 元のポーズ、体型、照明を維持した腕時計広告。
- モデル、服、靴、バッグ、帽子の5参照による試着。
- 商品写真へ別画像のロゴを配置。
- パッケージだけ差し替えて撮影セットを保持。
- EC向け商品の透明背景切り抜き。
- 同一商品を複数の背景と照明で展開。
注目元:Editing Beast(約840票)、公式ブログの複数参照例
E. 背景・照明・材質編集(41~50)
- 昼の背景を雨の夜へ変更。
- 人物を保ったまま背景だけ交換。
- 参照画像の照明と背景を同時転写。
- 壁面を別画像の緑色テクスチャへ置換。
- 室内を暖色の夕景照明へ変更。
- ハイファッション撮影風のシャープな照明へ変更。
- 背景の光に合わせて人物の影を再計算。
- 通常ノイズとBrownianノイズの写実感比較。
- Eulerとカスタムeta 0.50サンプラーの質感比較。
- 二段階サンプラーでシャープネスと自然さを両立。
注目元:編集Tips、設定検証スレッド(約80票)
F. 透明PNG・切り抜き・局所編集(51~60)
- 単一キャラクターの透明背景PNG。
- 商品の透明背景アセット。
- 複数要素で構成した透過デザイン素材。
- 写真から人物だけを抽出。
- 透明レイヤー上の被写体を編集。
- アルファ境界を含む形状のインペイント。
- ヘッドフォンの形状と透明領域を同時変更。
- 赤く塗った服の領域だけ差し替え。
- 円で囲んだ小物だけ編集。
- マスク外を完全に戻す局所編集。
注目元:LanPaintによるアルファ編集(約77票)、初期レビュー
G. アウトペイントと修復(61~70)
- 左側だけキャンバスを拡張。
- 右側だけキャンバスを拡張。
- 上側だけキャンバスを拡張。
- 下側だけキャンバスを拡張。
- 左右と下を一度に拡張。
- 斜めに傾いた写真の空白を補完。
- 悪いトリミングで欠けた背景を復元。
- 部分的に見切れた被写体の周囲を補完。
- 元の背景を保ちながらワイド画角化。
- 古写真の復元で粒状感・コントラスト変化を比較。
注目元:アウトペイント検証(約62票)、写真復元への批判的検証
H. ポスター・文字・グラフィックデザイン(71~80)
- 大見出しを含むイベントポスター。
- 構図と情報階層を先に決めた広告デザイン。
- 2~2.5MPで大きな文字を安定させる比較。
- 4MP前後で文字なしビジュアルの精細感を上げる比較。
- 商品名入りパッケージデザイン。
- ビンテージテレビに「Qwen」と表示したグラフィック。
- 看板やロゴを別画像へ自然に合成。
- 長文プロンプトによる複雑なレイアウト。
- 英語インフォグラフィックの文字崩れ・中国語混入テスト。
- GPT系画像モデルとデザイン品質を比較するポスター。
注目元:デザイン用プロンプトテンプレート、短評とビンテージTV作例
I. スタイル変換・イラスト・物語制作(81~90)
- 写実写真からコミック風への変換。
- 写実人物からシンプソンズ風への変換。
- 参照画像の画風だけを別画像へ転写。
- キャラクターと背景を保った色調変換。
- ポラロイド写真風の画像生成。
- 4コマ形式のストーリーボード生成。
- 同じ人物を複数シーンへ展開。
- 動物、車、人物を保った連続物語カット。
- 現代アニメのスクリーンショット風作画。
- 写実寄りに引っ張られるアニメ調の失敗比較。
注目元:ポラロイド実験、Krea 2とのアニメ用途比較、初期レビュー
J. ワークフロー・速度・品質比較(91~100)
- CFG 1~5で構図・質感・コントラストを比較。
- CFG 2以下とCFG 4の「焼きすぎ」比較。
- 16ステップ・1MP・INT8で高速生成。
- 25ステップ・2Kでの編集品質検証。
- 30ステップ・2Kから4Kへアップスケール。
- 4ステップLoRAで約2倍の速度を狙う編集。
- 8ステップ、1024×1280、RTX 3060で約45秒の人物生成。
- QwenとFLUX.2 Kreaのキャラクターシート速度比較。
- 2Kでのピクセル精度と10参照画像の統合テスト。
- Fix v2.0と専用サンプラーで細部ノイズを抑える比較。
注目元:ComfyUIモデル公開スレッド(約106票)、4ステップ低VRAM(約44票)、実験結果、Fix v2.0
Redditの評価を要約すると
高く評価されている点
- 編集性能:色、背景、材質、ポーズ、商品を変えても元画像を比較的よく保持する。
- 複数参照:人物と商品、服飾、小物を組み合わせる制作に強い。
- キャラクター整合性:設定資料や連続カットの入口として有望。
- 透明画像:切り抜きだけでなくアルファ自体を生成・編集できる。
- アウトペイント:複数方向を一度に広げる用途で扱いやすい。
- サイズと速度:7Bの生成部としては実用的で、量子化・高速化の選択肢が多い。
繰り返し指摘されている弱点
- 手、指、腕、複雑な人体構造が不安定。
- 遠景の顔や細い線が崩れやすい。
- デフォルト出力にノイズ感や細部の乱れが出ることがある。
- コントラストが強く、黒が沈みすぎる場合がある。
- 写真復元では元の粒状感や微細形状を勝手に変えることがある。
- キャラクターシートで体型がずんぐりするという批判がある。
- 参照画像が増えると属性の混線や幻覚が起きやすい。
- 一部のアニメ調では写実・映画的な方向へ引っ張られる。
- 文字は強い例もある一方、小さい文字や英語インフォグラフィックは不安定。
- 設定、プロンプトリライト、サンプラーで結果の差が大きい。
この賛否から見えるのは、Qwen-Image 2.1が「一発で完璧な万能モデル」ではなく、「編集を中心に、設定とワークフローを詰めるほど伸びる制作モデル」だということだ。
実用的な始め方
ComfyUIなら最新版に更新し、内蔵テンプレートからText-to-ImageまたはImage Editを選ぶ。公式対応のワークフローはGitHubでも公開されている。まずは公式に近い40ステップで基準画像を作り、その後16、8、4ステップへ下げて速度と品質を比較するとよい。
編集では、曖昧に「もっと良く」ではなく、次の順で書くと検証しやすい。
- 何を変更するか。
- どの参照画像から持ってくるか。
- 何を絶対に変えないか。
- 光、背景、体型、ポーズ、構図をどう保持するか。
- 失敗しやすい要素をネガティブ指示へ入れる。
たとえば商品合成なら、「画像1の人物とポーズを保持し、画像2の腕時計だけを手首へ装着。体型、背景、照明を変更しない」と対象と保持条件を明確にする。複数参照では<image1>、<image2>の対応を曖昧にしないことが重要だ。
透明画像は、Redditで共有された例では「RGBA画像」「alpha channel」「background is transparent」を明示している。透明境界まで編集したい場合は、LanPaintなどアルファ対応のマスク処理を使う。
どんな人に向いているか
Qwen-Image 2.1は、次の用途と相性がよい。
- ComfyUIでローカル制作したい人。
- 人物や商品の一部だけを変えたい人。
- 複数の参照素材をひとつの広告やシーンへまとめたい人。
- キャラクター設定資料や動画用参照画像を作りたい人。
- 透明PNGやゲーム・Web用アセットを作りたい人。
- 専用サーバーで画像生成・編集APIを運用したい研究・開発チーム。
逆に、完全な写真復元、長い連続作品での厳密な同一性、手指が重要な複雑ポーズ、小さな文字が密集したインフォグラフィック、商用利用を前提にした無条件の採用では、別モデルとの比較とライセンス確認が欠かせない。
まとめ
Qwen-Image 2.1の本質は、70億パラメータという比較的小さな生成部に、T2I、画像編集、最大10枚の参照、局所編集、透明RGBA、被写体抽出を統合した点にある。Redditで最も熱を集めているのも、単純な美少女生成ではなく、腕時計や缶の置換、キャラクターシート、背景と照明の転写、アウトペイント、アルファ編集といった「制作工程を短くする使い方」だ。
一方で、作例の評価は設定に大きく左右される。CFG、サンプラー、ステップ数、解像度、プロンプトリライト、高速化LoRAによって、同じモデルとは思えないほど結果が変わる。まず公式設定で基準を作り、変更を一つずつ比較し、重要な案件では別モデルとのブラインド比較を行うのが安全だ。
そして最大の注意点はライセンスである。重みが公開されていても、商用利用が自動的に自由になるわけではない。技術面では非常に魅力的だが、業務で採用するなら公式ライセンスと最新条件を確認したうえで判断してほしい。
主要リンク
- Qwen-Image 2.1公式ブログ
- 公式GitHubリポジトリ
- Hugging Face Diffusersドキュメント
- ComfyUI向けモデル
- Reddit:1girl作例集
- Reddit:Editing Beast
- Reddit:編集Tips
- Reddit:アウトペイント
- Reddit:アルファチャンネルのインペイント
- Reddit:Qwen-Image 2.1 Fix v2.0
※本記事は2026年10月4日時点の公式情報と公開コミュニティ投稿をもとに作成した。Redditの票数やモデル周辺ツール、ライセンス条件は変わる可能性がある。