クロアチア語の音声合成モデルを3200万パラメータで作ってみた。学習途中の声を聞き比べ
クロアチア語の RAG 用 LLMに続いて、今度はクロアチア語専用の小さい音声合成(TTS)モデルを作ってみた。目標はスマホの CPU でリアルタイムに動くこと。
やり方は「蒸留」。大きい音声合成モデル(HiggsAudio v3)にクロアチア語の台本を読ませて学習データを作り、それで小さいモデルを一から学習した。今回はまず 7.5 時間分のデータでパイロット学習をして、同じ 1 文が学習とともにどう変わっていくかを聞き比べた。
先に結論。
- 3,200 万パラメータ(Matcha-TTS 1,830 万+Vocos 1,350 万)で、ちゃんとクロアチア語を喋った
- 学習 50 分(5,000 ステップ)の時点で、もう台本通りに読めた。 そこから先で良くなったのは主に「ノイズ」
- 評価用 14 文の文字誤り率は、最終で 0.9%(14 文中 10 文が完全一致)
- CPU 1 スレッドでも、1 秒の音声を 0.09 秒で作れた(i7-13700K)
デモ:実際に喋らせてみる
クロアチア語 TTS プレイグラウンド に、この記事のモデル(最終の 30,000 ステップ版)を置いた。好きなクロアチア語を入れると、その場で読み上げる。
- 50 個の例文(あいさつ、旅行、病院など)から選ぶか、自分で 1,000 文字まで入力できる
- 話す速さ、抑揚の大きさ、合成のステップ数を変えられる。シードを固定すると、同じ文なら毎回同じ音声になる
- 合成はサーバーの CPU だけで動かしている(ONNX Runtime、GPU も外部 API も使っていない)
- 数字は読めないので、「dvadeset pet(25)」のように単語で書く必要がある
やったこと
1. 台本を作る:ローカルの Gemma 4 31B に、クロアチア語の日常会話のセリフを書かせた。「市場で、おばあちゃんと話している」「夜中に変な音がして怖い」のように、状況・話し相手・感情・長さをランダムに指定して、1 回 22 行ずつ。話し手は 30 代の女性 1 人という設定。感情は 23 種類(普通、喜び、怒り、ささやき声など)を混ぜた。
2. 音声にする:HiggsAudio v3 に、参照音声(16 秒)の声で台本を読ませた。感情タグ(<|emotion:anger|> など)を付けると、ちゃんと怒ったり喜んだりする。4,500 本を約 5 時間で作った。
3. 自動で検査する:Whisper large-v3 で書き起こして台本と比べ、読み間違いを弾いた。あわせて話者認識モデルで参照音声との声の近さを測り、声が変わってしまったものも弾いた。合格は 4,500 本中 4,393 本(97.6%)。前後の無音を切ると 7.46 時間になった。
4. 小さいモデルを学習する:Matcha-TTS(フローマッチングという方式の TTS)を、RTX 4090 で 5 時間学習した。約 3 万ステップ。音声の波形に戻す部分(ボコーダ)は、公開されている Vocos をそのまま使った。
クロアチア語はほぼ書いた通りに読む言語なので、発音記号には変換せず、文字をそのまま入力にした。ただし lj・nj・dž は 1 つの音なので、1 文字としてまとめた。
学習途中の音声を聞き比べる
学習データに入っていない文「Molim Vas, možete li mi reći koliko košta ova haljina?(すみません、このワンピースはおいくらですか?)」を、学習途中のモデルで合成した。
step 5,000(学習開始から約 50 分)
step 10,000(約 1 時間 40 分)
step 15,000(約 2 時間 20 分)
step 20,000(約 3 時間 10 分)
step 30,000(約 5 時間、最終)
参考に、先生役の HiggsAudio が作った学習データの 1 本(別の文:「Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.」)。
Whisper で書き起こすと、この文は step 5,000 から最後まで全部、台本と一字一句同じだった。つまり「何と言っているか」は最初からできている。
違いは音のきれいさ。聞いた印象では、step 5,000 はザラザラしたノイズが乗っていて、step 10,000 でかなり減った。同じ音声をスペクトログラム(横が時間、縦が周波数)にするとよくわかる。
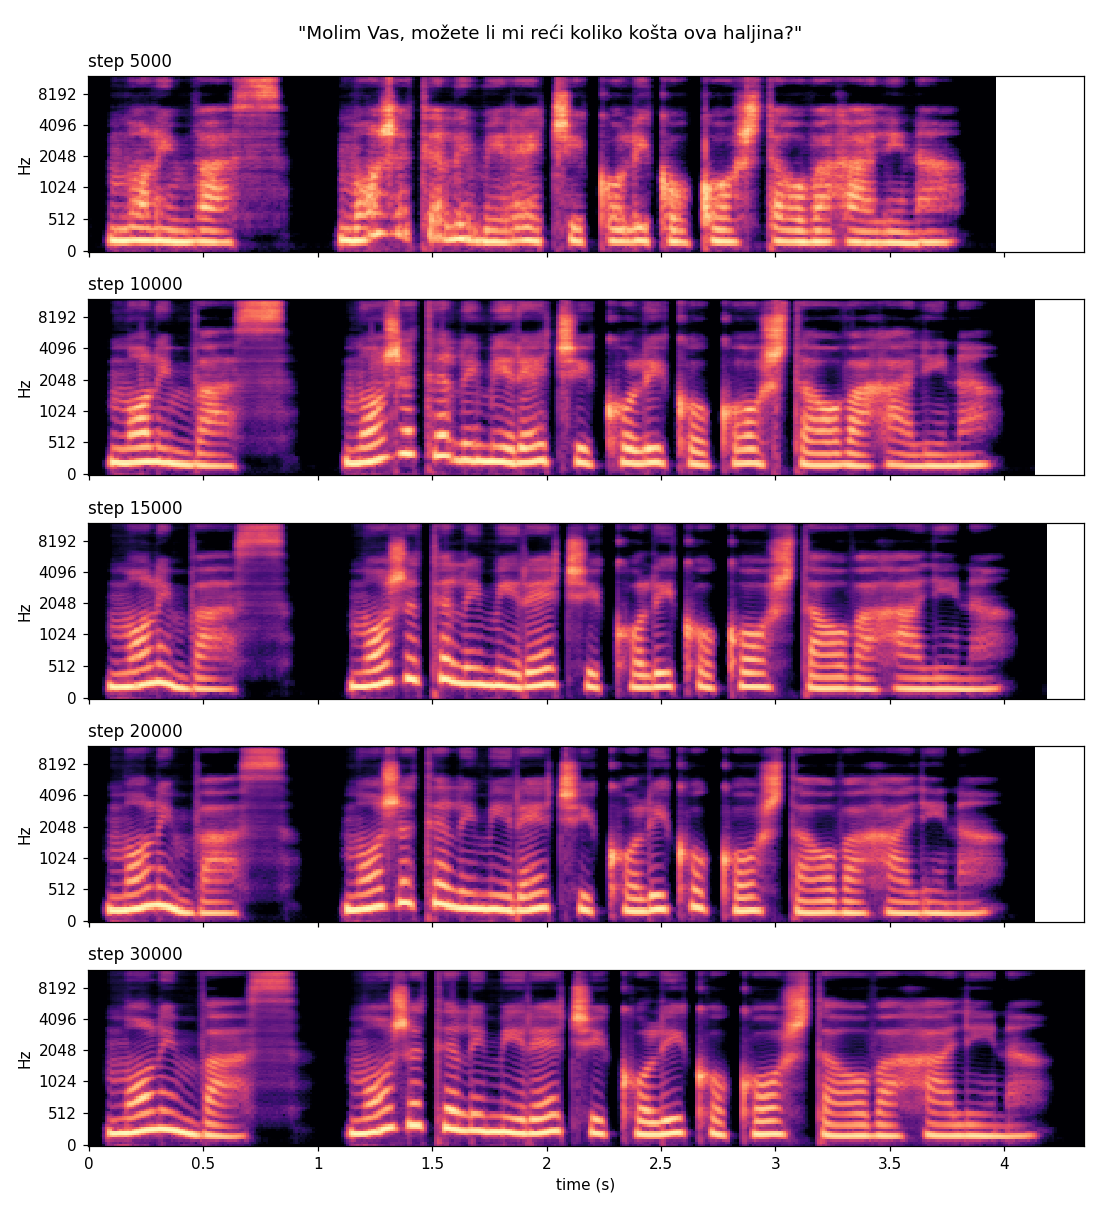
声の高さに合わせて並ぶ横縞(倍音)が、step 5,000 ではにじんでいて、縞のすき間がもやっと埋まっている。これがノイズに聞こえる部分。step 10,000 以降は縞がくっきりして、すき間が暗くなる。学習が進むと縞が上下になめらかにカーブするようになっていて、声の高さの動き(抑揚)もはっきりしてきたように見える。
数字で見る
評価用の 14 文(すべて学習データ外)を Whisper large-v3 で書き起こして、文字誤り率(CER)を測った。短いあいさつから 16 秒くらいの独白まで入れてある。
| ステップ | 学習時間 | 文字誤り率 | 完全一致 |
|---|---|---|---|
| 5,000 | 約 50 分 | 1.1% | 9 / 14 |
| 10,000 | 約 1 時間 40 分 | 3.4% | 8 / 14 |
| 15,000 | 約 2 時間 20 分 | 0.7% | 11 / 14 |
| 20,000 | 約 3 時間 10 分 | 0.9% | 11 / 14 |
| 30,000 | 約 5 時間 | 0.9% | 10 / 14 |
- step 10,000 で数字が悪くなったのは、ほぼ「Bok!(やあ)」の 1 文が「Vok」と聞き取られたせい。3 文字中 1 文字の違いなので、この 1 文だけで誤り率 33% になる。耳で聞くと、step 10,000 のほうが step 5,000 よりずっときれいだった。文字誤り率は「読めているか」しか測れないので、音のきれいさは聞いて判断するしかない
- 最後まで残った間違いは「Đak je pojeo džem(生徒がジャムを食べた)」の đ と dž。クロアチア語でも出てくる回数が少ない音で、「Žak」「Džak」と聞き取られた
CPU での速さ
i7-13700K で、PyTorch のまま(最適化なし)測った。4 文・計 47.6 秒の音声を 3 回作った平均。RTF は「作るのにかかった時間 ÷ 音声の長さ」で、小さいほど速い。
| スレッド数 | ステップ数 | Matcha | Vocos | 合計 RTF |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
「ステップ数」は合成のときにノイズから音を作る反復の回数で、上の聞き比べは 4 で作った。1 スレッドでも 1 秒の音声を 0.09 秒で作れる。スマホの CPU はこれより遅いけど、リアルタイムには収まりそう(まだ実機では測っていないので、これは予想)。
TTS って何時間のデータが要るの?
7.5 時間でここまでできたので、一般的な目安を調べてみた。
- 1 人の声の TTS でよく使われる英語の LJSpeech は約 24 時間。Matcha-TTS の公式モデルもこれで学習している
- 日本語の JSUT や中国語の CSMSC は約 10 時間で、1 人の声のコーパスとして普通に使われている
- 一から学習するなら1 時間くらいが下限で、モデルによっては発音ミスが増える
- 学習済みのモデルを追加学習するなら、30 分で一から 27 時間学習したのと同じくらいになった、という報告もある
合成音声だけで Matcha-TTS を学習した研究(上海交通大学、2025 年 12 月)もあった。そこでは、テキストの種類が多いほど良く、雑音のないきれいな音声ほど良く、話し方がそろっているほど学習しやすいとされている。合成データはノイズがなく話し方もそろうので、同じ時間なら実際の録音より学習しやすいのかもしれない。今回 7.5 時間でここまで来たのも、それっぽい。
ハマったところ
- PC が固まった:台本作り用の 31B モデルが、うっかり 2 つ同時に GPU に載って VRAM があふれた。それ以来「GPU に載せるモデルは常に 1 つ」をルールにした
- Gemma 4 の考えすぎ:出力の約 3 分の 2 が「思考」だった。思考をオフにしたら約 3 倍速くなった
- HiggsAudio の幻聴:最初のテストで、文の後の無音に「Hvala što pratite kanal(チャンネルをご覧いただきありがとう)」と勝手に続けて、81 秒になったクリップがあった。YouTube の締めのセリフを覚えているっぽい。長さが予想と大きくずれたものは弾くようにした
- Windows で Matcha-TTS が動かない:一部の C 拡張がビルドできなかったので、その部分を Python(numba)で書き直した