自作の3億パラメータLLMを量子化して、CPUでのスピードと正確さを比べてみた
前回の記事で作った、クロアチア語 RAG 用の 3.2 億パラメータのモデル。CPU で動かす前提なので、今度は量子化して、どこまで小さく・速くできるか、正確さはどこまで落ちるかを試してみた。
先に結論。
- Q6_K がちょうどいい。 サイズは 1/5(254MB)、生成は約 4 倍速、正確さは元のモデルと同じ
- Q2_K は壊れる。 速いけど、答えがある問題でも「答えはありません」と断りだす
- 意外なことに、Q4_K_M より Q3_K_M のほうが正確だった
やったこと
PyTorch で作ったモデルを、CPU 推論でよく使われる llama.cpp で動かせる形(GGUF)に変換して、8 種類の精度で保存した。
- モデルを Qwen3 と同じ形式で書き出して、GGUF に変換
- トークナイザは自作なので、llama.cpp が「知らないトークナイザ」として変換を拒否した。単語を区切るルールを比べたら Qwen2 と一字一句同じだったので、Qwen2 として登録して通した
- 変換が正しいかを確認。 文章 160 本のトークン分割が PyTorch 版と全部一致。20 問で、毎回一番確率の高い語を選ぶ生成をさせたら、出力も 20 問とも完全に一致した
llama-quantizeで F16〜Q2_K を作成
なので、表の F32 は PyTorch 版と同じ中身。ここが比較の基準になる。
測り方
- CPU は i7-13700K。GPU は使っていない
- llama.cpp の設定は、生成 8 スレッド、文章の読み込み 16 スレッド(試したらこれが一番速かった)
- 評価用の 100 問 × 4 種類の文脈で、1 モデル 400 回ずつ答えさせた
- 段落:答えが入っている 100 トークンくらいの段落
- 長文:答えが入っている約 3,000 トークンの文章(関係ない記事も混ぜてある)
- 答えなし(段落・長文):答えが入っていない文章。断れたら正解
- 前回の記事は 300 問で測ったので、数字は少しずれる
結果:正確さ
| 形式 | サイズ | 段落 正解 | 長文 正解 | 長文 断った | でっち上げ(答えなし 段落/長文) | 照合後の正解率 |
|---|---|---|---|---|---|---|
| F32(基準) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
「照合後の正解率」は、モデルの引用が本当に文章の中にあるかをプログラムで確かめて、なければ「答えなし」に差し替えたあと、答えた中で正しかった割合。
- F16・Q8_0・Q6_K は基準とほぼ同じ。 1〜2 問の差しかない
- Q5_K_M から下は、間違いが増えるより「断る」が増える。 自信がなくなると断る、という前回教えた性格がそのまま出ている感じ。でっち上げは増えていない
- Q4_K_M が Q3_K_M より悪い。 長文で 37% と 48%。100 問なので多少はぶれるけど、11 ポイントは大きい。理由はまだ調べていない
- Q2_K は長文の 78% を断る。 もう別のモデル
結果:速さ
| 形式 | 生成速度 | 1 回の平均時間 |
|---|---|---|
| PyTorch fp32(参考) | 段落 14.6・長文 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 秒 |
| F16 | 35.9 tok/s | 2.08 秒 |
| Q8_0 | 59.0 tok/s | 1.93 秒 |
| Q6_K | 73.1 tok/s | 1.33 秒 |
| Q5_K_M | 81.2 tok/s | 1.26 秒 |
| Q4_K_M | 89.1 tok/s | 1.10 秒 |
| Q3_K_M | 103.4 tok/s | 1.12 秒 |
| Q2_K | 119.9 tok/s | 1.07 秒 |
llama.cpp の数字は 400 回の平均(段落・長文・答えなしを全部まとめたもの)。PyTorch の数字は前回の記事で測ったもの。
- 生成の速さはサイズにほぼ反比例。CPU では計算よりメモリから重みを読む速さで決まるから、小さいほど速い
- 同じ F32 でも、llama.cpp は PyTorch より速い
- ただし Q6_K から下は、1 回の時間があまり縮まない。この長さだと、最初に文章を読み込む時間のほうが大きくなるから
動画:同じ長文の質問を、CPU で解かせてみた
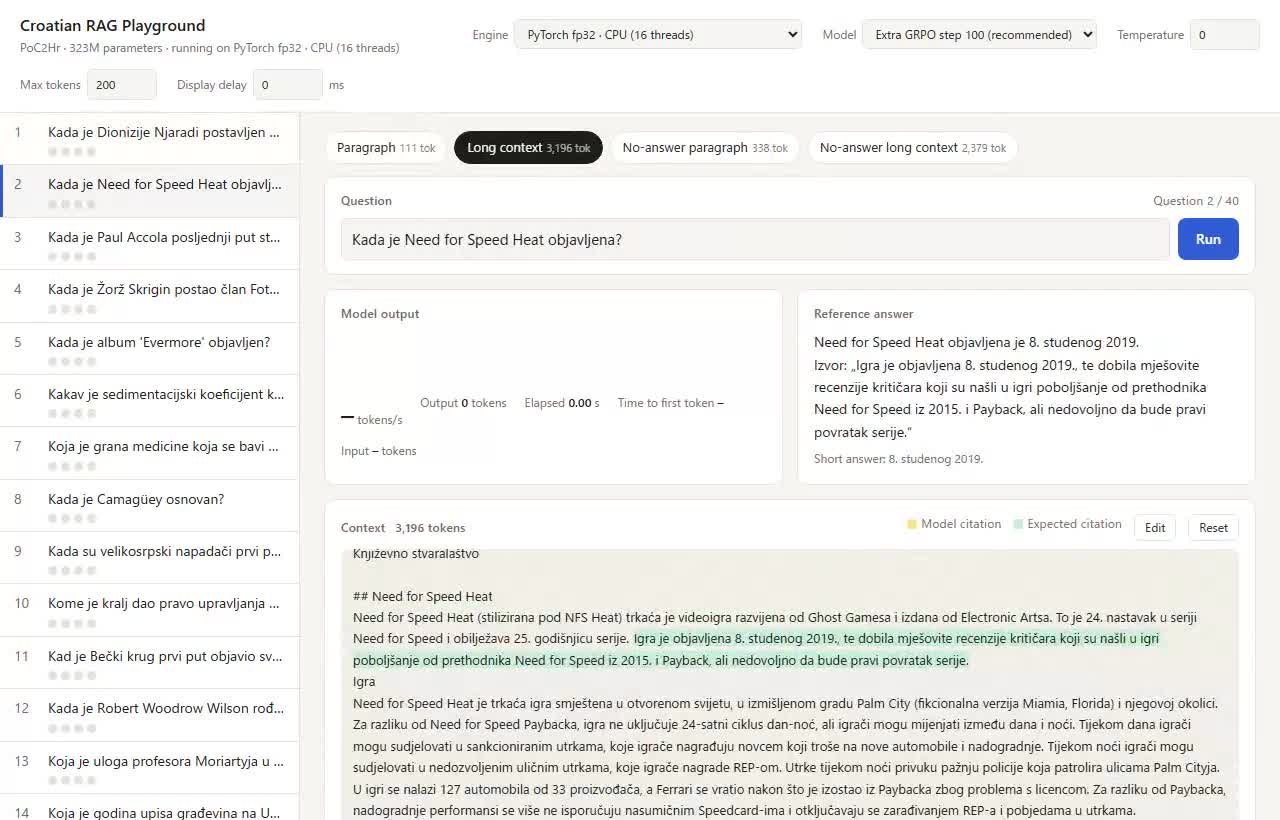
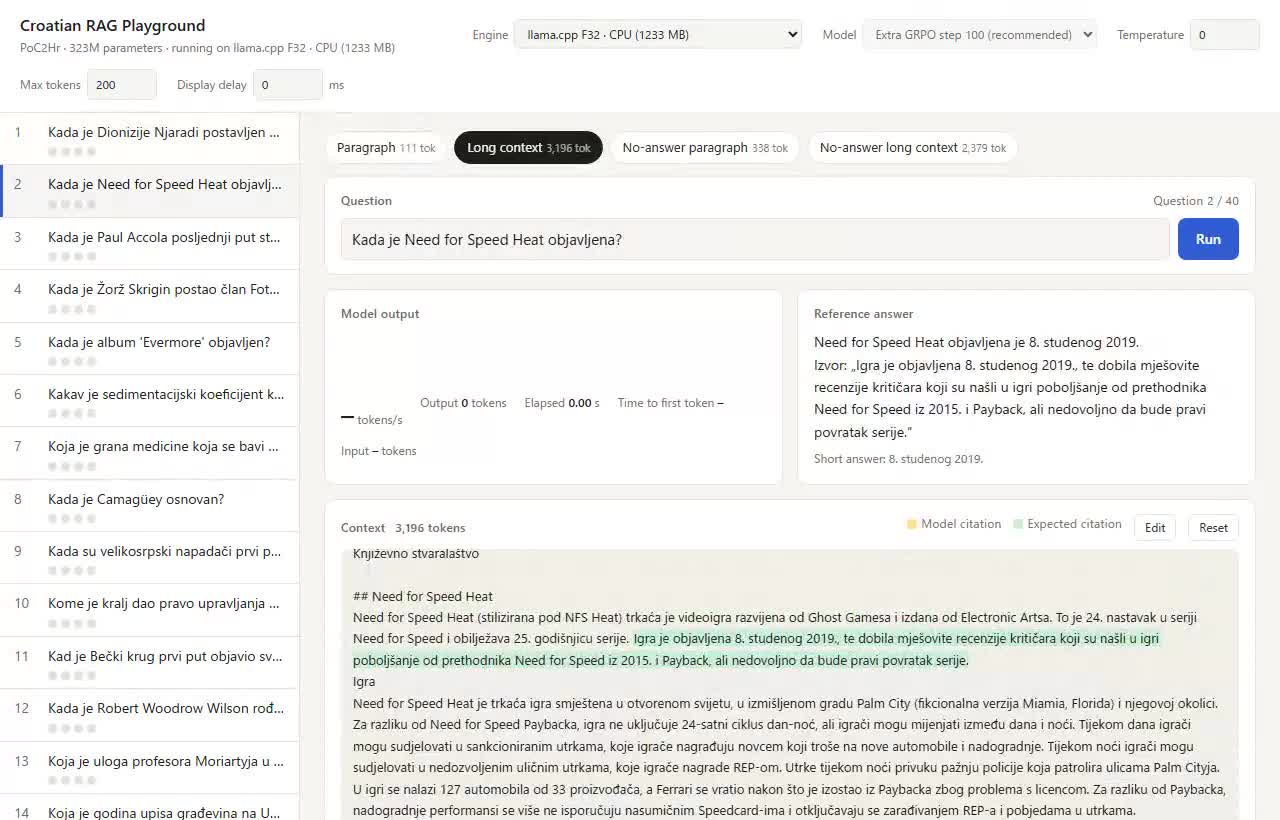
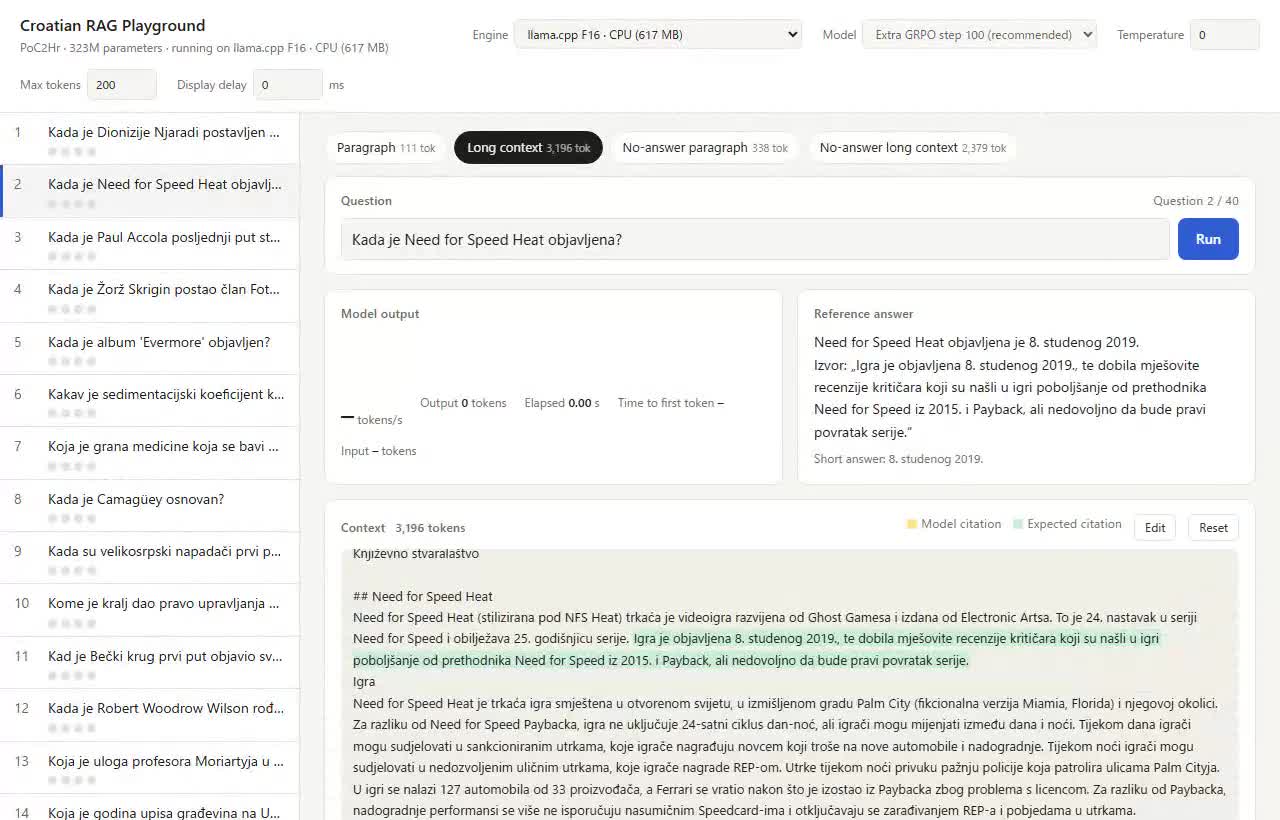
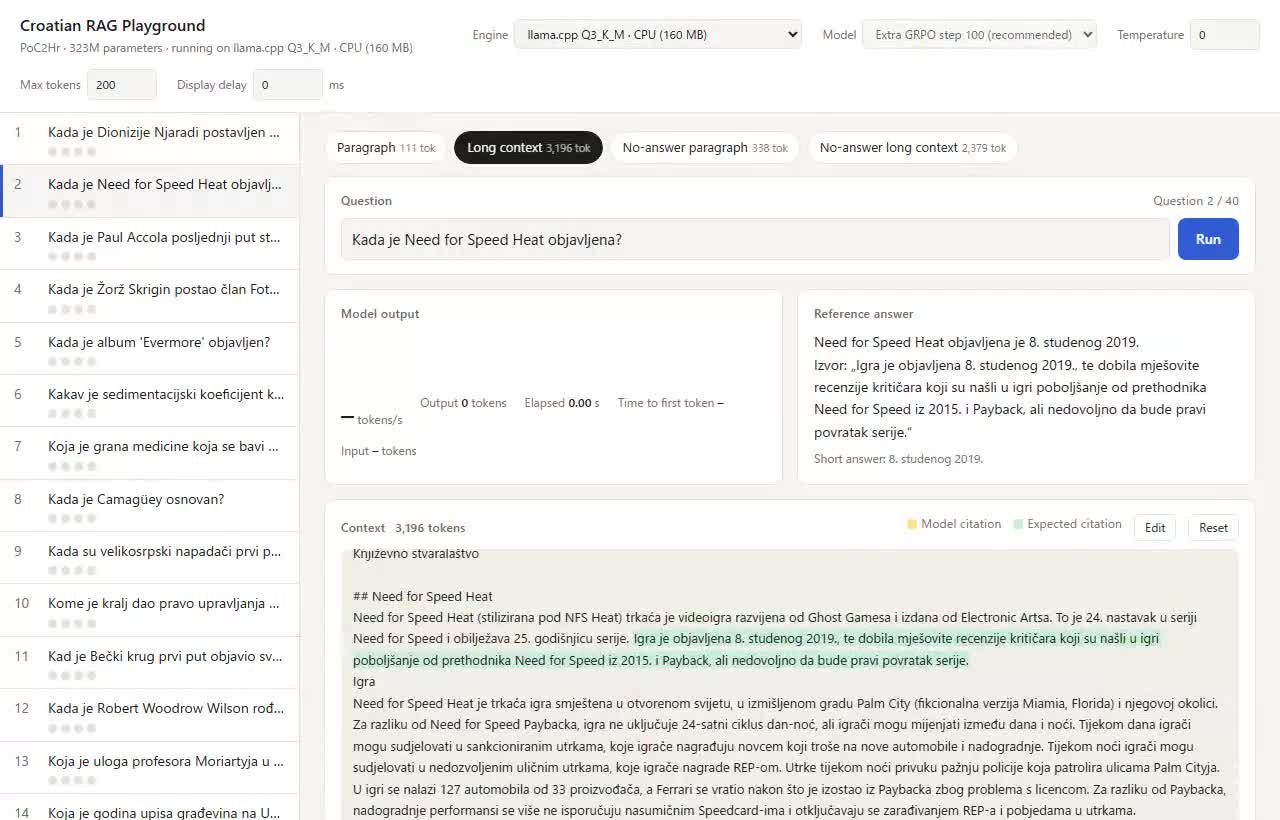
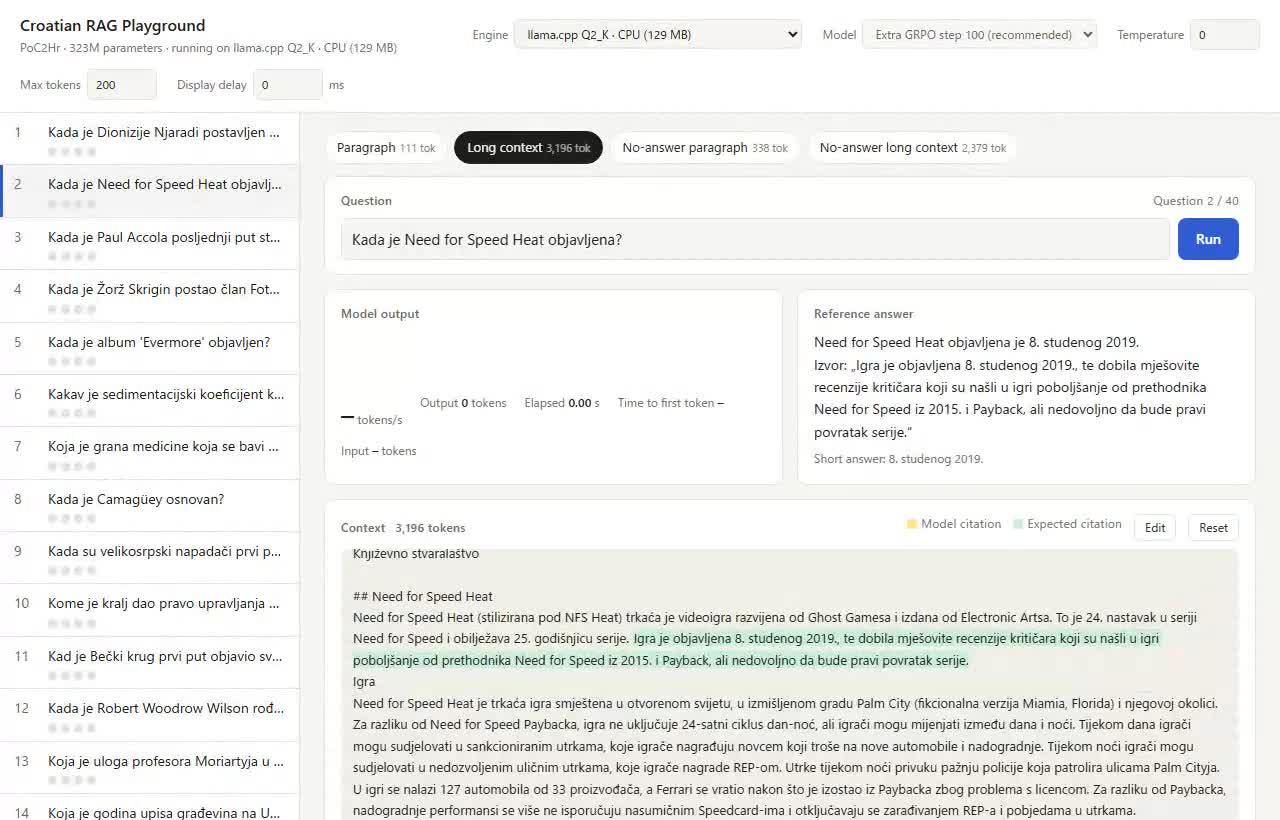
約 3,200 トークンの文章を渡して「Need for Speed Heat はいつ発売された?」と聞いた。正解は 2019 年 11 月 8 日。
録画しながら、しかもブラウザで画面を描きながら動かしているので、動画の中の速度は上の表より遅め。並べて比べる用として見てほしい。
| 形式 | 動画内の生成速度 | 最初の文字まで | 全体 | 結果 |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 秒 | 18.5 秒 | 正解 |
| F32 | 14.2 tok/s | 2.8 秒 | 8.1 秒 | 正解 |
| F16 | 25.9 tok/s | 3.5 秒 | 6.4 秒 | 正解 |
| Q8_0 | 38.2 tok/s | 4.0 秒 | 5.9 秒 | 正解 |
| Q6_K | 41.6 tok/s | 2.6 秒 | 4.4 秒 | 正解 |
| Q5_K_M | 46.3 tok/s | 2.6 秒 | 4.3 秒 | 正解 |
| Q4_K_M | 47.2 tok/s | 2.3 秒 | 4.7 秒 | 正解(答えが長め) |
| Q3_K_M | 56.7 tok/s | 2.5 秒 | 4.5 秒 | 正解(答えが長め) |
| Q2_K | 61.3 tok/s | 2.7 秒 | 2.8 秒 | 断った |
F32 から Q5_K_M までは、答えも引用も PyTorch 版と一字一句同じ。Q4_K_M と Q3_K_M は答えの文が長くなったけど、引用は正しかった。Q2_K は答えがあるのに「本文に答えはありません」と断った。
PyTorch fp32(元のモデル)
llama.cpp F32(1,233MB)
llama.cpp F16(617MB)
llama.cpp Q8_0(329MB)
llama.cpp Q6_K(254MB)
llama.cpp Q5_K_M(223MB)
llama.cpp Q4_K_M(193MB)
llama.cpp Q3_K_M(160MB)
llama.cpp Q2_K(129MB)
考察
- このモデルを CPU で動かすなら Q6_K。 正確さは元のまま、サイズは 1/5、生成は PyTorch の約 5 倍。迷う理由がない
- 安心を取るなら Q8_0。 元とほぼ同じで 329MB。それでも十分小さい
- 3 億パラメータの小さいモデルは、量子化に弱い。 大きなモデルだと Q4 でもほぼ劣化しないと言われるけど、今回は Q5 から目に見えて落ちた。もともと余裕のないモデルなので、削られると効く
- 壊れ方が「断る」方向なのはありがたい。 でっち上げが増えるより、断るほうが RAG では安全。前回、強化学習で断り方を教えた効果が、ここでも出ている
- 小さいモデルでは、速さの差が縮む。 Q6_K から下は、生成が速くなっても文章を読み込む時間が残るので、体感はあまり変わらない。動画でも Q6_K〜Q3_K_M は 4 秒台に並んだ
- Q4_K_M が Q3_K_M に負けた理由は分からないまま。もっと問題数を増やしたり、どの層をどう量子化しているかを見たりして調べたい