SLMのRAG性能を検証してみた。1B〜9Bの25モデルをクロアチア語と英語で比べた
自作のクロアチア語 RAG モデルを作って量子化までやったので、今度は世の中の小さいモデル(SLM)が RAG でどれくらい使えるのかを調べてみた。1B 級 10 個、3B 級 8 個、7B 級 7 個の計 25 モデルに、自作の 3.2 億モデルを加えて、クロアチア語と英語の同じ問題を解かせた。
追記(同じ日):RAG 専用に作られた小さいモデル 3 つ(LFM2-1.2B-RAG、Pleias-RAG-1B / 350M)も試した。結果は記事の後半の「追記:RAG 専用モデルも試してみた」に。
先に結論。
- 3〜4B 級で、もう 8〜9B 級とほぼ並ぶ。 クロアチア語の総合正解率は Qwen3.5 4B と Gemma 4 E4B が 90%、一番上の Qwen3.5 9B が 91%
- 差がつくのは「答えがないときに断れるか」。 正解率トップ級の Phi-4-mini は、答えのない長文の 64% で答えをでっち上げた
- 英語のほうが「答えがあるのに断る」モデルが多い。 OLMo 3 7B は英語の段落の 47%、MiniCPM5 2B は 70% を断った
- CPU では 7B 級は長文 1 問に 30 秒以上。 1B 級なら 4〜13 秒。自作の 3.2 億は 2.1 秒で、正確さは Qwen3.5 0.8B と同じくらい
やったこと
問題:前回の記事と同じ、クロアチア語版 Wikipedia から作った質問。1 問につき 4 種類の文章を渡す。
- 段落:答えが入っている 100 トークンくらいの段落
- 長文:答えが入っている約 3,000 トークンの文章(関係ない記事も混ざっている)
- 答えなし(段落・長文):答えが入っていない文章。「本文に答えはありません」と断れたら正解
英語版:同じ問題を EuroLLM-9B で英訳した。英訳で答えが消えたり、訳さずにクロアチア語のまま残ったりした問題は両方の言語から外して、同じ 260 問で比べた。
指示:「下の文章だけを使って、1 文で短く答えて。答えがなければ『本文に答えはありません』とだけ答えて」を、それぞれの言語で渡した。
採点:Qwen3.5 9B に、模範解答と見比べて「正解・不正解・断った」を判定させた。65 件を自分で見て確認したら、年だけ答えたような部分的な答えも正解にする少し甘めの採点だったけど、断ったかどうかの判定は全部合っていた。
総合正解率:段落と長文で正解できた数と、答えなしで断れた数を合わせて、全問題で割ったもの。正しく答えるのと、知らないときに黙るのを両方見る数字。
動かし方:正確さは RTX 4090 の vLLM で、毎回一番確率の高い語を選ぶ生成。考えてから答える「思考モード」があるモデルはオフにした。7B 級は GPU メモリに入れるため FP8 にした。
結果:正確さ(クロアチア語)
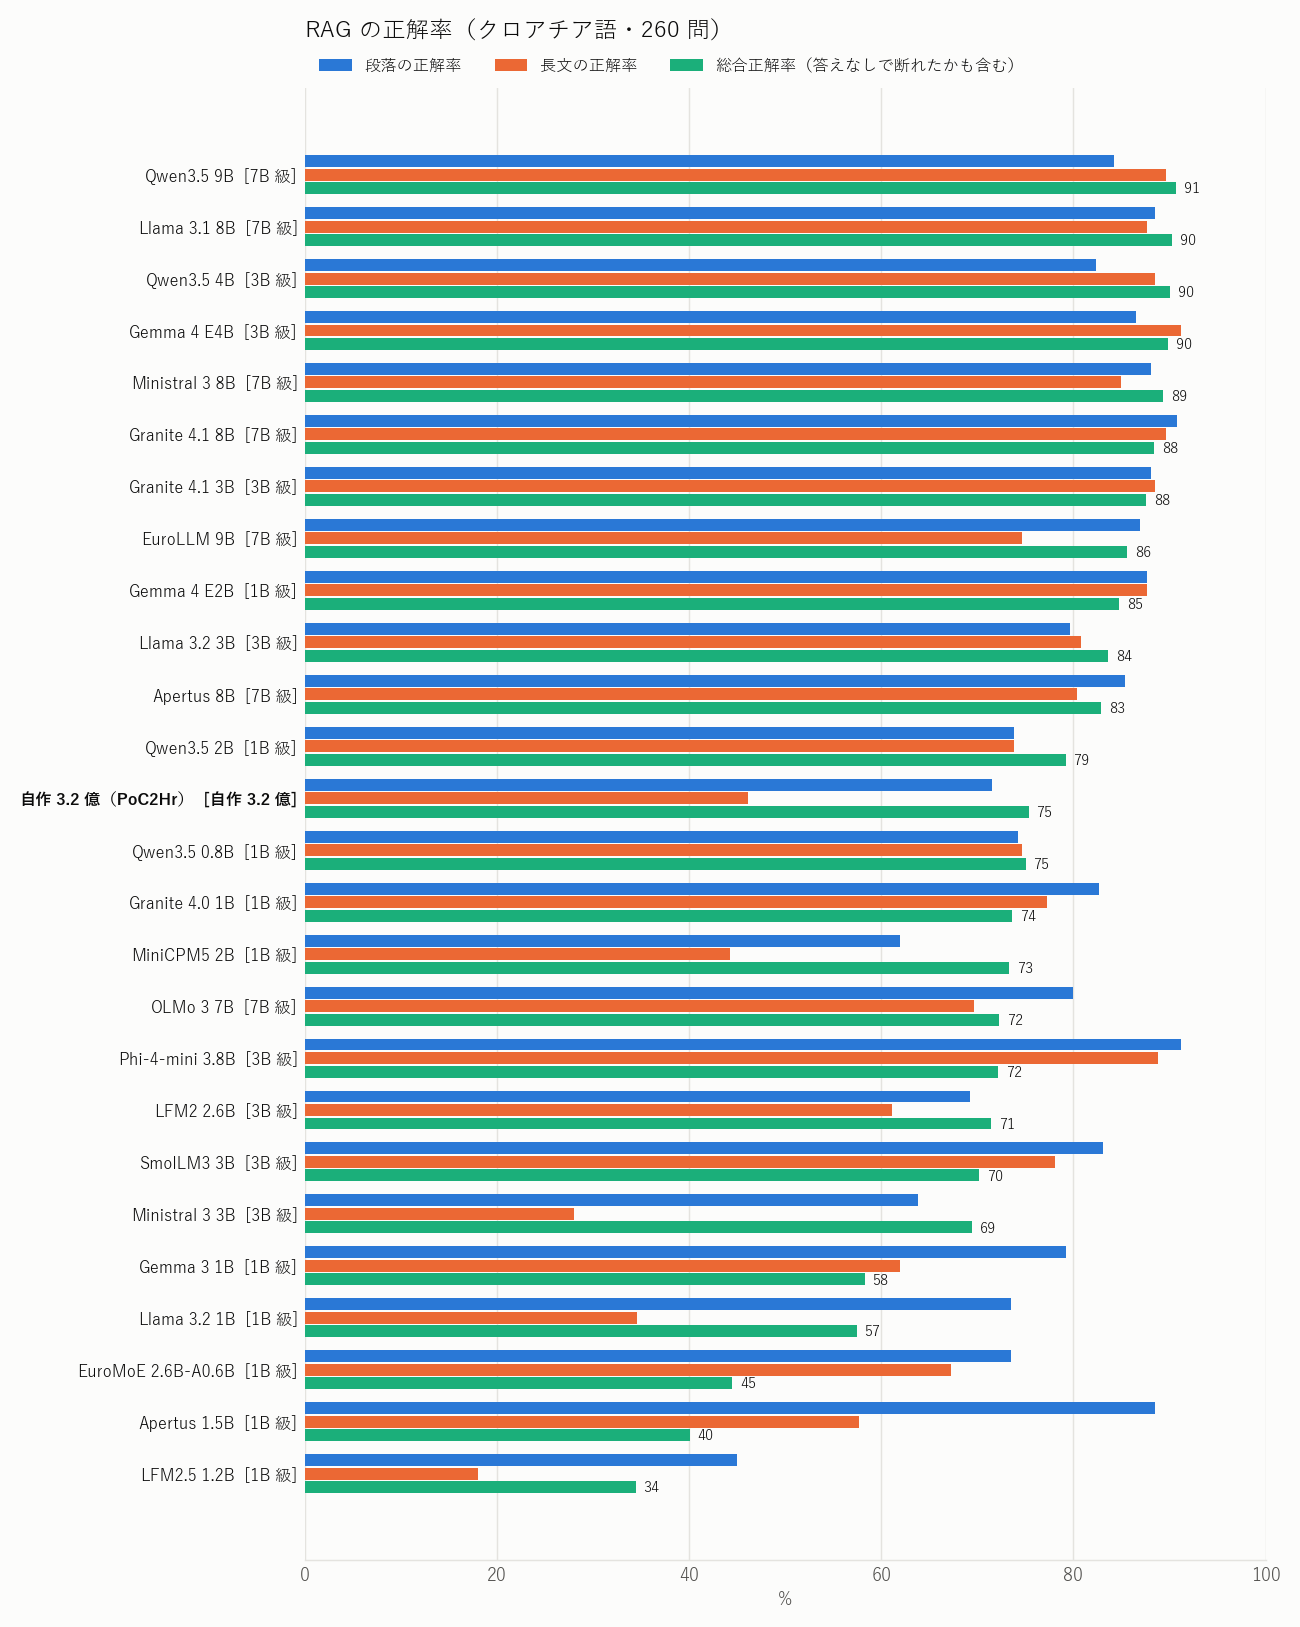
- 上位はほぼ 90% で横並び。 Qwen3.5 9B(91%)、Llama 3.1 8B、Qwen3.5 4B、Gemma 4 E4B(90%)
- 1B 級では Gemma 4 E2B が抜けている(85%)。 ただし名前は 2B でも、ファイルは 3.2GB と大きめ
- 段落と長文の正解率が高くても、総合で落ちるモデルがある。 Phi-4-mini は段落 91%・長文 89% で一番上のグループなのに、総合は 72%。理由は次の「でっち上げ」
- 一番悪かったのは LFM2.5 1.2B(34%)。答えのある問題で正解できず、答えのない問題ではでっち上げた
結果:正確さ(英語)
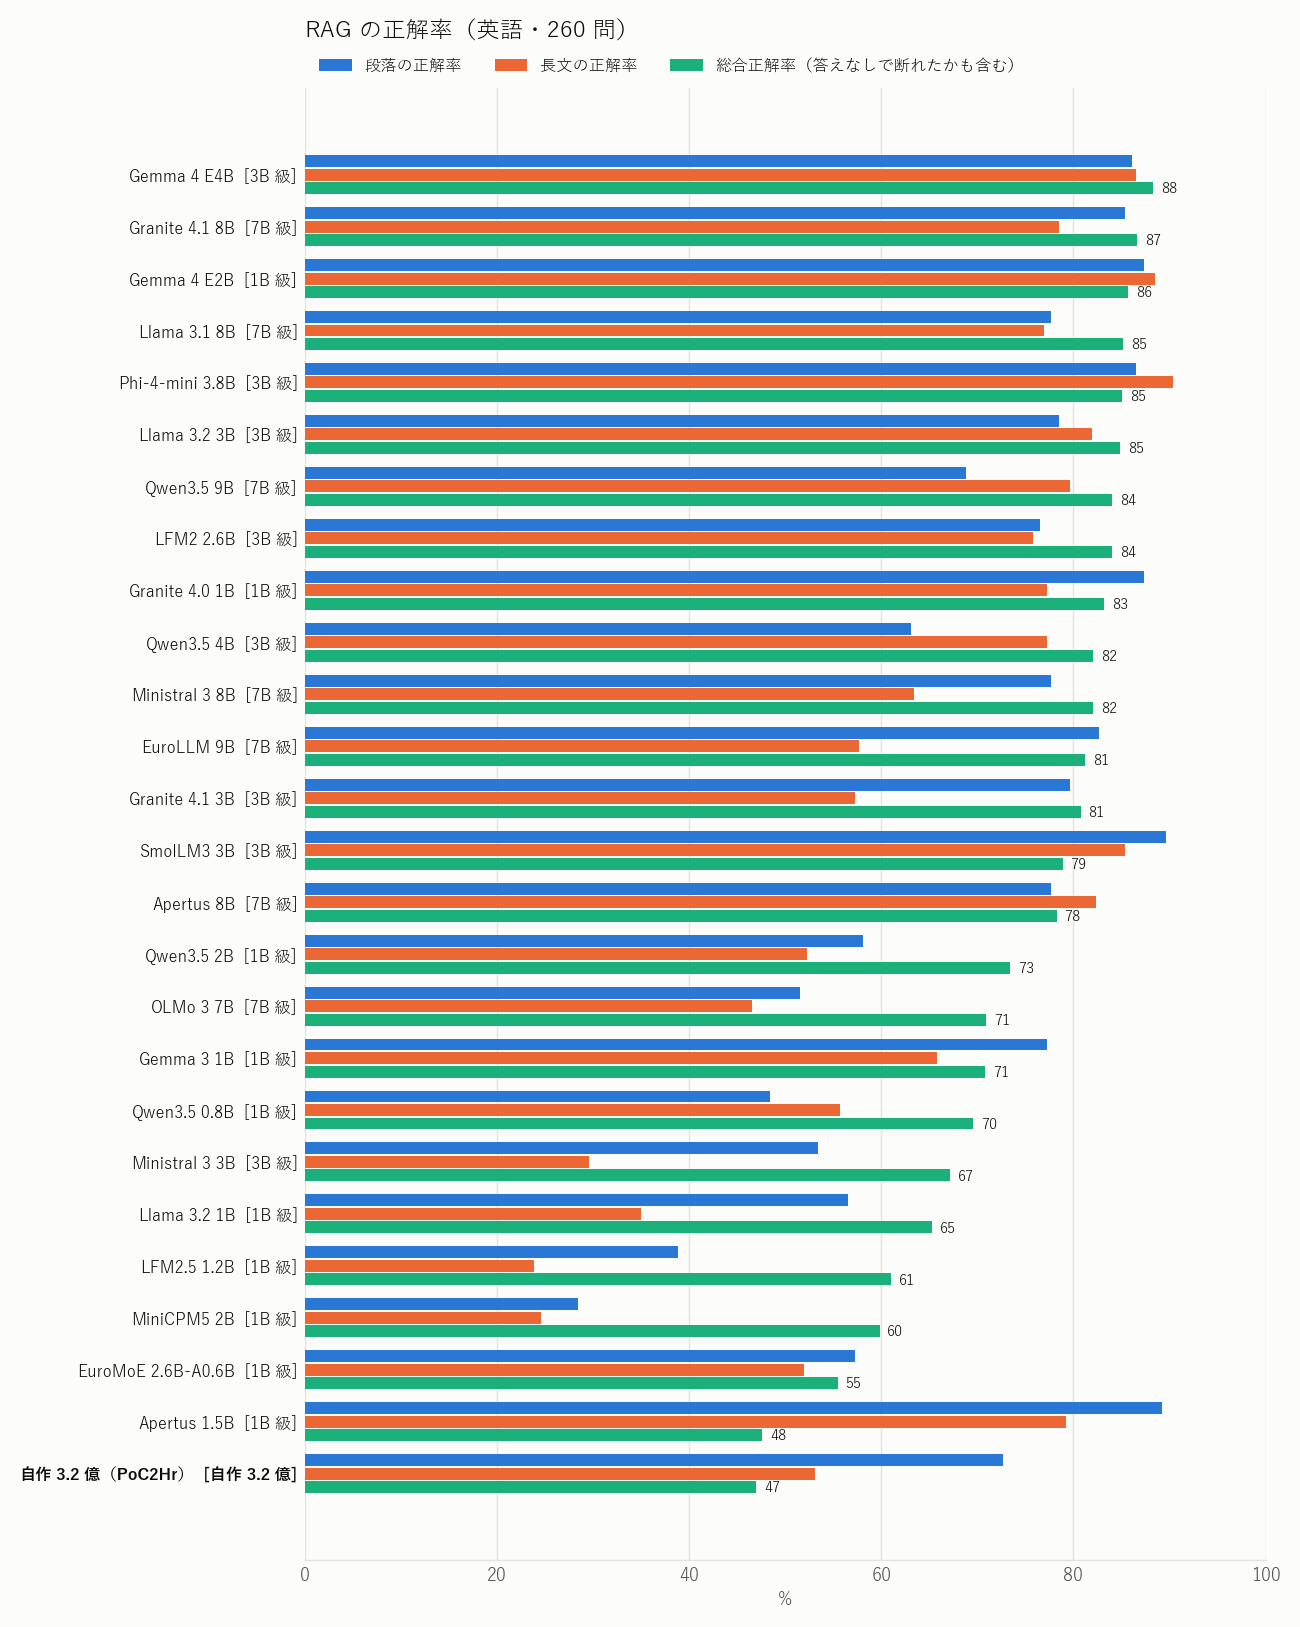
- 一番は Gemma 4 E4B(88%)。Gemma 4 E2B も 86% で、Gemma 4 は 2 言語とも安定
- 英語だと順位が下がるモデルがある。 Qwen3.5 4B はクロアチア語 90% → 英語 82%。原因は答えがあるのに断ること(段落の 35%)
わかったこと 1:差がつくのは「断れるか」
答えのない長文を渡したとき、でっち上げた割合(クロアチア語)。
| モデル | 答えのない長文でのでっち上げ |
|---|---|
| Qwen3.5 4B | 9% |
| 自作 3.2 億 | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
たとえば「Need for Speed Heat はいつ発売された?」と聞いて、答えの入っていない長文を渡した場合。Qwen3.5 9B は「本文に答えはありません」と答えたのに、Phi-4-mini は「1969 年 8 月」と答えた。文章のどこかにあった日付を拾ってきたっぽい。
RAG で一番困るのはこれ。正解率だけを見てモデルを選ぶと危ない。答えた中で正しかった割合は、Qwen3.5 の 4B と 9B が 91〜92% で一番高く、Phi-4-mini は 64% しかなかった。
わかったこと 2:英語だと断りすぎる
逆に、英語では答えがちゃんと書いてあるのに断るモデルが多かった。答えがある段落を渡して断った割合。
| モデル | クロアチア語 | 英語 |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
たとえば「Paul Accola が最後に表彰台に立ったのはいつ?」。英語の段落には「the last time in 2000」とはっきり書いてあるのに、Qwen3.5 4B は「本文に答えはありません」と答えた。同じ問題をクロアチア語で聞くと「2000 年」と正しく答える。
理由はまだわからない。英語版は機械翻訳なので、文章の不自然さが効いているのかもしれないし、英語で「答えがなければこう答えて」という指示に強く反応しているのかもしれない。
結果:CPU での速さ
自分の用途は CPU で動かす前提なので、全モデルを llama.cpp の同じ形式(Q4_K_M)に変換して、i7-13700K で測った。生成は 8 スレッド、文章の読み込みは 16 スレッド。Ministral 3 だけは変換がうまくいかなかったので、Mistral 公式の Q4_K_M を使った。
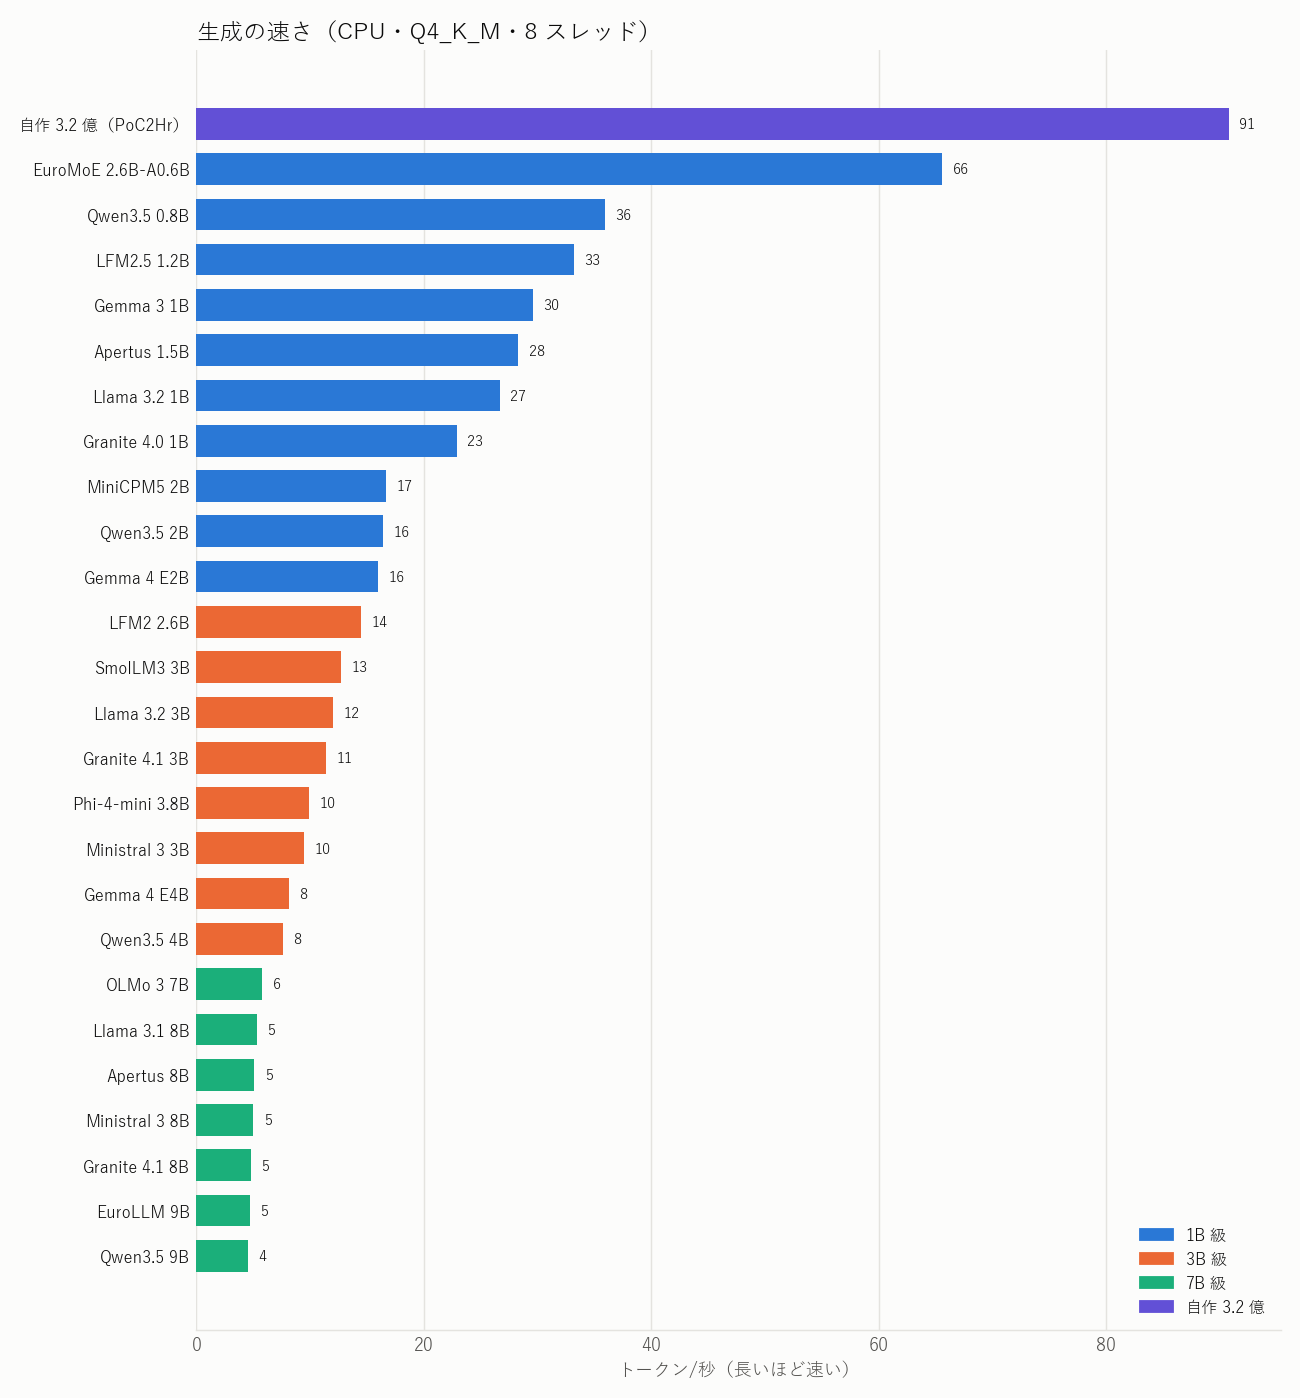
長文 1 問に答えるまでの時間も見積もった。モデルごとの、長文の入力トークン数を読み込む時間と、平均の回答の長さを生成する時間を足したもの。
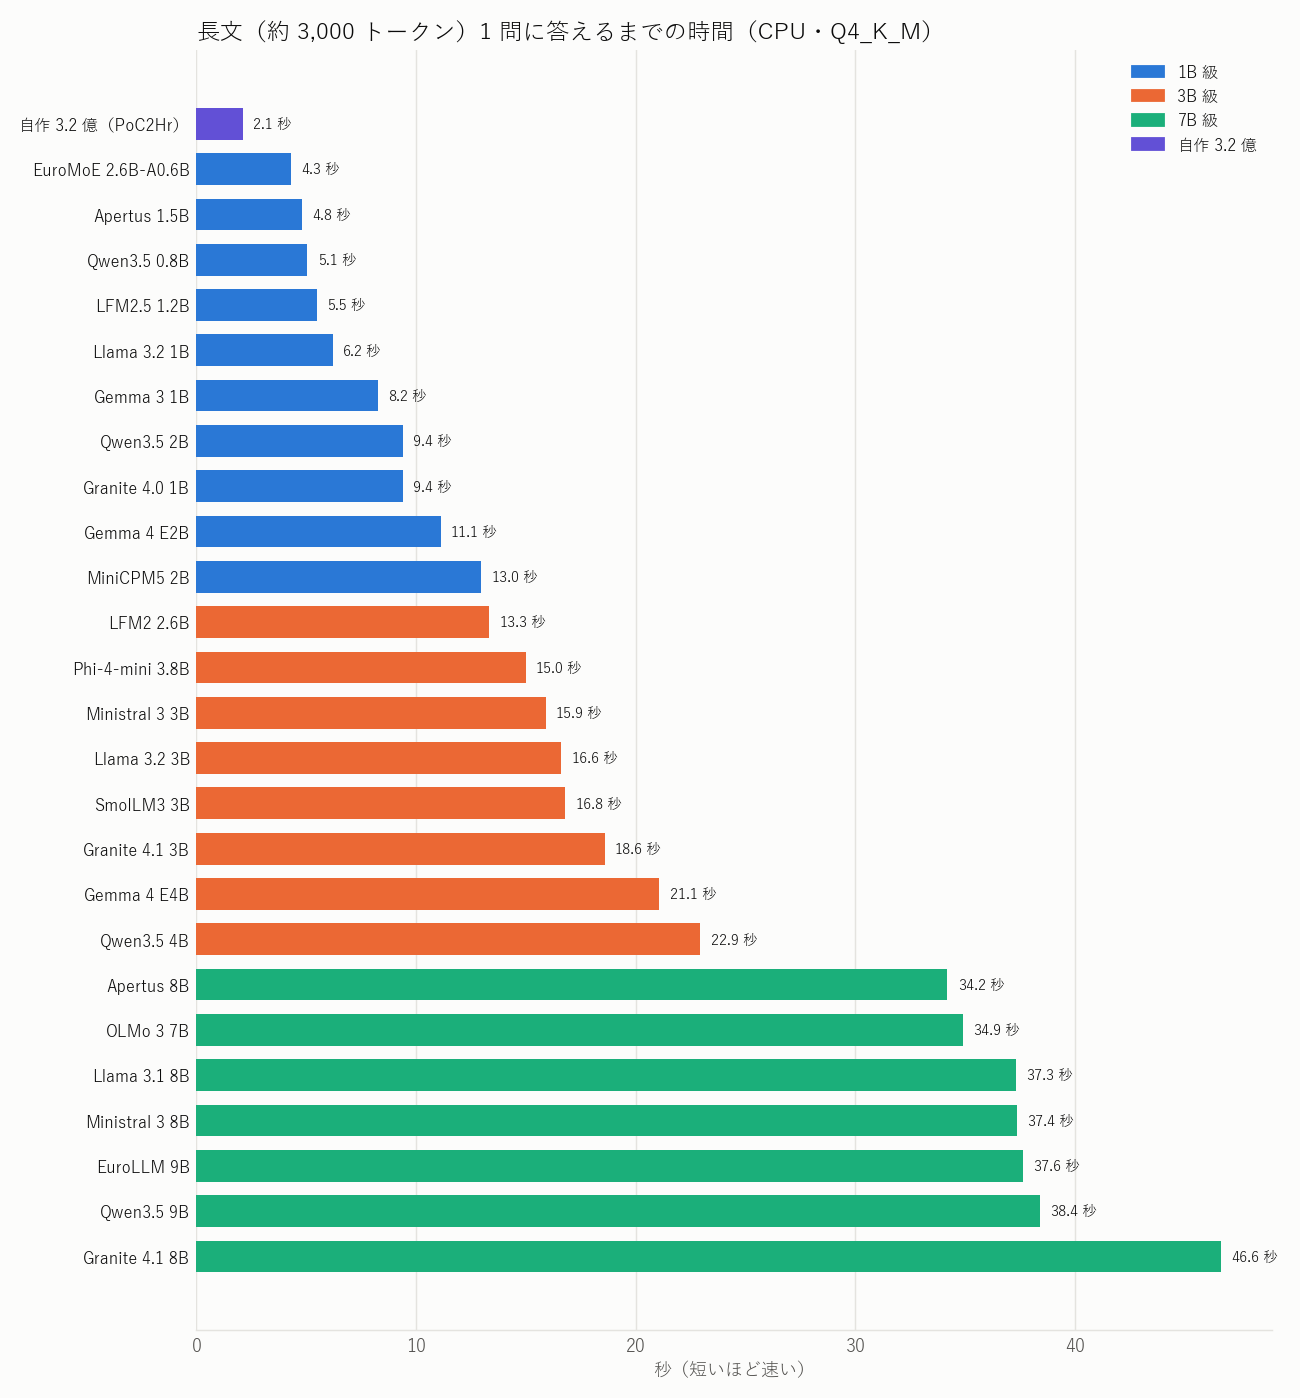
- 生成の速さは、だいたいサイズに反比例する。7B 級は毎秒 5 トークン前後で、長文 1 問に 34〜47 秒
- 3B 級は 13〜23 秒、1B 級は 4〜13 秒
- 同じ長文でも、モデルによって入力のトークン数が 2,443〜3,796 と違う。トークナイザがクロアチア語をどれだけ短く表せるかの差で、クロアチア語専用に作った自作のトークナイザが一番短い
速さと正確さを並べると
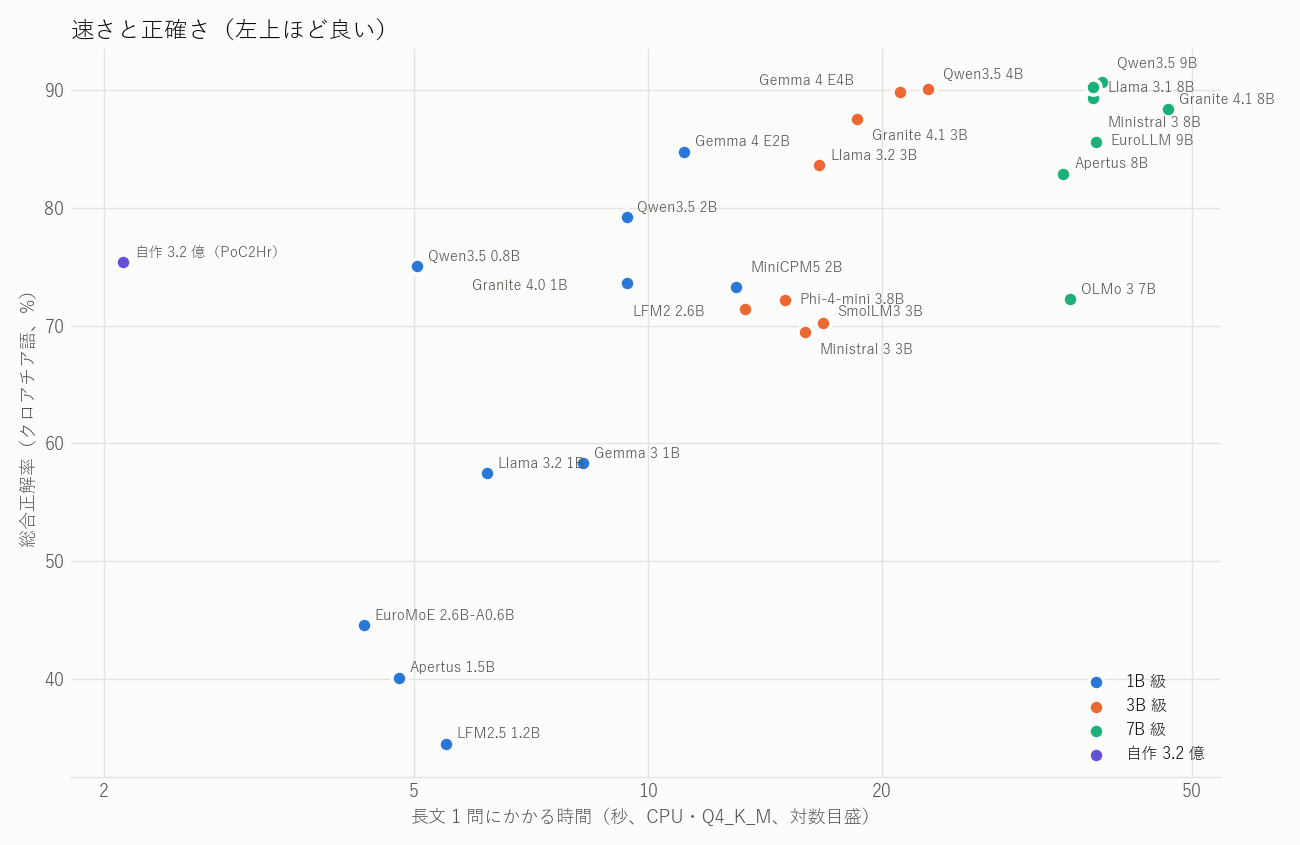
左上ほど「速くて正確」。
- バランスが良いのは Gemma 4 E2B(11 秒・85%)と Qwen3.5 2B(9 秒・79%)
- 正確さを取るなら Qwen3.5 4B か Gemma 4 E4B(21〜23 秒・90%)。7B 級より 1.5 倍以上速くて、正確さはほぼ同じ
- 自作の 3.2 億は速さが別格(2.1 秒)。 総合正解率 75% は Qwen3.5 0.8B と同じで、でっち上げの少なさは上位モデル並み。ただ長文の正解率は 46% で、Qwen3.5 0.8B(75%)や Gemma 4 E2B(88%)より明らかに弱い
- 自作モデルは英語を学習していないので、英語では答えのない長文の 91% で答えをでっち上げた
注意点
- 採点は LLM なので完璧ではない。少し甘めの採点になっている
- 英語版は機械翻訳。質問を作ったのも英訳したのも EuroLLM-9B なので、EuroLLM には少し有利かもしれない(結果は 86% で中くらい)
- Apertus 1.5B は扱える文脈が 4,096 トークンまでで、クロアチア語の長文の 23% が入らなかった。入らなかった分は不正解として数えている
- 正確さは GPU(vLLM、7B 級は FP8)、速さは CPU(Q4_K_M)で、測った環境が違う。量子化で正確さが少し変わる可能性はある
- 速さは、普段使っているアプリを開いたままの PC で測った。全モデルを同じ条件で続けて測っているので、比べるのには使えると思う
考察
- RAG 用途なら、もう 4B で十分。 3〜4B 級の上位は 7〜9B 級と同じくらい正確で、CPU では 1.5〜2 倍速い
- モデル選びでは「断れるか」を必ず見たほうがいい。 正解率が同じくらいでも、答えのない文章ででっち上げる割合はモデルによって 1% から 99% までばらばら。RAG では検索で関係ない文章を拾うことがよくあるので、ここが一番効く
- 同じモデルでも言語によって性格が変わる。 英語では慎重すぎて答えを逃すモデルが多かった。使う言語で実際に試さないとわからない
- 自作モデルの課題は長文。 断る力と速さは十分で、長文の正解率が上がれば「CPU で動く RAG モデル」としてかなり使えるはず。次はここを改善したい
追記:RAG 専用モデルも試してみた
「RAG 専用にチューニングされたモデルってどうなの?」と思ったので、小さい RAG 専用モデルを 3 つ追加で試した。条件は上と同じ(同じ 260 問、同じ採点)。
- LFM2-1.2B-RAG(Liquid AI):LFM2-1.2B を、文書を渡して答える例 100 万件以上で追加学習したもの。対応言語は英語・日本語など 9 言語で、クロアチア語は入っていない
- Pleias-RAG-1B / Pleias-RAG-350M(PleIAs):RAG の合成データ約 310 万件で学習したモデル。答えの前に「質問の分析 → 資料の分析 → 下書き」を書いてから答え、答えには本文からの引用を付ける。対応言語はヨーロッパの 7 言語で、クロアチア語は入っていない。扱える文脈は 4,096 トークンまで
- 比べるために、LFM2-1.2B-RAG の元になった素の LFM2-1.2B も測った
LFM2-1.2B-RAG には他のモデルと同じ指示を渡した。Pleias は専用の入力形式(質問と資料を専用の記号で区切る)しか受け付けないので、公式ライブラリと同じ形式で渡して、最後の答えの部分だけを採点した。そのため Pleias には「答えがなければこう答えて」という指示は渡せていない。
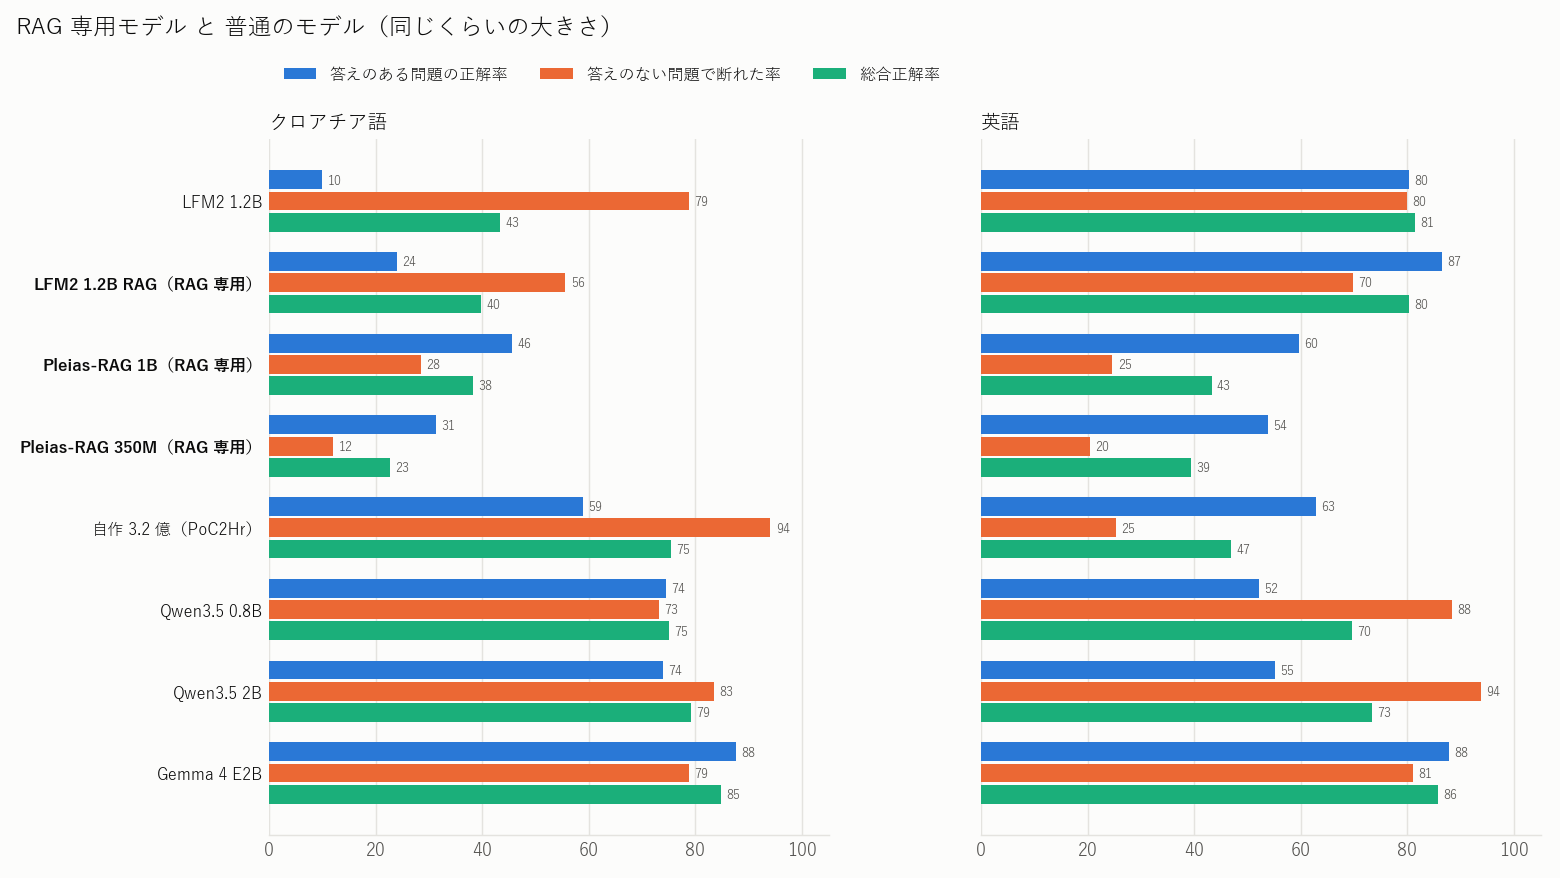
| モデル | 総合(クロアチア語) | 総合(英語) | 答えのない長文でのでっち上げ(クロアチア語 / 英語) | 長文 1 問の時間(CPU) |
|---|---|---|---|---|
| LFM2 1.2B(元のモデル) | 43% | 81% | 42% / 36% | 7.8 秒 |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8.1 秒 |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16.9 秒 |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6.0 秒 |
| 参考:自作 3.2 億 | 75% | 47% | 9% / 91% | 2.1 秒 |
| 参考:Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5.1 秒 |
| 参考:Gemma 4 E2B | 85% | 86% | 37% / 32% | 11.1 秒 |
結論から言うと、今回の問題では RAG 専用モデルが普通のモデルより良いところは見つからなかった。
LFM2-1.2B-RAG:答えるようにはなったけど、でっち上げも増えた
英語で元の LFM2-1.2B と比べると、答えのある問題の正解率は上がった(段落 83% → 87%、長文 78% → 86%)。でも答えのない文章でのでっち上げも増えて(段落 4% → 10%、長文 36% → 51%)、総合は 81% → 80% でほぼ同じ。RAG 用の追加学習で「とにかく答える」方向に寄ったように見える。
クロアチア語は元のモデルの時点でほぼ使えない。元の LFM2-1.2B は答えのある段落の 93% を「答えはありません」と断ったし、RAG 版は「Odgovori kratko, jednom rečenicom.(1 文で短く答えて)」と指示文をそのまま返すような答えが目立った。対応言語に入っていないので、これは仕方ない。
Pleias-RAG:引用を付けるけど、その引用が本文にない
Pleias は答えのない文章でもほとんど断らなかった。英語だと、答えのない段落の 78%、答えのない長文の 73% で答えを作った(1B)。
売りの「引用付きの答え」も怪しい。引用の文が本文にそのまま見つかった割合を数えてみた(空白の違いだけ無視した完全一致なので、少し言い換えた引用も「見つからない」に入る)。
| 答えのある問題 | 答えのない問題 | |
|---|---|---|
| Pleias-RAG 1B(英語) | 64% | 42% |
| Pleias-RAG 1B(クロアチア語) | 57% | 53% |
| Pleias-RAG 350M(英語) | 66% | 39% |
| Pleias-RAG 350M(クロアチア語) | 52% | 40% |
たとえば「Tourniquet という曲を最初に書いたバンドは?」(答えは Soul Embraced)。
- 答えの入っていない段落を渡すと、1B は「Amy Lee が書いた」と答えて、「Amy Lee (born Amy Leigh Lee, November 1, 1970) ...」という本文にない文を引用として付けた
- 答えの入っている段落を渡しても「Amy Lee が書いた」と答えた。しかも付けた引用は「originally written ... for the Christian death metal band Soul Embraced」で、引用は正しいのに答えがそれと食い違っている
引用があると「ちゃんと本文に基づいている」ように見えるので、むしろ危ない。
速さの面でも、Pleias は答えの前に分析を書くので回答が長い(長文で平均 381〜420 トークン)。1B は長文 1 問に 16.9 秒かかって、Gemma 4 E2B(11.1 秒)より遅い。しかもクロアチア語の長文の 25% は文脈に入らなかった(不正解として数えた。時間は入った問題だけの平均なので、実際はもう少しかかる)。
なんでこうなった?(推測)
- 言語:3 つともクロアチア語は対応言語に入っていない。ただ英語でも普通のモデルに負けている
- 問題の形:今回は「1 つの文章から短く答える/答えがなければ断る」問題。Pleias は複数の資料を組み合わせて答える問題(HotpotQA など)で評価されていて、得意な形が違うのかもしれない
- 断り方:普通のモデルには「答えがなければこう答えて」と指示できるけど、Pleias には指示を渡す場所がない。モデル自身は「この資料では答えられない」と判断する仕組みを持っているけど、今回はあまり働かなかった
追記のまとめ
- 「RAG 専用」という名前だけで選ばないほうがいい。 今回の条件では、Gemma 4 E2B や Qwen3.5 のような普通の指示モデルのほうが正確で、断るべきときに断れた
- 引用付きの答えは、引用そのものを確かめないと意味がない。 Pleias の引用は 4〜7 割しか本文にそのまま見つからなかった
- 自作モデルは同じくらいの大きさの RAG 専用モデルより上。 Pleias-RAG 350M と比べると、クロアチア語の総合は 75% と 23%、長文 1 問の時間は 2.1 秒と 6.0 秒。クロアチア語専用で作った意味はあった
追加した 4 モデルの速さは、同じ日の夜に同じ PC・同じ条件で測った。速さと正確さの図にも追加した。
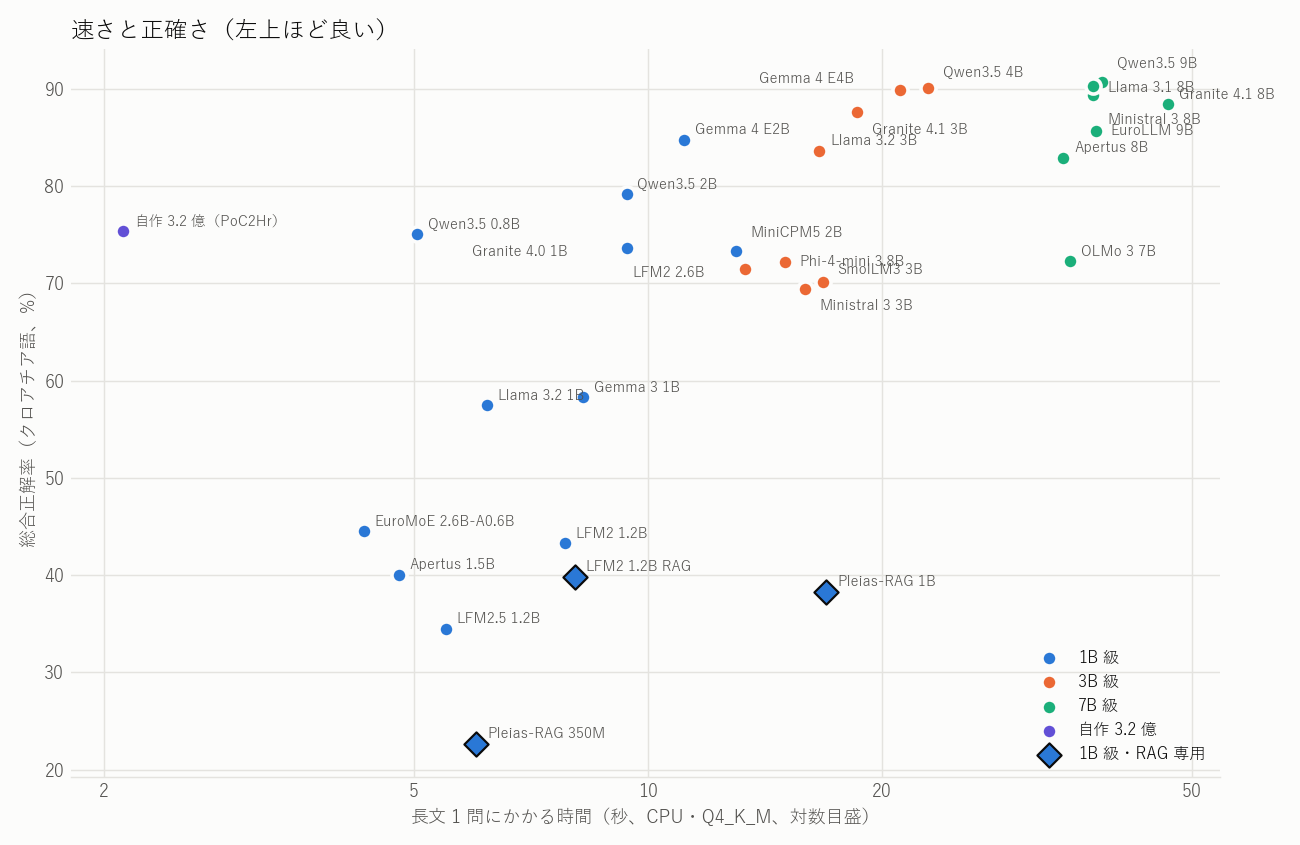
全結果
クロアチア語
| モデル | 階級 | 段落 正解 | 長文 正解 | 総合 | 答えなしでのでっち上げ(段落/長文) | 答えた中で正しい割合 |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | 7B 級 | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | 7B 級 | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | 3B 級 | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | 3B 級 | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | 7B 級 | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | 7B 級 | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | 3B 級 | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | 7B 級 | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | 1B 級 | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | 3B 級 | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | 7B 級 | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | 1B 級 | 74% | 74% | 79% | 4% / 29% | 79% |
| 自作 3.2 億 | 自作 | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | 1B 級 | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | 1B 級 | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | 1B 級 | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | 7B 級 | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | 3B 級 | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | 3B 級 | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | 3B 級 | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | 3B 級 | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | 1B 級 | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | 1B 級 | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | 1B 級 | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | 1B 級 | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | 1B 級 | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | 1B 級・RAG 専用 | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | 1B 級・RAG 専用 | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | 1B 級 | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | 1B 級・RAG 専用 | 54% | 9% | 23% | 85% / 68% | 21% |
英語
| モデル | 階級 | 段落 正解 | 長文 正解 | 総合 | 答えなしでのでっち上げ(段落/長文) | 答えた中で正しい割合 |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | 3B 級 | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | 7B 級 | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | 1B 級 | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | 7B 級 | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | 3B 級 | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | 3B 級 | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | 3B 級 | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | 7B 級 | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | 1B 級 | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | 7B 級 | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | 3B 級 | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | 7B 級 | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | 3B 級 | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | 1B 級 | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | 1B 級・RAG 専用 | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | 3B 級 | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | 7B 級 | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | 1B 級 | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | 7B 級 | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | 1B 級 | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | 1B 級 | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | 3B 級 | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | 1B 級 | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | 1B 級 | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | 1B 級 | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | 1B 級 | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | 1B 級 | 89% | 79% | 48% | 93% / 97% | 47% |
| 自作 3.2 億 | 自作 | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | 1B 級・RAG 専用 | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | 1B 級・RAG 専用 | 63% | 44% | 39% | 67% / 92% | 34% |
CPU での速さ(i7-13700K・llama.cpp Q4_K_M)
| モデル | サイズ | 生成(トークン/秒) | 読み込み(トークン/秒) | 長文の入力トークン数 | 長文 1 問の時間 |
|---|---|---|---|---|---|
| 自作 3.2 億 | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 秒 |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 秒 |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 秒 |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 秒 |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 秒 |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 秒 |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 秒 |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 秒 |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 秒 |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 秒 |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 秒 |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 秒 |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 秒 |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 秒 |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 秒 |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 秒 |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 秒 |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 秒 |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 秒 |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 秒 |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 秒 |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 秒 |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 秒 |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 秒 |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 秒 |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 秒 |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 秒 |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 秒 |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 秒 |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 秒 |
※ Apertus 1.5B と Pleias-RAG は、文脈 4,096 トークンに入った長文だけの平均。