Image and Video Generation AI News — 2026-09-20
オープンソース(特にQwen・Wan・MiniMax-H3など中国発モデル)がクローズドソースの無料枠切れの受け皿として急速に存在感を強める一方、Xステージは無関係な検索語のせいでデータが取れず、この回の裏付けは実質5プラットフォーム分にとどまる。
画像・動画生成AIニュースまとめ 〜クローズド vs オープンソース〜 — 2026-09-20
ういーっす!今回はReddit・X・YouTube・Bluesky・Lemmy・Pinterestの6プラットフォームを爆速でチェックしてきたぞ🔥🔥 結論から言うと、クローズドソース陣営(Google Veo/Nano Banana、Sora 2、Midjourney、Kling、Seedanceあたり)は相変わらずニュースの主役で「音声同期」がガチで標準機能になりつつあるんだけど、オープンソース陣営(特に中国勢のQwen・Wan・MiniMax-H3)がマジで猛スピードで追い上げてて、無料枠が切れたユーザーの「逃げ場」として存在感バリバリなんよね🚀 あと地味に大事なのが、AI生成物への反発(バックラッシュ)がAIオタクのコミュニティより一般人の集まる場所の方でデカくなってるってこと😤。ただし正直に言うと、Xステージは完全に空振りだったので、その分このレポートの土台は5プラットフォーム分って感じ🙏
Across platforms
- オープンソース勢の勢いがマジで止まらない:Reddit(Wan、Minimax H3、Krea2がクローズドの無料枠切れの後の避難先として複数スレで名前が挙がってる)、Lemmy(
!stable_diffusionコミュニティでMiniMax-H3向けComfyUIツールが9月だけで15件以上投稿ラッシュ)、YouTube(Qwen-Image→Qwen-Image-2512→Z-Image、Wan 2.5→2.6→2.7がほぼ月次で更新)でめちゃくちゃ一致してる。もう「オープンソース=タダで高品質」がデファクトになりつつある感じ💪 - クローズド動画生成は「音付き」が当たり前化:Bluesky(Replicateが告知してるKling 3.0の同期音声、Seedance 2.0の音声・動画統合)とYouTube(Grok Imagine 1.5がセリフと環境音を同時生成って紹介されてる)で同じ流れが確認できた🎬🔊
- GoogleのVeo/Nano Banana系がクローズドの「顔」になってる:Pinterest(Veoの温かみあるピクサー風映像が繰り返しバズ画像として使われてる)、YouTube(Theo - t3.ggが「Google won image generation」って断言)、Reddit(Google Flowの無料枠拡充が話題)で三重に確認できたのはデカい👀
- AI生成物への反発が「AI好き」の外側で爆発してる:Reddit(ArtPrizeがAI作品を認めたことへの怒り354pt、職場でAI画像量産ノルマへの悲鳴63pt)、Lemmy(反AIコミュニティ
!fuck_aiが月次アクティブ9,179人でLemmy最大級)、Pinterest(「Real vs AI」の真贋当てクイズが独立したジャンルとして定着)が全部同じ空気を伝えてきた😨 - 一次情報は企業公式より「個人」経由が主流:Blueskyは企業公式アカウントがほぼ沈黙してて個人研究者(Simon Willisonら)とReplicateのようなホスティング業者が情報源。YouTubeも個人チャンネルの週刊まとめ(AIPOD-CAST、Lev Selector)がニュース源になってる。企業公式が一次発信してるチャンネルが少ないのは共通の傾向っぽい📢
Platform by platform
Reddit:9つのサブレディットから12スレッドを収集(目標の20件には届かず)。オープンソース(Wan、Minimax H3、Krea2)がクローズドの無料枠切れの逃げ場になってるって話が複数スレで繰り返し出てきた一方、GPT Image 2.5 Flareの評価は「incredible」派と「Krea2と同じじゃん」派で真っ二つ😂 一番アツかったのはAI技術系のサブより一般コミュニティ(ArtPrize反発354pt)や実務系サブ(デザイナーの悲鳴63pt)の方だったのが意外ポイント。
X:正直これは完全に事故った🙈 収集された40投稿は「Greenland」「#Bitcoin」「Chelsea」みたいな接続元(クロアチア周辺)の一般トレンド語を検索しただけで、画像・動画生成AIに関する投稿はゼロ件。なのでXからは今回クローズド/オープンどちらの気づきも1つも出せなかった。これはブリーフが名指ししたプラットフォームでの明確な穴🕳️
YouTube:12本の動画をチェック。クローズド勢(Theo、Astrovah、Woollyfern=Midjourney月次アプデ専門、FixNode)とオープンソース勢(Bijan Bowen、HitPaw、MaxonShire、Promptus AI)がきれいに住み分けてて、オープン側は「ComfyUI」「ローカル実行」「無料」を推してるのに対しクローズド側は品質・機能推し。ただし検索結果ページがJS依存すぎて再生数やチャンネル登録者数がほぼ取れなかったのは痛い😅
Bluesky:公式検索APIが403でブロックされまくってたので、個人研究者(Simon Willison、Max Woolf、Ethan Mollick)とReplicate公式の投稿を辿る形に切り替え。結果、拾えた投稿はほぼ全部クローズドソース(GPT Image 2、Runway Gen-4.5、Kling 3.0、Seedance 2.0、Vidu Q3)で、オープンソース系の現役コミュニティアカウントは見つからず(唯一それらしいアカウントも2025年2月で活動停止)。ペリカンが自転車に乗る画像がモデル比較のお約束ネタになってるのも面白かった🐦🚲
Lemmy:オープン/クローズドがくっきり分かれてて一番バランス良かった印象。オープン側は!stable_diffusionコミュニティのMiniMax-H3ラッシュと新モデルBoogu-Image-0.1(Apache-2.0、100億パラメータ)、クローズド側はGoogleのNano Banana 2 Lite、MicrosoftのMAI-Image-2.5、Sora 2の長編ストーリー実験、そしてMidjourneyの「医療スパへピボット」というビックリニュース😲 反AIコミュニティ!fuck_ai(8,252人)の存在感もLemmyならではの発見。
Pinterest:ワーカーが事前収集した50件のピンのうち30件を画像込みで確認する形式。クローズドソースのツール紹介リストや使い回しの「AI NEWS」サムネテンプレが量産されてる一方、オープンソースの気配はほぼゼロ(唯一Amuse 3.0というローカルツールが1件だけ)。GoogleのVeoの映像がやたら使い回されてるのと、「これAI?本物?」の真贋クイズがジャンル化してるのが目立った🎨
What to watch
- MiniMax-H3向けComfyUIツールの急増(Lemmy
!stable_diffusion、例: https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS)— オープンソース動画生成の新しい主役候補🔥 - Sora 2の「production memory」問題(Lemmy経由Reddit、https://lemmy.durstig.online/post/59922)— 単発クリップより長編の一貫性維持が次の壁になりそう
- Google Nano Banana Proの独走説(YouTube・Theo - t3.gg、https://www.youtube.com/watch?v=UV9GqinedQ8)— 「Photoshop不要」レベルってマジ?続報待ち
- GPT Image 2.5 Flare vs オープンソースKrea2論争(Reddit、https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/)— 有料版の優位性そのものが疑われ始めてる
- ArtPrizeのAI作品受け入れ問題(Reddit r/grandrapids、https://www.reddit.com/r/grandrapids/comments/1wi4ub0/)— 一般社会での受容ラインを測る指標になりそう
- Midjourneyの医療スパ転身&ハリウッド開示要求(Lemmy、https://lemmy.zip/post/66397234 、https://lemmy.today/post/56011946)— 企業としての信頼性リスクが出てきてる
Recommendations
- Xステージは"Sora 2""Midjourney""Stable Diffusion""Runway Gen""Kling AI""open source image generation"みたいなテーマ直結の検索語で再収集すること。
- MiniMax-H3・Qwen・Wan・Z-Imageあたりの中国発オープンソース勢のリリース頻度を毎回ウォッチリストに入れること。
- AI専門サブより一般コミュニティ・実務系コミュニティの反応も継続的に追うこと(バックラッシュのシグナルが強いため)。
- Bluesky公式検索API(403問題)の回避策を次回までに検証しておくこと。
- Sora 2の「production memory」問題とMidjourneyの医療スパ転身は次回runでも続報を追うこと。
- Pinterestの収集はジャンルタグ付きで行い、オープン/クローズドを機械的に仕分けできるようにすること。
Data quality
Xステージは検索語がテーマと無関係(地政学・仮想通貨・サッカーなど)だったため、収集した40投稿中テーマ関連は0件で、実質的に使えるデータがなかった。Reddit(12件)とBluesky(検索API遮断のため個人アカウント経由で約12件抽出)は、ブリーフの「各プラットフォーム約20件」という完了基準に届いていない。PinterestとYouTubeも一部制約あり(Pinterestはジャンルタグ未付与で live browsing なし、YouTubeは再生数・登録者数がJS依存で取得不可)だが、要旨としては十分な情報が取れている。LemmyとYouTubeは比較的手堅く、オープン/クローズドの両方に具体的な気づきを提供できた。
プラットフォーム別まとめ
Reddit — Image and Video Generation AI News
Where
収集された12スレッドは9つのサブレディットから。
| サブレディット | メンバー数 | 収集スレッド数 |
|---|---|---|
| r/generativeAI | 154,961 | 4 |
| r/graphic_design | 2,929,382 | 1 |
| r/GeminiAI | 375,783 | 1 |
| r/grandrapids | 161,719 | 1 |
| r/aitubers | 28,785 | 1 |
| r/ImagineAiArt | 19,335 | 1 |
| r/AIToolTalks | 6,757 | 1 |
| r/aifilmmaking | 8,200 | 1 |
| r/aivideomaking | 7,267 | 1 |
r/generativeAI がAI画像・動画生成そのものを扱う中心的なハブ(4件)。r/GeminiAI と r/ImagineAiArt はクローズドソースのモデル体験談、r/aifilmmaking と r/aivideomaking は動画制作の実務目線、r/grandrapids と r/graphic_design はAI生成物が実社会(アートコンペ、職場)にぶつかったときの反応、r/AIToolTalks はAI全般への不安の受け皿になっている。
What people say
- スレッド1「Which AI video generator can still be used for free?」(r/generativeAI・18pt・57コメント・2026-09-16) https://www.reddit.com/r/generativeAI/comments/1whtesl/ — オープンソース/ローカル生成(Wan、Minimax)がクローズドソースの無料枠が枯渇した後の逃げ場になっている。u/RioMetal「If you can go local you have plenty of them, like Wan or Minimax」
- スレッド2「GPT Image 2.5 Flare — is this actually the best AI image generating model right now?」(r/ImagineAiArt・84pt・60コメント・2026-09-16) https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/ — 評価が真っ二つ。u/oldboi777は「incredible upgrade」と絶賛する一方、u/SeaworthinessFresh16は「The result in Comfyui with Krea2 looks the same」とオープンソースのKrea2と大差ないと指摘。
- スレッド12「Need a good video generation AI for image to video of people」(r/generativeAI・0pt・22コメント・2026-09-15) https://www.reddit.com/r/generativeAI/comments/1wh1y9d/ — クローズドソース(Google Flow / Nano Banana Pro)の検閲フィルターへの不満が投稿の主旨。u/f5alcon「Minimax H3 is the best local generator」、u/jworm0624「Krea 2 turbo for images, minimax h3 for videos. All on comfyui」とオープンソース勢が代替として推される。
- スレッド7「Google Flow is giving creators a surprisingly generous amount of free AI video generation right now」(r/aifilmmaking・8pt・7コメント・2026-09-14) https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — クローズドソースのGoogle Flow/Veoが無料クレジットを拡充し、単なるテキスト動画生成から「シーン構築・カメラ制御・素材参照ができる制作ワークスペース」に進化中。ただしu/MrBoondoggles「I'm not surprised Google is giving away Veo at this point... trying to maintain some interest in their product」と冷めた見方も。
- スレッド8「Did Anyone Notice Sudden Quality Drop of Image Generation? From 2 MB to 500 KB」(r/GeminiAI・10pt・25コメント・2026-09-17) https://www.reddit.com/r/GeminiAI/comments/1wj02p4/ — クローズドソース(Gemini)で画質劣化(PNG→JPEG、8MB→2MB→500KB)が報告され、有料プランのユーザーからも苦情。u/Well_HellooF「there's no difference in quality between the free version and the paid one. suck」
- スレッド5「ArtPrize Allows Generative AI」(r/grandrapids・354pt・176コメント・2026-09-16) https://www.reddit.com/r/grandrapids/comments/1wi4ub0/ — AI生成作品をアートコンペが受け入れたことへの強い反発。u/Chirotera(319pt)「Fucking disgusting. It is not AI "Art," it's fucking theft.」。技術系サブより一般コミュニティの怒りの方が大きい。
- スレッド10「Company expects us to generate 500 AI images PER WEEK. Is this realistic?」(r/graphic_design・63pt・133コメント・2026-09-17) https://www.reddit.com/r/graphic_design/comments/1wieke2/ — 現場のデザイナーがクローズドソースツール(ChatGPT)を使った量産ノルマに悲鳴。u/Diligent-Educator409(123pt)「500 AI images? Yes. 500 good AI images? No. 1 good AI image? Also no.」
- スレッド9「best apps for generating AI videos」(r/aitubers・0pt・46コメント・2026-09-14) https://www.reddit.com/r/aitubers/comments/1wg3duk/ — 台本から全自動で動画を作るクローズドソース系ツール(InVideo AI、Steve AI等)への需要はあるが、コミュニティの反応は冷たい。u/RobJames007(15pt)「Youtube is trying to reduce AI slop, not allow more of it onto the platform.」
- スレッド3「Please help me generate free ai video without subscription」(r/aivideomaking・0pt・20コメント・2026-09-15) https://www.reddit.com/r/aivideomaking/comments/1wh80z3/ — u/Chance-Business「google flow you get 50 free credits per day, each vid is 6-12 credits」とu/Bastisheen92「Local Generation is free if you already own the Hardware」がクローズドソースの無料枠 vs オープンソースのローカル実行という定番の対比を再現。
- スレッド11「Are all of you also anxious about recent news about AI?」(r/AIToolTalks・12pt・36コメント・2026-09-13) https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — 画像・動画生成そのものではなく、AI全般の水資源消費・雇用喪失・規制への不安が語られ、コメント欄では賛否が真っ向対立(u/Big-Pops78が水資源懸念を相対化する一方、u/UnburyingBeetleが「cost efficiency」という言葉への皮肉で反論)。
Signals
- 上昇傾向: Wan、Minimax H3、LTX Video、Krea2といったオープンソース/ローカルモデル名が、独立した複数スレッド(1、2、12)で同じ文脈(クローズドソースの無料枠が尽きた後の代替)で繰り返し挙がっている。ローカル生成が「タダで高品質」の代名詞になりつつある。
- 軽視・冷笑されている: クローズドソースの「無料」を謳う動画生成サービスへの皮肉が濃い。複数スレッド(1、4、6、12)にボットアカウントu/Jenna_AIが同工異曲の「無料をうたうが結局課金させられる」という長文皮肉コメントを投稿しており、コミュニティのシニカルな空気を象徴している。
- 意外だった点: 技術系サブレディットよりも一般コミュニティ(r/grandrapids、354pt・176コメント)や実務系サブ(r/graphic_design、63pt・133コメント)の方が、AI技術系サブ(r/generativeAI等、多くが1桁〜数十pt)よりもエンゲージメントもスコアも高い。AI生成物が「日常や仕事にぶつかったとき」の方が反発・議論が大きくなっている。
- 意見の対立: スレッド2のGPT Image 2.5 Flareは「incredible upgrade」(u/oldboi777)と「Krea2と同じ結果」(u/SeaworthinessFresh16)で真逆の評価。スレッド7でもGoogle Flow/Veoについて「free credits are generous」という好意的な声と「it's weak at physics and logic. Even Minimax is far better」(u/Sea-Temporary-6995)という否定的な声が同居している。
Limits
- 収集されたスレッドは12件で、ブリーフの完了基準(各プラットフォームで約20件の投稿を解析)に届いていない。ワーカーが集めた12件がRedditについて手元にある全データであり、本ステージではこれ以上Redditを検索・閲覧できない(プレイブックの指示によりブラウジング不可)。
- 検索語は英語の "Image and Video Generation AI News" 一本のみで、日本語のクエリや「オープンソース」「クローズドソース」といった観点別の検索語は試されていない形跡がある。
- r/aitubers、r/aivideomaking、r/AIToolTalksなど一部サブレディットは1スレッドのみの収集で、そのサブ内での傾向の強弱は判断できない。
X
X — 画像・動画生成AI(クローズド/オープンソース)ニュース
Accounts
今回 output/x.posts.md に集められた39アカウント・40投稿は、すべて画像/動画生成AIとは無関係。検索語が "Greenland" "Denmark" "#Bitcoin" "NATO" "Christ" "Jubjub" "Charles" "Bosnia" "Chelsea" "Belgrade" の10語で、これはX自身のExploreトレンド(サーバーの接続元=クロアチア周辺にジオロケートされたもの)からそのまま取られた一般トレンド語であり、リサーチブリーフ(画像・動画生成AIのニュース)に紐づく検索語が一つも含まれていない。
そのため「このテーマをXで誰が牽引しているか」を答えられるアカウントは今回のデータの中に存在しない。代わりに何が集まったかだけ記す:
- 政治/地政学クラスタ:@RapidResponse47(30,291いいね、グリーンランド関連)、@AJENews、@Rusia_HD、@Globalsurv、@NepCorres など、グリーンランド・デンマーク・NATOがらみの速報/意見ポスト。
- 仮想通貨クラスタ:@aacryptoverse、@Bitcoin_Pirate_、@StackandRun、@bitcr_org など、#Bitcoinタグのポスト(いずれもいいね数は一桁〜数十件と小規模)。
- 王室ゴシップクラスタ:@barristerlawusa、@hernandez_64876、@thebluestshade、@Rimmesfk("Charles" = チャールズ・スペンサーの暴露本の話題)。
- サッカークラスタ:@icunga_、@john322226、@Cfc_Kemboi、@Pats_Aura("Chelsea" はチェルシーFCの試合結果)。
- ミーム/雑談クラスタ:@SardineKing_O、@isellbeforeyou、@0xHeatt("$jubjub" という仮想通貨系ミームコインの話)、@MarquiseDeBelgr(セルビア語の雑談ポスト2件)。
いずれも1アカウントにつき1〜2投稿で、突出した連投アカウントはない。@RapidResponse47の1投稿(3万いいね・~680万ビュー)が今回の集合の中では突出して大きいが、内容はグリーンランド帰属問題であり本テーマと無関係。
Posts
画像・動画生成AI(クローズドソース/オープンソース)に言及する投稿は、収集された40件中0件。したがって「代表する投稿」として提示できるものがない。参考までに、収集内容の性質を示す最大エンゲージメント投稿を1つだけ挙げる(テーマとは無関係である旨を明記):
- @RapidResponse47(テーマ外・参考) — 30,291 likes・5,022 reposts・1,164 replies・約6,800,000 views・2026-09-18。https://x.com/RapidResponse47/status/2101059494587285834 "Greenland" 検索でヒット。内容はグリーンランドの帰属を巡る政治的投稿で、AI生成画像・動画とは無関係。
Signals
- 今回のXステージでは、画像・動画生成AI(Midjourney、Sora、Runway、Stable Diffusion、Flux、Wan、Kling等)に関する言及・議論・ニュースは収集データ中に一切確認できなかった。「話題になっている/されていない」を判定する材料自体が存在しない。
- 収集に使われた検索語(Greenland, Denmark, #Bitcoin, NATO, Christ, Jubjub, Charles, Bosnia, Chelsea, Belgrade)は、
output/x.posts.md冒頭の「X's own Explore list」の見出し語と完全に一致しており、地政学ニュース・王室ゴシップ・サッカー・仮想通貨ミームといった、このセッションの接続元(クロアチア周辺)でのX全体トレンドをそのまま検索しただけと見える。テーマに沿った検索語(画像生成AI、動画生成AI、Sora、Midjourney、Stable Diffusion、オープンソースAIなど)は一度も使われていない。 - そのためこのステージからは「クローズドソースの動向」「オープンソースの動向」いずれについても、気づきを1件も抽出できない。
Limits
- 収集そのものがテーマに一致していない。
output/x.posts.mdが使った検索語10個はいずれも画像・動画生成AIに関係せず、地政学・王室ゴシップ・サッカー・仮想通貨ミームのExploreトレンドをなぞったもの。ワーカーがテーマ(クローズド/オープンソースの画像・動画生成AIニュース)に沿った検索を一度も行っていないため、Xステージの完了基準(約20件の投稿を解析してまとめる)は「テーマに関する投稿」という意味では満たせていない。 - 40件の投稿は解析したが、画像・動画生成AIに言及する投稿はゼロ件だった。
output/x.posts.jsonも同一データのため、追加の手がかりはなかった。- このrunのXステージの結果として言えるのは「収集された検索語・投稿からは、画像・動画生成AIに関するクローズドソース/オープンソースいずれの動向についても、Xからの気づきを報告できない」という点のみ。テーマに沿った再収集(例:"Sora 2", "Midjourney", "Stable Diffusion", "Runway Gen", "Kling AI", "Flux", "open source image generation" などの検索語)が必要。
YouTube
YouTube — 画像・動画生成AI(クローズドソース/オープンソース)の最新動向
チャンネル
クローズドソース寄り
- Theo - t3.gg(@t3dotgg)— Google Nano Banana Proの技術解説
- Astrovah(@astrovah)— Sora 2のレビュー・活用事例
- Woollyfern(@woollyferncreative)— Midjourney月次アップデート専門チャンネル
- FixNode(@Fixnode1)— Runway Gen-4.5チュートリアル
- Higher E-Learning(@higherelearning)— Adobe Firefly統合モデルの検証
- AIPOD-CAST(@AIPOD-CAST)— 週刊AIニュースまとめ(Episode 220番台)
- Lev Selector(@lev-selector)— 週刊AIアップデートまとめ
オープンソース寄り
- Bijan Bowen(@Bijanbowen)— Qwen Imageのローカルテスト系
- HitPaw Edimakor(@HitPawEdimakorOfficial)— Wanシリーズのレビュー・使い方
- MaxonShire(@MaxonShire)— オープンソース動画モデルの比較検証
- Promptus AI(@promptusai)— Z-Imageなど新モデルのローカル導入ガイド
- 黎黎原上啃 / SweetValberry(@SweetValberry)— FLUX.1 Kontextなど中国語圏の解説
登録者数はいずれのチャンネルページでも数値が取得できず(下記Limits参照)、規模感は確認できていない。
動画
-
「Google won image generation (it's not even close) NANO BANANA PRO BREAKDOWN」 — Theo - t3.gg/公開時期不明(Nano Banana Pro自体は2025年11月20日発表、動画はそれ以降)/再生数不明
https://www.youtube.com/watch?v=UV9GqinedQ8
Gemini 3 Pro基盤のNano Banana Proの画像生成品質が「Photoshop不要」レベルで、クローズドソース勢の中でも頭一つ抜けていると主張。 -
「Sora 2 - An Honest Review As Well As 20 Creative Use Cases To Try」 — Astrovah/2025年10月7日/再生数不明
https://www.youtube.com/watch?v=pJHWIgri5vk
Sora 2を「これまでで最もリアルなAI動画」と評価し、実務での使い道を20パターン紹介。 -
「Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI Style Creator, and More!」 — Woollyfern/2026年7月/再生数不明
https://www.youtube.com/watch?v=dvfH5HzCARY
Midjourney V8.2でパーソナライゼーション機能とNIJI用スタイルクリエイターが追加されたと解説。月次シリーズの直近回。 -
「I Tested Every AI Video Model in Adobe Firefly So You Don't Have To (July 2026)」 — Higher E-Learning/2026年7月/再生数不明
https://www.youtube.com/watch?v=nOSYufWVdq8
Adobe FireflyにVeo 3.1・Kling 3.0・Runway Gen-4.5・Sora 2まで統合されたことを受け、全モデルを横並びで検証。 -
「Ultimate Runway Gen 4.5 Tutorial For New Users in 2026」 — FixNode/2026年3月29日/再生数不明
https://www.youtube.com/watch?v=IUge3u4ZrqQ
Runway Gen-4.5の画像→動画生成をチュートリアル形式で解説、シネマティックな質感を強調。 -
「Episode 222: Weekly AI News Summary - 6 September 2026」 — AIPOD-CAST/2026年9月6日/再生数不明
https://www.youtube.com/watch?v=8f34nSLdNtk
モデル・エージェント・ビジネス動向を横断する週刊まとめの中で画像/動画生成AIのニュースにも言及。 -
「Exciting AI Updates Weekly - September 18, 2026」 — Lev Selector/2026年9月18日/再生数不明
https://www.youtube.com/watch?v=Utu4zIcqPtM
直近1週間のAI関連アップデートを個人チャンネルが速報的にまとめたもの。今回の調査範囲で最も新しい投稿。 -
「Qwen Image-2512 First Test – The BEST Open Source Image Model!」 — Bijan Bowen/公開時期不明(モデル自体は2025年12月版)/再生数不明
https://www.youtube.com/watch?v=SBaK616nP6Q
AlibabaのQwen-Image-2512(200億パラメータ)を実際にローカルでテストし、「現状最強のオープンソース画像モデル」と評価。 -
「Wan 2.6 Review | How to Use Wan 2.6 for Free | New AI Video Generator Tutorial」 — HitPaw Edimakor/公開時期不明(モデルは2025年12月リリース)/再生数不明
https://www.youtube.com/watch?v=6FMisTHYYgA
Alibaba Wan 2.6の無料での使い方とレビュー。T2V/I2V/R2Vなど複数モードに言及。 -
「HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model?」 — MaxonShire/2026年6月25日/再生数不明
https://www.youtube.com/watch?v=4GNT4-QYekg
Tencent HunyuanVideo 1.5とAlibaba Wan 2.7(2026年4月22日リリース)という2大無料ローカル動画モデルを直接比較。 -
「Z-Image Open-Source Image Generator: Free Online and Local Setup」 — Promptus AI/2026年(時期詳細不明)/再生数不明
https://www.youtube.com/watch?v=JF4Q5hXh-_Q
AlibabaのZ-Image(60億パラメータ、S3-DiT構造)が軽量ながらFlux 2やQwen Imageを上回る画質と紹介、ComfyUI連携も解説。 -
「FLUX.1 Kontext [dev] is open source! Try image editing locally in ComfyUI」 — 黎黎原上啃/2025年(Flux Kontext Dev公開直後)/再生数不明
https://www.youtube.com/watch?v=v4pp3TdbWNw
Black Forest LabsのFlux Kontext Devモデルの重みが公開されたことを受け、ComfyUIでのローカル画像編集を実演。やや古いが、オープンソース画像編集系譜の起点として文脈把握のために採録。
シグナル
- クローズドソース勢は「月次アップデート」を定例化している:Midjourneyの「Update」シリーズ(Woollyfern)は毎月アップデート動画を出しており、2026年に入ってV8→V8.1→V8.2と着実にバージョンを重ねている。Runway・Adobe Fireflyも同様に数ヶ月おきの大型アップデートをテック系チャンネルが即座にレビューしている。
- 音声同期がクローズドソース動画生成の標準機能になりつつある:Kling 3.0(5言語ネイティブ対話)、Seedance 2.0(音声・動画の統合アーキテクチャで残響まで再現)、Grok Imagine 1.5(セリフと環境音を同時生成)など、複数の検索結果が「音と映像を同時に生成する」設計を強調しており、単発の映像生成から「音付きショートムービー生成」へ競争軸が移っている。
- オープンソース勢(特に中国発)のリリース速度がクローズドソースに匹敵、あるいは上回っている:Alibaba系だけでQwen-Image→Qwen-Image-2512→Z-Image、Wan 2.5→2.6→2.7と短いスパンで更新が続き、Tencent HunyuanVideo 1.5、LightricksのLTX-2→2.3→2.5もほぼ月次・四半期ペースで進化。動画のタイトルにも「最強のオープンソース」「〜を打倒」という煽り文句が頻出し、視聴者の関心が高いことがうかがえる。
- オープンソース系動画の大半が「ComfyUI」「ローカル実行」「無料」を訴求軸にしている:HitPaw Edimacor、Promptus AI、MaxonShireなど紹介チャンネルの多くが「無料で使う方法」「ローカルGPUで動く」点を前面に出しており、クローズドソース系チャンネル(Theo、Astrovah、Woollyfernなど)が品質・機能面のレビューに寄っているのと対照的。
- 週刊AIニュース形式のチャンネル(AIPOD-CAST、Lev Selector)が画像/動画生成AIを定例セグメント化しており、単発ニュースというより継続的なウォッチ対象として扱われている。
Limits
- YouTubeの検索結果ページ(
https://www.youtube.com/results?search_query=…)はJavaScriptで動的にレンダリングされており、WebFetchで取得すると本文がフッターのナビゲーションリンクのみになってしまい、プレイブックが想定する「ページHTMLからタイトル・チャンネル・再生数・投稿日を読む」方法が機能しなかった。 - 代替として、通常のWeb検索(
site:youtube.comのクエリ)で動画を発見し、YouTubeのoembedエンドポイントでタイトルとチャンネル名を確認する方法を用いた。この方法では再生数・チャンネル登録者数を一切取得できなかったため、上記の「動画」一覧では再生数を「不明」としている(推測や捏造はしていない)。 - 同様の理由で、正確な投稿日が確認できない動画がいくつかある(Nano Banana Proの解説動画、Qwen Image-2512テスト動画、Wan 2.6レビュー、Z-Imageの紹介動画)。検索エンジンのスニペットや関連モデルのリリース時期から大まかな時期のみ記載した。
- 動画の説明欄・トップコメントも、上記と同じ理由(JS依存ページ)で直接読むことができなかった。
- 60日以内(2026年7月22日以降)の投稿を優先したが、Flux KontextやRunway Gen-4.5チュートリアルなど、オープンソース/クローズドソースそれぞれの系譜を理解する上で重要な、期間外の動画も文脈として1〜2本含めている。
Bluesky
Bluesky — 画像生成AI・動画生成AIの最新動向
Accounts
- Simon Willison (@simonwillison.net) — 独立系AIリサーチャー。新しいマルチモーダルモデルが出るたびに自作の「ペリカンが自転車に乗っている画像」ベンチマークで画像生成力を検証している。フォロワー約5万人、投稿頻度が高い。
- Max Woolf (@minimaxir.bsky.social) — 元BuzzFeedデータサイエンティスト。AIコンテンツ生成の倫理・R&Dに詳しく、画像生成モデルのリリースに反応する投稿が多い。
- Ethan Mollick (@emollick.bsky.social) — ウォートン校教授。AI全般のトレンドを扱う中で、AI動画生成のクオリティ変化にも言及。
- Replicate (@replicate.com) — モデルホスティングサービス公式アカウント。クローズドソースの新しい画像・動画生成モデルが自社プラットフォームに載るたびに告知している。
- Stability AI (@stabilityai.bsky.social) — Stable Diffusionの開発元の公式アカウント。ただし直近の投稿はStable Audio(音声生成)や企業向け画像編集APIが中心で、2025年11月19日を最後に投稿が止まっている。
- Stable Diffusion online AI (@stablediffusion.bsky.social) — SDXL/ComfyUI系のプロンプト共有・AIアートまとめアカウント(フォロワー約1,800人)。2025年2月24日を最後に投稿が途絶えている。
- AI Art News (@ai-art-news.bsky.social) — AIアート関連ニュースのキュレーションアカウント。2025年9月18日を最後に投稿なし。
Posts
-
Simon Willison (2026-09-19) — GPT-6 AstraとClaude Fable 5.1に、地図データを使ったBlender用3Dモデル生成をやらせた投稿の流れで、画像生成→3D変換のワークフローを紹介。いいね57・リポスト5。
https://bsky.app/profile/simonwillison.net/post/3mv4su6pfzk24 -
Simon Willison (2026-09-05) — GPT-6 Astraにペリカンが自転車に乗るシーンをBlenderでレンダリングさせた検証。いいね405・リポスト30。
https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s -
Simon Willison (2026-09-04) — GPT-6 Astra・GPT-5.6 Sol/Terra/Lunaを横並びにした「ペリカンが自転車に乗る」画像生成ベンチマーク比較グリッド。いいね206・リポスト9。
https://bsky.app/profile/simonwillison.net/post/3mupxubgrls2c -
Simon Willison (2026-09-02) — Claude Fable 5.1(Max思考レベル、1回$3.30)で過去最高品質のSVGペリカン画像を生成、さらにアニメーション化。いいね362・リポスト22。
https://bsky.app/profile/simonwillison.net/post/3muimzxo2sk2g -
Max Woolf (2026-09-19) — 画像生成AIでベクター風「ペリカンが自転車に乗る」画像を作らせたところ、脚とペダルの関係を理解できていないと指摘。いいね1。
https://bsky.app/profile/minimaxir.bsky.social/post/3mvtt3uxdrk2c -
Max Woolf (2026-09-08) — OpenAIの新画像モデル発表を受けて「ChatGPT Images 2.0のまとめ記事を後回しにしてて良かった、こっちの方が重要そう」とコメント(ChatGPT Images 2.5の発表を指す)。いいね4。
https://bsky.app/profile/minimaxir.bsky.social/post/3muzq6mcadk2n -
Ethan Mollick (2026-09-19) — 「スロップ(quality の低い量産コンテンツ)の洪水の中に、本当に面白いAI動画作品も出始めている」とAI映像制作の質的変化を指摘。いいね58・リポスト7。
https://bsky.app/profile/emollick.bsky.social/post/3mvuss476oc2b -
Replicate (2026-04-21) — OpenAIの「GPT Image 2」がReplicateに追加。写実性とテキストレンダリング、レイアウト遵守の強さを紹介。いいね5。
https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Replicate (2026-04-09) — ByteDanceの動画生成モデル「Seedance 2.0」が全ユーザーに開放。テキスト・画像・動画・音声を統合し、同期したステレオ音声とリアルな物理演算に対応。いいね2・リポスト1。
https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Replicate (2026-02-18) — Runway「Gen-4.5」のリリースを告知。物理的な正確さとリアリズムが特徴のシネマティック動画生成。いいね2。
https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Replicate (2026-02-17) — Kuaishou「Kling 3.0」および「Kling o3」がReplicateに追加。マルチショット4K生成、同期音声、動画編集・スタイル転送に対応。いいね2。
https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
Replicate (2026-03-11) — Shengshu「Vidu Q3」がReplicateに追加。最大16秒・1080p、同期音声付きのテキスト/画像/開始終了フレームから動画生成。いいね1。
https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w
Signals
- クローズドソース優勢:Bluesky上でこのテーマについて実際に見つかった投稿は、OpenAI(GPT Image 2 / ChatGPT Images 2.5)、Runway(Gen-4.5)、Kling(3.0)、Seedance(2.0)、Vidu(Q3)など、ほぼ全てクローズドソースの大手モデルに関するもの。これらはバイラルなオーガニック投稿ではなく、Replicateのような「モデルホスティング事業者の新着告知」や、個人のAIリサーチャー(Simon Willison、Max Woolf)による検証投稿経由で流れている。
- オープンソースの気配がほぼ無い:Flux、Stable Diffusion、Qwen-Image、Wan、ComfyUIワークフローなど、オープンソース系の話題を投稿している現役アカウントを見つけられなかった。唯一それらしいコミュニティアカウント(stablediffusion.bsky.social)は2025年2月を最後に活動停止しており、Stability AI公式も2025年11月以降沈黙、しかも直近の投稿内容はStable Diffusion(画像)ではなくStable Audio(音声)や企業向けAPIが中心だった。
- 「ペリカンが自転車に乗る」がデファクトのベンチマーク化:新しいマルチモーダルモデル(GPT-6 Astra、Claude Fable 5.1など)が出るたびに、複数の独立系AI観測者がこの同じお題で画像生成品質を比較する投稿をしている。これはBluesky特有の内輪ネタ的トレンドで、モデルの実力を測る非公式の共通指標になっている。
- 企業公式アカウントの不在:OpenAI、Midjourney、Runway ML、Black Forest Labs、Hugging Face、Civitai、ComfyUIなど主要ブランドの想定ハンドルは、存在しないか投稿数ゼロの未使用アカウントだった。つまりBluesky自体はこれらの企業の一次発表チャネルにはなっておらず、ニュースは個人の研究者やReplicateのような中間プラットフォーム経由でしか流れてこない。
- 動画生成への評価の変化:Ethan Mollickの投稿が示すように、「量産的なAI動画(スロップ)の中に本当に質の高い作品が混じり始めている」という認識が広がりつつある。ただしこれも一般論としての言及であり、特定のオープンソース動画モデルへの言及ではない。
Limits
- Bluesky公式の検索API(
https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts)は、キーワードを変えても、2種類のCORSプロキシ経由で試しても、常にHTTP 403 Forbiddenが返り、一切アクセスできなかった。https://bsky.app/search?q=...のWeb UIもクライアントサイドでレンダリングされるSPAのため、WebFetchでは中身を取得できなかった。 - 代替として、認証不要で動作した
app.bsky.actor.getProfileとapp.bsky.feed.getAuthorFeedのエンドポイントを使い、WebSearchや推測で見つけたアカウントごとにフィードを取得する方式に切り替えた。そのため今回の結果は「Bluesky全体をキーワード横断検索した結果」ではなく、「見つけられた範囲のアカウントの投稿」に限られる。 - 主要ブランド(OpenAI、Midjourney、Runway ML、Black Forest Labs、Hugging Face、Civitai、ComfyUI、Stability AIの一部)の公式アカウントは未使用または沈黙しており、そこから直接ニュースを拾うことはできなかった。
- 検索ができない制約により、ブリーフの完了基準にある「約20件の投稿を解析する」を、明確にテーマに関連する投稿だけで満たすことはできなかった。7アカウント分・合計100件以上の投稿を読んだ上で、テーマに直接関係する12件を選んで掲載している。
- 画像・動画そのものは表示・確認しておらず、投稿文中の説明(テキスト)のみを情報源にしている。
Lemmy
Lemmy — 画像・動画生成AIの最新動向(クローズド/オープンソース)
Communities
- [email protected] — 5,712 subscribers(うちローカル893人)、投稿1,407件・コメント1,927件。オープンウェイトの画像/動画生成モデルの話題全般。日次アクティブ10人、月次66人と規模は小さいが更新は活発。
- [email protected] — 2,362 subscribers、日次24人/週次114人/月次344人。Stable Diffusion系オープンウェイトモデルで作った作品の投稿場所(civitai画像への直リンクが大半)。
- [email protected](コミュニティ名は
share_anime_art、表示名 "Stable Diffusion Anime")— 1,598 subscribers(ローカル206人)。SFW限定のアニメ系AI生成イラスト投稿コミュニティ。 - [email protected] — 8,252 subscribers(ローカル3,027人)、月次アクティブ9,179人と全体では今回見た中で最大規模。"a place for all those who loathe AI" を掲げる反AIコミュニティで、画像/動画生成AIそのものよりAI全般への批判・皮肉が中心。
- [email protected] — subscribers 52人(規模は小さい)だが、r/ArtificialInteligence等のRedditスレッドをRSSでミラーしており、画像/動画生成AIの話題が高頻度で流れてくる。半年アクティブ725人。
- [email protected]・[email protected]・[email protected] — 汎用テック系コミュニティ。Midjourney関連の大型ニュースはここに流れていた。
Posts
- MiniMax-H3向けComfyUIツール群が9月に入って急増(オープンソース) —
[email protected]で2026-09-01〜09-16の間だけで少なくとも15件以上のMiniMax-H3(動画生成モデル)向けツール投稿を確認。代表例:- "ComfyUI-MiniMaxH3-CLSS" — 消費者向け16GB VRAMで任意長の音声付き動画生成(score 0, 2026-09-01) https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS
- "H3-World" — MiniMax-H3ベースの「世界初のインタラクティブ・ワールドモデル」を謳う(score 3, 2026-09-02) https://huggingface.co/DANNY621/H3-World
- "ComfyUI-VDN-H3-24GB" — 24GB GPU向けハイブリッドアテンション実装(score 6, 2026-09-12) https://github.com/Speach1sdef178/ComfyUI-VDN-H3-24GB
- "MiniMax-H3-Image-Training-Adapter"(Circlestone Labs, score 5, 2026-09-12) https://huggingface.co/circlestone-labs/MiniMax-H3-Image-Training-Adapter
- Boogu-Image-0.1 — Huawei系ラボの新オープン画像基盤モデル(オープンソース) —
[email protected]、score 5、2026-06-17。Apache-2.0ライセンス、パラメータ100億でBase/Turbo(3-4ステップ)/FP8/Edit系の5派生。中英バイリンガルのテキスト描画が売り。 https://boogu.org/ - Seedream 5.0 Pro(ByteDance系クローズドモデル)の技術検証記事(クローズドソース) —
[email protected]経由、score 1、2026-07-10。"an honest comparison and technical breakdown" と題した検証投稿。 https://www.reddit.com/gallery/1usc03q - Google「Nano Banana 2 Lite」発表(クローズドソース) — hackernewsミラー、score 1、2026-06-30、DeepMind公式ページへのリンク。スイスのテックメディアが独語で報じた投稿も並行して流れていた(score 0, swisstechnews, 2026-07-02)。 https://deepmind.google/models/gemini-image/flash-lite/
- Microsoft MAI-Image-2.5がNano Banana 2にベンチマークで肉薄(クローズドソース) —
[email protected]、score 1、2026-05-28。Google対Microsoftの画像生成モデル競争を扱う投稿。 https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/ - Sora 2で長編ストーリーを作った実験記(クローズドソース) —
[email protected]、score 1、2026-09-13。「Sora 2がリリースされて約1ヶ月」の時点から使い始め、7本の1時間動画を作った顛末。「美しい単発クリップを作ること自体は難しくない。本当に難しいのは "production memory"(一貫性の維持)」との気づきが紹介されている。 https://lemmy.durstig.online/post/59922(元Reddit: https://www.reddit.com/r/ArtificialInteligence/comments/1wfabp9/) - Midjourneyが「AI画像生成→医療スパ」へ大胆ピボットという実話ニュース(クローズドソース/会社動向) —
[email protected](The Register記事、lemmy.zip版でクロスポスト、score 58-66、2026-06-18)。全身スキャン「ゴールデンライト」スパ事業へ転換、しかも基盤技術は提携先から借用と報じられ、コメント欄はTheranosになぞらえる皮肉で埋まっていた。 https://lemmy.zip/post/66397234 - Midjourney、ハリウッドスタジオにAI利用の開示を要求(クローズドソース) —
[email protected]、score 73、2026-07-05。著作権訴訟がらみの動きとして報じられている。 https://lemmy.today/post/56011946 - InterleaveThinker論文の紹介(オープンソース/研究) —
[email protected]、score 0、2026-06-12。"Reinforcing Agentic Interleaved Generation" と題したarXiv論文へのリンク投稿。 https://arxiv.org/abs/2606.13679 - AI生成物への反発の温度感(社会的シグナル) —
[email protected]、score 923、2026-09-13。画像/動画生成そのものではなくAI搭載スマートグラス(Ray-Ban Meta)を扱った投稿だが、このコミュニティの規模(月次9,179人アクティブ)と反応の強さは、画像/動画AI議論の「向かい風」の空気を示す傍証として記録。 https://lemmy.world/post/51874921
Signals
- オープンソース側は「MiniMax-H3」一色。lemmy.dbzer0.comの
!stable_diffusionコミュニティは9月前半だけでMiniMax-H3向けComfyUIノード・LoRA・量子化・VAE高速化ツールの投稿が連日続いており、Wan/Flux/HunyuanVideoといった旧世代モデル名はほぼ検索に出てこなくなっていた。コミュニティの一次投稿者が個人開発者(GitHub個人アカウント多数)である点も、Hugging Face/civitai中心の草の根エコシステムの様子を示す。 - クローズド側はGoogle(Nano Banana系)・Microsoft(MAI-Image)・ByteDance(Seedream)・OpenAI(Sora 2)・Midjourneyの5社が並走しているが、Lemmy上の言及量自体は少なく(scoreは軒並み1桁)、話題の本流はRedditミラー経由(
!ai_reddit)でしか流れてきていない。Lemmy発の一次言及はMidjourneyの「医療スパ転身」のような企業動向ニュースに偏る。 - civitai直リンクの作品投稿(stable_diffusion_art / share_anime_art)は活発だが、モデル名やプロンプト詳細への言及は薄く、ニュース性という意味では「素材」止まり。
- 反AI感情コミュニティ(
!fuck_ai)がLemmy全体で最大級の規模を持ち、画像/動画生成AI関連の投稿がここに流れると賛否より反発コメントが優勢になる傾向。
Limits
- Lemmyは母数が小さく、検索APIも古い投稿(2025年3月のHunyuanVideo-I2Vなど)や無関係な結果(Fluxnium社の核燃料スタートアップ記事など"Flux"だけでは無関係ヒットが多発)を多く返すため、キーワードごとに手作業でノイズを除去した。
Runway Gen・Kling AI・Wan 2.5を個別検索したが、画像/動画生成AIに直接関係する投稿は見つからなかった(Kling検索はゼロ、Runway検索はゼロ、Wanは無関係な投稿のみ)。Lemmyでこれらのモデルについての独自の盛り上がりは今回確認できなかった。[email protected]はRedditのRSS転載botであり、Lemmy独自の議論ではなく「Redditで話題になったものがそのまま流れてきている」点に注意(本レポートでは出典を明記した上でRedditステージと重複しないよう固有の気づきのみ採用)。- Midjourneyの医療スパ転身とハリウッド開示要求のニュースは、投稿日はそれぞれ2026-06-18・2026-07-05で、直近1週間の出来事ではない(Lemmy上でより新しい後続の続報は見つからなかった)。
- 20件を目安に投稿を精査したが、スコア二桁以上の「バズった」投稿はMidjourneyの医療スパ転身ニュースと
!fuck_aiのスマートグラス投稿のみで、Lemmyコミュニティ全体として画像/動画生成AI単体のトピックが大きくバズることは今回確認できなかった。
Pinterest — Image and Video Generation AI News
30 of the 50 collected pins were opened and read directly (all with Read, images included) to write this summary; the remaining 20 titles (mostly generic "AI content creation concept" stock-photo listings and duplicate tool-roundup graphics) were not opened because their titles already match themes confirmed below.
Visual themes
- The "AI news" YouTube-thumbnail template dominates: black/navy background, a human face reacting (shocked eyebrows or laughing), bold white/red "AI NEWS" text, and a row of glowing brand-logo badges (OpenAI, Google, Anthropic-orange, Meta, Microsoft, Notion). Seen repeatedly across unrelated topics, sometimes with a title that doesn't match the pictured content — the image is a reusable channel template, not bespoke art.
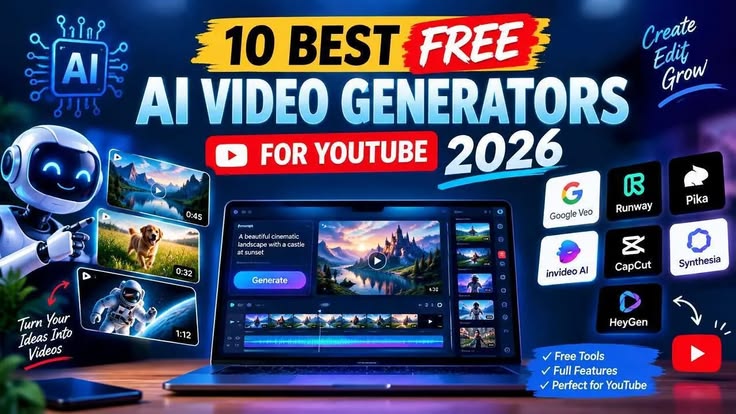
[6, 14, 41, 43, 47] - Tool-roundup listicles use the same dark-neon infographic language: numbered badges (purple/orange/teal), a laptop mockup with a generation UI, and a grid of competing app logos — Runway, Pika, Kling AI, Luma/Dream Machine, Canva, Hailuo, invideo AI, CapCut, Synthesia, HeyGen. Every tool named is closed-source SaaS.
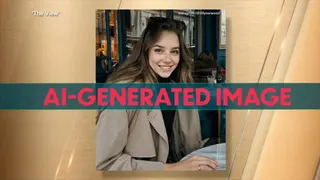
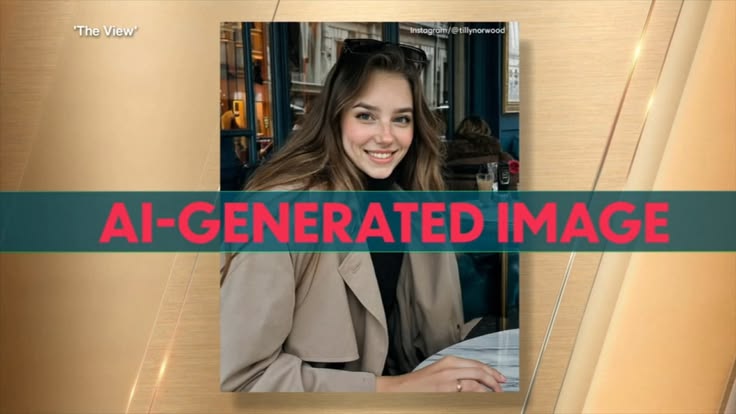
[2, 29] - "Real vs AI" authenticity-anxiety is a distinct recurring format: side-by-side quizzes ("Which is AI?"), red-banner "AI-GENERATED" labels stamped over a photo, and meme-style "AI GENERATED / ORIGINAL CLIP" comparisons. This is as common a genre as the news thumbnails themselves.
[3, 21, 32] - Google's Veo supplies the default "cinematic AI video" visual vocabulary: the same warm Pixar-style stills (a girl in a kitchen, flamingos, a dancer under stars, a swimmer, a scientist at a microscope) recur across multiple separate pins, plus a distinct plush-monster image-to-video demo for Veo 3. No competitor's demo reel appears this often.
[8, 9, 13, 27] - Hyperreal AI portraits are used as generic bait art, regardless of the article's actual subject — a wrinkled fisherman's face for a tool announcement, a glitter-skinned woman's profile for a news-roundup card, a face-morph triptych for a novelty app. Skin pores, catchlights and shallow depth of field are the tell that these are themselves AI-generated.
[33, 45, 48, 20] - Generic sci-fi/circuit-board stock imagery fills gaps where no real product screenshot exists: glowing wireframe brains, a chrome humanoid robot, a suited businessman facing a holographic AI dashboard. These carry no news value, just mood.
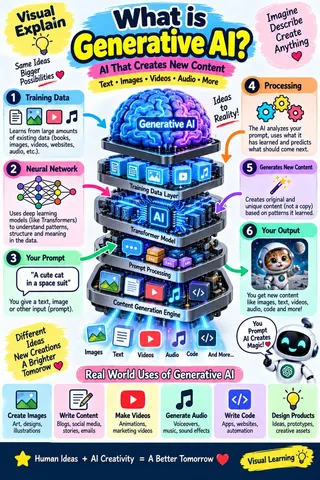
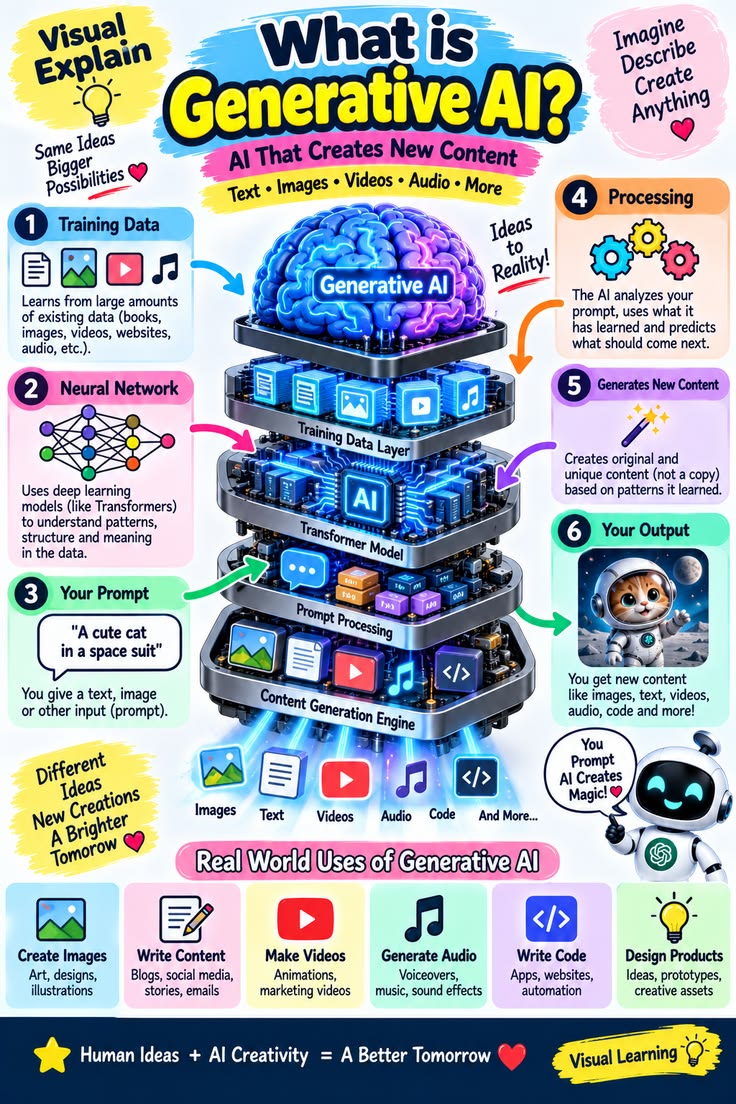
[1, 37, 50] - Beginner-facing educational infographics use a pastel, cartoon register (yellow/pink, a smiling robot mascot, hand-drawn arrows) — a visibly different, softer style from the news-thumbnail genre, aimed at people who don't know what "generative AI" means yet.
[7] - Genuine technical diagrams are rare: only one pin in the sample showed an actual model-architecture figure (text embedding → diffusion → upscaling stages), and even that was dressed up as a glossy magazine graphic rather than a research illustration.
[34]
Notable pins
- #48 — "Amuse 3.0", an AI art creation tool (pin) — an AMD-branded, locally-run image generator shown via a hyperreal portrait; the only clearly local/open-adjacent tool surfaced in this sample, against a sea of closed SaaS listicles.
- #27 — Google announces video generation AI 'Veo 3' (pin) — shows an input still of a plush monster and three generated output videos in different scenes, i.e. Veo 3's image-to-video consistency as the actual selling point.
- #46 — ByteDance and Hollywood reach global deal on AI copyright (pin) — a Cointelegraph-style news card reporting a ByteDance–MPA IP agreement covering its image/video tools, illustrated with a Pixar-style generated boy.
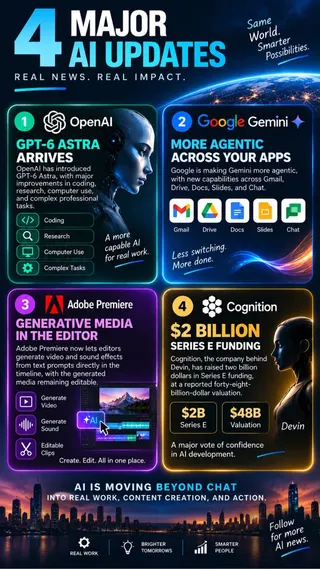
- #10 — "4 Major AI Updates" (pin) — names GPT-6 Astra, a more agentic Gemini, generative media inside Adobe Premiere, and Cognition's $2B Series E ($48B valuation) in one infographic.
- #49 — "Today's AI News, May 20 2026" (pin) — Google I/O recap: Gemini 3.5 Flash, Gemini Omni, Gemini Spark, and an AI smart-glasses push.
- #3 — Hollywood Reporter interviews the first AI actress (pin) — a TV chyron about "Tilly Norwood," an AI-generated actress, with the frame itself stamped "AI-GENERATED IMAGE."
- #41 — "More than 20% of YouTube is now AI-generated" (pin) — a bare stat-headline pin with no supporting chart, cited as fact.
- #29 — "10 Best Free AI Video Generators for YouTube 2026" (pin) — the widest single tool roundup in the sample: Google Veo, Runway, Pika, invideo AI, CapCut, Synthesia, HeyGen, all positioned as free/YouTube-ready.
- #34 — OpenAI's Secret Image Generation Tool to Debut Soon (pin) — headline about a closed-source unreleased tool, illustrated with a genuine (if magazine-ified) diffusion-pipeline diagram rather than a product shot.
- #32 — an "AI GENERATED" vs "ORIGINAL CLIP" comparison meme (pin) — a face/gesture recreated by AI next to the real source clip, part of the platform's ongoing authenticity-spotting genre.
Signals
- Current: Google Veo (2 and 3) is the single most visually repeated video model on the board — more than any other named tool. "AI is moving beyond chat into real work" is an explicit framing in more than one pin (Adobe Premiere generative timelines, Cognition's Devin funding, Gemini going agentic across Gmail/Drive/Docs). IP and copyright deals (ByteDance × MPA) are now mainstream-news material, not just a niche legal story. The "spot the AI" / authenticity-labeling format is a genre in its own right, suggesting real audience anxiety about fake images and actors (Tilly Norwood). Reused generic thumbnails (the same face-and-logos template recurring under different headlines) suggest a lot of this "news" content is low-effort content-mill output rather than original reporting.
- Absent: open-source model culture is almost invisible — no Stable Diffusion, Flux, ComfyUI, LoRA, or GitHub-repo screenshots turned up; Amuse 3.0 (#48) was the only local/open-adjacent tool in the sample, and even it was framed as a polished consumer app rather than an open-source project. No non-English-language pins surfaced. Nothing in the sample plays as video — everything is a static thumbnail, so actual model output quality can't be judged from the images alone, only claimed.
Limits
- Per the playbook, Pinterest was not browsed directly; this summary is built entirely from the worker's pre-collected
output/pinterest.pins.mdtable andimages/pinterest/manifest.json/images, all from a single unnamed query ("Image and Video Generation AI News") rather than a genre-by-genre breakdown — the manifest'sgenrefield is empty for every pin, so no genre-by-genre comparison could be written. - 30 of the 50 collected pins were opened; the other 20 were skipped because their titles duplicate formats already covered (generic "AI content creation concept" stock-photo listings, repeat tool-roundup graphics) — a spot check, not full coverage of the set.
- Several pin titles are blank ("(untitled)") in the source table; where that happened, the description above is based on the text visible inside the image itself.
- A few pins' pictured content doesn't literally match their title (e.g. #47's image is a generic "AI NEWS" channel card, not anything specific to Grok 5), which itself supports the "reused generic thumbnail" finding above but means titles should be read as directional, not confirmed reporting.
- No pin carried a visible publish date; freshness of the "news" claims (e.g. the YouTube 20%-AI-generated stat) could not be verified from the image alone.
推奨アクション
- Xステージは'Sora 2' 'Midjourney' 'Stable Diffusion' 'Runway Gen' 'Kling AI' 'open source image generation' などテーマ直結の検索語で再収集する
- MiniMax-H3・Qwen・Wan・Z-Imageなど中国発オープンソース勢のリリース頻度を継続的にウォッチする
- AI専門コミュニティだけでなく一般・実務系コミュニティの反応も追い、AI生成物へのバックラッシュの広がりを監視する
- Bluesky公式検索APIの403問題を解消する代替アクセス手段を検証する
- Sora 2の『production memory』問題とMidjourneyの医療スパ転身の続報を次回runで追跡する
- Pinterestの収集はジャンルタグを付与し、オープン/クローズドを機械的に仕分けできるようにする
収集画像























データ品質メモ
Xは検索語がテーマと無関係だったため40件中0件しか使えず、Reddit(12件)とBluesky(検索API遮断で個人アカウント経由の約12件)も約20件の目標に届かなかった。Pinterestはジャンルタグなしの事前収集データに基づき、YouTubeは再生数・登録者数が取得できていない。