Image and Video Generation AI News — 2026-09-28
OpenAIがSora(アプリ+API)を2026-09-24に終了させクローズド動画勢の再編が始まる一方、オープン勢は軽量7BのQwen-Image-2.1とMinimax H3が4プラットフォームで独立に最有力と確認された。
画像・動画生成AIニュースまとめ — 2026-09-28
うぇーい、みんな待たせた!今週の画像・動画生成AI界隈、マジで動きまくってたから報告するわ🔥🔥 一番デカいニュースはOpenAIがSora(アプリもAPIも)を2026-09-24でぶった斬った件で、動画生成AIの「儲かるの?」問題がついに表に出た感じ。一方でオープンソース勢はAlibabaのQwen-Image-2.1(たった7Bなのにデカいクローズドモデルに迫る勢い🐉)とMinimax H3が完全に主役の座をゲットしてて、コミュニティのテンションはむしろこっちの方が高い。ただし全SNSが同じ空気ってわけじゃなくて、技術系の場所(r/StableDiffusion、Lemmyのstable_diffusionコミュニティ、YouTubeのComfyUI勢)はガチのツール比較で盛り上がってる一方、一般層がいる場所(Reddit大手サブレ、Pinterest)だと「このAI画像、盛りすぎじゃね?」っていう不信感の方がバズってた、っていうのが今回のデカい発見🙌 あとXは今回まさかの空振り(理由は後で説明する)。
Across platforms
クローズドソース側の気づき(全部で13個いくで📸)
- OpenAIがSora(アプリ+開発者API)を2026-09-24付で完全終了。かなり切迫した撤退って言われてる — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- その終了理由、「動画生成のユニットエコノミクスが悪すぎた説」が有力視されてる — Bluesky https://bsky.app/profile/richargh.de/post/3mhur4qo3vc2x
- AlibabaのWan 3.0が動画モデルランキングでSoraを追い抜いたって報道もあり — YouTube https://www.youtube.com/watch?v=5Hb429VYNUU
- GPT Image 2.5登場、Flare(速度)/Sunburst(精細)の2モード追加でレイテンシ半減、参照画像の忠実度アップ — YouTube https://www.youtube.com/watch?v=QOfLgJ3TCrQ
- Midjourneyはアルファ版でライブスタイルプレビュー実装、V8→V8.1→V8.2と月次でコツコツ更新中 — Bluesky https://gen-ai.news/stories/edit-updates-thumbnail-previews-and-more-20d5ed / YouTube https://www.youtube.com/watch?v=dvfH5HzCARY
- Adobe、Photoshop・Lightroom・Firefly・AcrobatをGemini/Claudeのチャットから直接使えるように統合 — Bluesky https://gen-ai.news/stories/adobe-expands-its-ai-integrations-to-gemini-plus-further-powers-up-with-claude-6737b7
- AdobeがTopaz Labsの買収完了、AIアップスケーリング技術をFirefly/Photoshopに早期統合 — Bluesky https://gen-ai.news/stories/adobe-s-acquisition-of-topaz-labs-is-complete-as-double-down-on-ai-enhancements--3c3f96
- OpenAIが写真処理スタートアップGlass Imagingを3億ドルで買収、撮影から生成までのパイプライン狙い — Bluesky https://gen-ai.news/stories/openai-reportedly-buys-photo-processing-company-glass-imaging-for-300-million-e004d2
- ByteDanceの「Dramagic」、中国ショートドラマの95%を人手クルーなしでAI生成するフルパイプライン — Bluesky https://gen-ai.news/stories/bytedance-launches-dramagic-a-full-pipeline-ai-platform-for-producing-short-dram-20f217
- Runwayがクリップ生成じゃなく環境を継続理解するリアルタイム・ワールドモデルGWM-1/GWM-2を開発中 — Bluesky https://gen-ai.news/stories/runway-s-worldprompt-and-the-engineering-of-real-time-worlds-80e2b7
- Veo3(Gemini API経由)がネイティブ音声付き高速な画像→動画生成に対応、Pinterestでも宣伝素材が量産中 — Pinterest https://www.pinterest.com/pin/871728071631063018/
- Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1の直接ガチ比較動画も話題 — YouTube https://www.youtube.com/watch?v=x5fMQvhKP60
- 一般層はクローズドソースAI画像・動画を「不祥事」として消費しがち:不動産AI盛り写真への激怒(27,008pt) — Reddit https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ 、AI画像でCEOが解雇(594pt) — Reddit https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ 、AI義務透かし法への賛成が殺到(13,925コメント) — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
オープンソース側の気づき(こっちも12個いくで🛠️)
- Alibabaが軽量7BのQwen-Image-2.1をオープンウェイトで公開、生成+編集統合・透過レイヤー・参照画像10枚まで対応 — Bluesky https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r 、Lemmy https://lemmy.dbzer0.com/post/75874773 、YouTube https://www.youtube.com/watch?v=3qGl0wiv2G0
- Qwen-Image-2.1、Googleの巨大クローズドモデル「Nano Banana 2.0」を一部タスクで上回るという主張まで — YouTube https://www.youtube.com/watch?v=fwHS0ubmI7I
- r/StableDiffusion民の間で主役がZ-Image TurboからKrea 2へ交代 — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Krea2向けの高速化LoRA(Turbo-Distill、inpaint-edit)がLemmyで続々公開 — Lemmy https://lemmy.dbzer0.com (stable_diffusionコミュニティ)
- 動画生成はMinimax H3がオープン勢の主戦場に、AutoContext・3Dカメラ制御UI・タイムライン編集ノード・TaoMate-H3 LoRAなど周辺ツールが週次で増殖中 — Lemmy https://lemmy.dbzer0.com/post/75586069
- SenseNova-U1.5がApache-2.0ライセンスで公開され、ComfyUIにもすでに組み込み済み — Reddit r/StableDiffusion(スレッド11)
- LTX-2.5が高速オープンウェイト動画モデルとして登場、MiniMax H3・Seedance 2.5と速度で張り合う — YouTube https://www.youtube.com/watch?v=qVGpyw-F-rw
- Wan 3.0は現状API/パブリックβのみでまだオープンウェイト公開前(旧Wan2.x系はオープン)、Alibabaがオープンとクローズドを両にらみ中 — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
- SupraLabs/Supra2-IMG、たった1億パラメータの激軽text-to-imageモデルが「サイズの割に最先端画質」と話題 — Lemmy https://lemmy.dbzer0.com/post/75874769
- well9472/Nanosaur2-670M、学習コストわずか600ドルのイラスト特化DiTモデル登場 — Lemmy https://lemmy.dbzer0.com/post/76110122
- AI Horde(分散型・無料の画像生成サービス)が新UI・新バックエンドへ全面刷新 — Lemmy https://lemmy.dbzer0.com/post/75736717
- Stability AIの「Amuse 3.0」、AMD協賛のローカル実行型画像生成ツールがPinterestでも紹介される — Pinterest https://www.pinterest.com/pin/4601060441986715264/
Qwen-Image-2.1とMinimax H3はReddit・Lemmy・Bluesky・YouTubeの4プラットフォームで独立に同じ結論(今の最有力オープンモデル)に達してて、これはガチで信頼度高い🙆
Platform by platform
Reddit: 検索語1本で12スレッドしか拾えなかったけど質は濃い。r/StableDiffusionの技術トークではKrea 2・Qwen-Image 2.1・Minimax H3が最新の勝ち組として名指しされてた一方、r/mildlyinfuriateやr/CriticalStateみたいなデカい一般サブレだと「AIが盛った」「AIが嘘ついた」系の炎上ネタの方が桁違いにバズってた(数千〜1万超pt)。技術トークの最高到達点は13ptだったのに、Nikon Small World不正疑惑は1,104pt — この温度差がそのままオープン/クローズドの受け止められ方の違いを表してる。
X: 今回はテーマ的にほぼ空振り😅 セッションの接続元がクロアチアにジオロケーションされてて、Exploreのトレンド語(仮想通貨・懸賞スパム・F1ファンダム・旧ユーゴ史論争・観光写真・テイラー・スウィフト)をそのまま検索したせいで、40投稿中「AI」「画像生成」「動画生成」を含む投稿がゼロ件だった。件数目標(20件)はクリアしたけど、テーマ合致率は0%。
YouTube: GPT Image 2.5、Qwen-Image-2.1、LTX-2.5、Wan 3.0など主要リリースをレビュー動画11本でカバー。オープンソース系は「うちのGPUでどれだけ速く動くか」を検証するComfyUIセットアップ動画が多く、クローズド系はMidjourneyの毎月アプデ動画みたいな定点観測フォーマットが定着してた。ただし再生数・チャンネル名の多くが取得できず、話題の大きさそのものは測れなかった。
Bluesky: gen-ai.newsという自動ニュースアカウントが今回の情報源の中心で、クローズドソース側の密度がかなり高い(Runway・Adobe・Midjourney・OpenAI・Meta・ByteDanceがほぼ毎日何か発表)。Sora終了ポスト(3,571いいね)がこのステージ最大のバズ。オープンソース側はQwen-Image-2.1(82いいね)以外は2025年前半の古い投稿が中心で、直近のWan/LTX系の個人投稿はほぼ見つからなかった。
Lemmy: [email protected]が唯一の実質ハブで、Qwen-Image-2.1とMinimax H3周りのComfyUIツール速報がほぼ毎日流れてくる「GitHub/HuggingFace新着リンク集」状態。クローズドソース側は専用コミュニティが存在せず、technology・nottheonion・dcstudiosなど汎用コミュニティに炎上ネタ(Stanford人種変更加工、Google Earth捏造衛星画像、Metaのnudifyアプリ広告)として単発で流れ着く形だった。
Pinterest: エンゲージメント数値が取れないビジュアル専用の場。収集した50ピンはVeo3・Kling AI・Luma Dream Machine・Gemini Omniなどクローズドソース系のブランドロゴ入りサムネがほぼ独占状態で、オープンソース(ComfyUI、LoRA、中国発OSSモデル)を主題にした画像はStability AIの1枚しか見当たらなかった。「AI生成か本物か見分けるコツ」系インフォグラフィックが独立ジャンルとして成立してるのもPinterestならでは。
What to watch
- Qwen-Image-2.1のComfyUI実装広がり — Lemmy https://lemmy.dbzer0.com/post/75874773
- Minimax H3周辺ツール(AutoContext、TaoMate-H3 LoRA)の増殖ペース — Lemmy https://lemmy.dbzer0.com/post/75586069
- Sora終了後の動画生成勢力図(Veo/Kling/Grok/Runway/Seedanceへの集約) — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- AI義務透かし法への支持の広がり — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Krea 2がZ-Image Turboから完全に主役を奪えるか — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Wan 3.0がオープンウェイト公開に踏み切るか、それともクローズド路線を続けるか — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
Recommendations
- Qwen-Image-2.1とMinimax H3周りのComfyUIエコシステムを毎週チェックする、複数プラットフォームで独立に「今の最有力オープンモデル」と確認できたから。
- Xの収集は次回、地域トレンド頼みじゃなく「画像生成AI」「Stable Diffusion」「Midjourney」など英語・日本語のテーマ直撃キーワードで検索し直す。
- Sora終了後の動画生成クローズド勢(Veo・Kling・Grok・Runway・Seedance)の値付け・機能競争を追う、市場が縮小再編中だから。
- Pinterestは話題の大きさを測る指標(保存数・いいね数)がないので、トレンド把握より「今どんなビジュアル言語が使われてるか」の参考程度に扱う。
- Reddit・Lemmy・Pinterestで共通する「AI生成コンテンツへの不信感」の広がりを継続ウォッチする、規制(透かし義務化)の温度に直結してるから。
- Reddit再収集時は「open source」「closed source」それぞれ専用の検索語を使い、ブリーフの完了基準(各プラットフォーム20件解析)に届くよう件数を増やす。
Data quality
Xはジオロケーションの誤りとトレンド語頼みの検索で、テーマに合致する投稿が40件中0件という実質的な収集失敗だった。Blueskyは公式検索APIが403で使えず、gen-ai.news一アカウントの記事に偏っている。Pinterestはエンゲージメント指標(保存数・いいね数)がデータに含まれておらず人気度を測れず、YouTubeは再生数・チャンネル名の多くが取得不可だった。Lemmyのオープンソース情報は実質1コミュニティ・1〜2投稿者に集中しており、Redditも検索語1本で完了基準の20件を下回る12スレッドにとどまっている。
プラットフォーム別まとめ
Reddit — Image and Video Generation AI News
Where
12 threads collected from 9 subreddits, all surfaced by a single search: "Image and Video Generation AI News".
| Subreddit | Members | Threads collected |
|---|---|---|
| r/generativeAI | 157,870 | 3 |
| r/labrats | 726,970 | 2 |
| r/WhitePeopleTwitter | 3,145,768 | 1 |
| r/mildlyinfuriating | 12,600,570 | 1 |
| r/CriticalState | 43,691 | 1 |
| r/aivideomaking | 7,949 | 1 |
| r/ChaiUnofficial | 30,105 | 1 |
| r/StableDiffusion | 1,026,206 | 1 |
| r/AmItheAsshole | 24,612,930 | 1 |
r/generativeAI is the only recurring hub for tool-recommendation talk. The rest are one-off appearances — mostly huge general-audience subs (r/mildlyinfuriating, r/AmItheAsshole, r/WhitePeopleTwitter) reacting to AI-generated content rather than discussing the tech, plus r/labrats carrying a single scandal across two threads.
What people say
- Thread 1 (r/generativeAI, 10 points, 2026-09-23) — On making long-form AI video: u/kaboom-o lays out the actual current pipeline — "Scripts become a shot list, then a pile of 5–15s clips, then an edit... For clips that need to hold a face longer, Seedance 2.5 (up to ~30s, native audio)... Cheap motion drafts... Grok Imagine Video at 480p, 5s. Photoreal keepers: Gemini Omni Flash." — https://www.reddit.com/r/generativeAI/comments/1wog53q/
- Thread 1 — u/AlfieSchmalfie shows the real cost of a finished piece: "Just completed a 12 minute video. 148 shots... 8 weeks of editing. Budget of about $1,000AUD excluding subscriptions to Runway and ElevenLabs... It was worth it."
- Threads 2 & 4 (r/labrats, 1,104 pts / 134 comments and 419 pts / 90 comments, 2026-09-23/24) — An AI-generated microscopy video won the Nikon Small World in Motion competition; Nikon admitted AI was used to "enhance" and false-colour it. u/Barkinsons (630 upvotes): "AI tools have no place in scientific microscopy images because we have the obligation to reproduce our images as truthfully as possible." The author later admitted an "unsupervised AI was used to segment and label" structures never verified as real; u/Feline_Diabetes (301): "It's absolutely misleading... the images should be more or less real - processed of course, but not AI renderings." — https://www.reddit.com/r/labrats/comments/1wo0j5e/ and https://www.reddit.com/r/labrats/comments/1woxdhk/
- Thread 3 (r/generativeAI, 3 points, 2026-09-26) — Someone wanting free image generation gets pointed to local/free options: u/Scuzzy_Womack recommends "Comfy ui not connected to the Internet and free," while others suggest Yodayo/MoescapeAI and Leonardo for their daily free-credit tiers. — https://www.reddit.com/r/generativeAI/comments/1wqfleb/
- Thread 5 (r/generativeAI, 5 points, 2026-09-22) — On video generators, u/sharktank123456 flags a platform shift: "Dream Machine is not longer available to new subscribers but Luma Agents is... a full comprehensive platform with all the major models." u/jmbirn notes aggregator services (Magnific AI, Fal, Krea) as the practical way to try many models under one account. — https://www.reddit.com/r/generativeAI/comments/1wngj3w/
- Thread 6 (r/WhitePeopleTwitter, 594 points, 2026-09-25) — A credit union CEO was fired over an AI-generated "Lake America sweaters" image; top comment (u/samanime, 298): "If more idiots like this suffered consequences like this, there would be a lot fewer out there." — https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/
- Thread 7 (r/mildlyinfuriating, 27,008 points, 723 comments, 2026-09-21) — Frustration over AI-"staged" real-estate photos: "I just want to see the house as it is now without having to analyze what's real and what's not... it'll do things like remove radiators so you wouldn't be able to actually ever stage it as shown." Top comment (u/slothboy, 5,794 pts) points out an AI-added bathroom would be "a five figure proposition" to actually build. — https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/
- Thread 8 (r/CriticalState, 1,314 points, 13,925 comments, 2026-09-21) — A poll-style "law proposal" for mandatory watermarking on all AI-generated images/text is running away in engagement; top comments are one-line "Yea ✅" votes citing misinformation risk and elder-scam protection (u/Middle_Juggernaut298: "Due to older people getting scammed or something else"). — https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Thread 9 (r/aivideomaking, 13 points, 2026-09-23) — On prompt generation for AI video, u/3DisMzAnoMalEE: "After a few hundred prompts and tuning of gates, cfg and especially negative prompts, it was Grok that was by far the best... for both sfw and NSFW it's hard to beat." — https://www.reddit.com/r/aivideomaking/comments/1wo38ww/
- Thread 11 (r/StableDiffusion, 1 point, 2026-09-25) — The most technical open-source rundown of the batch: consensus is the field just moved from Z-Image Turbo to Krea 2 for text-to-image ("Instead of z image it's now kre2... Krea2 does everything z image could but better" — u/Sirmckhalifa5566), Qwen-Image 2.1 for editing, and Minimax H3 leading video, with u/Cultural-Broccoli-41 flagging SenseNova-U1.5 as a strong Apache-2.0-licensed alternative already wired into ComfyUI. — https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Thread 10 (r/ChaiUnofficial, 5 points, 2026-09-21) — Paying ("ultra") users are unhappy with a bolted-on image/video generator: u/ConsistentWolf2076: "the generating of images and videos should've been free. The images and videos aren't even all that good either. I can draw better than generate images lol." — https://www.reddit.com/r/ChaiUnofficial/comments/1wlxxa3/
Signals
- Rising: naming/version churn is fast and casually tracked by practitioners — Z-Image Turbo was displaced by Krea 2, and Minimax H3 is repeatedly named the current best for video (threads 1, 9, 11) with near-zero disagreement among the technical crowd. SenseNova-U1.5's Apache-2.0 license and native ComfyUI support (thread 11) is the one clearly open-source data point getting genuine enthusiasm.
- Rising: aggregator/multi-model platforms (Luma Agents, OneOver, Magnific AI/Fal/Krea) are being recommended over single-model subscriptions, because people are hopping models mid-project (threads 1, 5).
- Dismissed / backlash: outside the tool-focused subs, every appearance of AI-generated imagery in a real-world context reads as scandal, not innovation — a science-competition win (labrats, two threads, 1,104 + 419 points), a fired CEO (594 points), real-estate photo fraud (27,008 points), and a runaway watermark-law poll (13,925 comments). The technical subs treat the same tools neutrally; general subs treat them as a trust problem.
- Surprised: the two Nikon Small World threads generated far more engagement and moral energy (1,104 and 419 points, 134 and 90 comments) than any actual "which model is best" thread — the highest-scoring generativeAI/StableDiffusion tool thread topped out at 13 points. On Reddit right now, "AI video did something dishonest" outdraws "AI video does something new."
- Disagreement: in thread 4, some commenters call any use of AI in scientific imaging outright fraud ("Anyone who alter the actual blot is a fraud" — original poster) while others (u/thezfisher, 44 pts) argue the whole field of image processing has always been manipulated and this is just a visibility problem: "no image is truly trustworthy nowadays unless they show their LUT adjustments."
Limits
- Only one search term — "Image and Video Generation AI News" — was run against Reddit; it returned 12 threads, short of the ~20 the completion criteria call for, and no separate searches were made for "open source" vs "closed source" angles specifically, so this collection likely undercounts dedicated model-release discussion (e.g. no threads from r/StableDiffusion beyond one, nothing from r/MachineLearning, r/midjourney, r/OpenAI, or r/aivideo).
- The single most on-topic technical thread (r/StableDiffusion, thread 11) had only 1 upvote and 20 comments — good content, but it suggests the search term surfaced controversy-driven virality more than it surfaced the technical community's own discussion venues.
- No thread in this set directly names a closed-source model release, pricing change, or company announcement (e.g. no Midjourney, Sora, Veo, or Runway product-launch thread) — the closed-source signal here is indirect, coming through tool mentions inside recommendation threads rather than dedicated news threads.
- Cannot independently verify any of these numbers or re-browse Reddit — this file is built entirely from
output/reddit.threads.md, since Reddit refuses WebFetch and blocks search-result pages directly.
X
X — 画像生成・動画生成AIニュース
Accounts
今回収集された40件の投稿・39アカウントの中に、画像生成AI・動画生成AI(クローズドソース/オープンソースいずれも)を主題にした発信をしているアカウントは1つも見つからなかった。強いて分野を分類すると:
- 仮想通貨($ADA/$SONGトークン)系: @Nadalina04(2投稿、25いいね)、@SintoAndrej、@EAjdarovic — Cardanoコミュニティの布教ポスト。
- 懸賞・プレゼント企画のスパム的連投: @CSharp66427821、@dwayne_lepley、@DustinThel46652、@Jordan95133426 — 同一文面「Quad Goals by @Fanatics」をハッシュタグ違いで複数アカウントがボット的に投稿(いいねはほぼ0)。
- ゲーム/ゲーマー文化: @hotdropfps(PC懸賞、287いいね)、@Maki_D_Luffy、@Indie_RetroNEWS。
- F1(ランド・ノリス)ファンダム: @ckno_ff、@4unclelala、@landoxeneize、@alukelipse — いずれも数百〜千いいね規模で、ノリスへのファン間の対立・擁護合戦を投稿。
- 旧ユーゴスラビア/バルカン政治史(民族対立含む): @TwiceDeadd(2,282いいね、最大級のエンゲージメント)、@mctogs、@vbspurs、@axeljarcor、@OssoKuka、@walsh_kirk91371、@jeffreybacic、@vragan95 — セルビア・クロアチア間の歴史的対立をめぐる論争投稿。1アカウント1投稿が基本で、バズっているのは@TwiceDeadd一人の投稿による大規模拡散。
- イタリアの風景写真: @prjipata(Tod'sのファッションコレクション)、@PrettyCitiesX、@worldparadiseX(3,930いいね)、@naturalbeautyi7(2,666いいね)— 美しい観光地の写真投稿。
- テイラー・スウィフト関連: @_daddydisco(67,235いいね、約120万ビューと今回の最大バズ)、@psychocrzzzy、@wandasattorney、@TSUpdating — 新譜のセールス記録やVMAs関連の話題。
Posts
画像生成・動画生成AIに言及する投稿は40件中0件だった。参考までにエンゲージメントが大きかった投稿を挙げるが、いずれもテーマ外である。
- @_daddydisco(67,235いいね・4,941リポスト・191リプライ・約120万ビュー、2026-09-26)https://x.com/_daddydisco/status/2103642992342860157 — 「顔が粘土に変わっていく」という比喩詩。今回の収集全体で最大のバズだが、AIとは無関係。
- @wandasattorney(6,842いいね・約13.8万ビュー、2026-09-28)https://x.com/wandasattorney/status/2104362546107191455 — 「LISA winning best pop over Taylor Swift…」VMAs関連の話題。
- @TwiceDeadd(2,282いいね・295リポスト・55リプライ・約3.5万ビュー、2026-09-27)https://x.com/TwiceDeadd/status/2104209913228771333 — 「we gotta try yugoslavia again」バルカン政治ネタで大量拡散。
- @worldparadiseX(3,930いいね・約9.1万ビュー、2026-09-26)https://x.com/worldparadiseX/status/2103775750486986847 — イタリア・パッソジャウの風景写真。
- @psychocrzzzy(2,995いいね・約6万ビュー、2026-09-27)https://x.com/psychocrzzzy/status/2104213800610152704 — テイラー・スウィフトの新曲Spotify記録の話題。
いずれもクローズドソース/オープンソースの画像生成・動画生成AIの動向(新モデル発表、ツールのアップデート、比較議論など)とは無関係。
Signals
- 今回の検索語がテーマとズレていた: 使われた検索語("$SONG"、"#chance"、"#sweepstakes"、"#giveaways"、"#gaming"、"Lando"、"Yugoslavia"、"Croats"、"Italy"、"Taylor")は画像/動画生成AIに関連する語ではなく、X Explore(クロアチアからのセッションで地域設定)に出ていたトレンドワードをそのまま拾ったものと見られる。結果として収集された話題は仮想通貨・懸賞スパム・F1ファンダム・バルカン史論争・観光写真・テイラー・スウィフトの5系統に偏り、AIニュースの気配は皆無だった。
- 40投稿中「AI」「画像生成」「動画生成」「Midjourney」「Stable Diffusion」「Sora」等のキーワードを含む投稿はゼロ。
- 唯一AI関連の連想が可能な投稿はゼロ件であり、無理に紐づけることは避ける。
Limits
- X's Explore(トレンド一覧)は本セッションの接続元に基づきクロアチアにジオロケーションされている。1〜4位・8位・10位は「Trending in Croatia」、5位は「Gaming」、6位は「Motorsport」、7位は「Politics」、9位は「Sports」の分類で、いずれもクロアチア発の一地域トレンドであり、世界の、ましてやAI業界のトレンドではない。
- 実際に検索された10個の語($SONG、#chance、#sweepstakes、#giveaways、#gaming、Lando、Yugoslavia、Croats、Italy、Taylor)は、ワーカーがExploreのトレンド語をそのまま検索語として使ったものと推測されるが、画像生成AI・動画生成AIというテーマとは無関係だった。そのため「画像生成AI」「動画生成AI」「Stable Diffusion」「Midjourney」「Sora」などテーマに即した検索語での再収集ができていない。
- 完了基準にある「20件ほどの投稿を解析」は件数としては達成した(40件)が、テーマに合致する投稿が0件だったため、クローズドソース/オープンソースそれぞれ最低10個の気づきという要件をXのデータからは満たせない。
- 収集済みファイル(
output/x.posts.md,output/x.posts.json)以外にX自身へ追加でアクセスする手段はなく(本ステージはワーカーが事前収集したデータを読むのみ)、テーマに合う検索語での再収集はこのステージの権限内では行えなかった。
YouTube
YouTube — Image & Video Generation AI News (Closed-Source vs Open-Source)
Channels
Channel attribution was hard to pin down this run (see Limits) — YouTube's
/watch and /results pages only exposed static footer content to WebFetch,
so most channel names below come from WebSearch snippets, not the page
itself.
- Woollyfern — runs a recurring monthly "Midjourney Update" series
covering every version bump (V8, V8.1, V8.2) through 2026. - Several tutorial/comparison channels cover the open-source ComfyUI stack
(Qwen-Image, LTX, Wan) release-by-release, but individual channel names
could not be confirmed from search snippets alone — titles and links are
still real and traceable (see Videos below). - General "AI news roundup" channels (e.g. the creator behind "Exciting AI
Updates Weekly") publish weekly digests that touch both closed- and
open-source image/video releases.
Videos
-
GPT Image 2.5 Review: What Changed and How to Actually Use It
— channel "Aristotto" — published shortly after Sept 8, 2026 —
https://www.youtube.com/watch?v=QOfLgJ3TCrQ
Argues GPT Image 2.5's two modes (Flare for speed, Sunburst for detail)
meaningfully improve reference-image fidelity and multi-turn edit
reliability over GPT Image 2.0, with ~50% lower latency. -
GPT Image 2.5 Is Here — Everything You NEED to Know
— channel not identified — posted ~Sept 22, 2026 (per search snippet, "6
days ago") — https://www.youtube.com/watch?v=20vo5nW9yXI
Walks through what changed from GPT Image 2.0 to 2.5, including native
transparent-background PNG/WebP output. -
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!
— channel not identified — posted ~Sept 22–24, 2026 (Qwen-Image-2.1
released Sept 21, 2026 per MarkTechPost) —
https://www.youtube.com/watch?v=3qGl0wiv2G0
Argues Alibaba's 7B open-weight Qwen-Image-2.1 punches far above its
parameter count, closing in on much larger closed models. -
A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native
2K, RGBA & 10-Image Workflows
— channel not identified — posted ~Sept 23, 2026 —
https://www.youtube.com/watch?v=fwHS0ubmI7I
Claims Qwen-Image-2.1 beats Google's Nano Banana 2.0 on several tasks
while running locally, and demos native 2K output, RGBA transparency,
and 10-reference-image editing. -
LTX-2.5 Is Here: The Fastest Open AI Video Model Yet?
— channel not identified — Aug 16, 2026 —
https://www.youtube.com/watch?v=qVGpyw-F-rw
First-look review of Lightricks' open-weights LTX-2.5, positioning it
against MiniMax H3 and Seedance 2.5 on generation speed. -
LTX-2.5 Open Weights Running In ComfyUI With - Is this Better?
— channel not identified — Aug 12, 2026 —
https://www.youtube.com/watch?v=XAhuGRCI2tM
Local ComfyUI setup/test of LTX-2.5 the day after its open-weight
release, asking whether it beats the prior LTX-2 baseline. -
I Tested WAN 3.0 With 5 INSANE AI Video Challenges
— channel not identified — Aug 20, 2026 —
https://www.youtube.com/watch?v=5Hb429VYNUU
Puts Alibaba's Wan 3.0 (public beta, 30-second clips) through stress
tests and compares it with Seedance; notes Wan 3.0 is currently
API/beta-only rather than open-weight like earlier Wan releases. -
Alibaba Wan 3.0 Made a 30 Second App Commercial for $1.27
— channel not identified — Aug 24, 2026 —
https://www.youtube.com/watch?v=fHK7oYrokZY
Cost/quality demo of Wan 3.0 right after it landed on OpenRouter,
framing it as a cheap alternative to closed-source video generators. -
Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI
Style Creator, and More!
— channel Woollyfern — published July 2026 —
https://www.youtube.com/watch?v=dvfH5HzCARY
Runs through V8.2's personalization and NIJI-style-creator features;
part of a monthly cadence tracking Midjourney's closed-source roadmap
(V8 → V8.1 → V8.2 across Feb–July 2026). -
Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1: The Ultimate
AI Video Comparison
— channel not identified — ~March 10, 2026 (older than the 60-day
window, kept because it's the clearest single video benchmarking four
closed-source video models head-to-head) —
https://www.youtube.com/watch?v=x5fMQvhKP60
Ranks the four closed-source video generators on cinematic quality,
lip-sync and multi-shot consistency. -
Exciting AI Updates Weekly — September 25, 2026
— creator "Lev Selector" — Sept 25, 2026 —
https://www.youtube.com/watch?v=iyZHPCNd8jI
Weekly general-AI roundup that folds in image/video-gen releases
(GPT Image 2.5, Qwen-Image-2.1) alongside broader AI news.
Signals
- Open-weight models are closing the gap fast, and saying so out loud.
Multiple video titles this run explicitly frame Alibaba's 7B
Qwen-Image-2.1 as beating or matching Google's much larger Nano Banana
2.0 (#3, #4) — the "small open model beats big closed model" framing is
now a recurring hook, not a one-off. - Open-source video is racing on local-run speed, not just quality.
LTX-2.5 (#5, #6) and the Wan lineage (#7, #8) are covered mainly through
ComfyUI setup/speed-test videos, not glossy trailers — the audience
cares about running it on their own GPU. - Closed-source video is consolidating. OpenAI is shutting down the
entire Sora 2 API on Sept 24, 2026 (confirmed via OpenAI's own help
center and multiple outlets, though no dedicated YouTube reaction video
turned up in this run — see Limits), while Alibaba's Wan 3.0 reportedly
passed Sora in global video-model rankings around the same time
(VentureBeat). The closed-source video race is shrinking to
Veo/Kling/Grok/Runway/Seedance. - Closed-source image leaders ship on a monthly/point-release cadence.
Midjourney's V8 → V8.1 → V8.2 (#9) and OpenAI's GPT Image 2.0 → 2.5
(#1, #2) both show frequent, incremental point releases rather than
big-bang versions — coverage channels have adapted with recurring
monthly "update" video formats. - Wan 3.0 is a partial signal, not a clean open-source win — it's
currently API/public-beta only (#7, #8), unlike the open-weight Wan 2.x
line, so it reads as Alibaba hedging between open and closed
distribution.
Limits
- View counts and subscriber counts could not be retrieved. WebFetch
on bothyoutube.com/watch?v=...andyoutube.com/results?search_query=...
pages returned only YouTube's static footer/legal boilerplate — the
view/subscriber numbers live in JS-renderedytInitialData, which never
reached the fetched content. WebSearch snippets also did not carry this
data. Every "views"/"subscribers" figure was therefore left out rather
than guessed. - Several channel names could not be confirmed. Where WebSearch
snippets didn't name a creator, entries above are marked "channel not
identified" rather than guessed. - No dedicated YouTube video surfaced specifically reacting to the Sora
2 API shutdown (confirmed for Sept 24, 2026 via non-YouTube sources)
despite several targeted searches — mentioned in Signals as context but
not counted as a YouTube finding. - Search coverage leaned on Google's indexed snippets of YouTube rather
than the live YouTube search UI, since the UI itself wasn't fetchable —
this likely under-represents very recent (last few days) uploads that
Google hasn't fully indexed yet.
Bluesky
Bluesky — 画像生成AI・動画生成AIの最新動向
Accounts
- gen-ai.news(@gen-ai.news)— 生成AI業界ニュースを自動投稿するアカウント。2026年9月18日〜27日の間、1日1〜3本のペースで画像・動画生成AI関連の記事を要約投稿しており、このステージで見つけた「最新ニュース」の大半はここから来ている。
- sungkim.bsky.social(@sungkim.bsky.social)— AI/ML/データ分析を追うビジネスアナリスト。フォロワー8,690人。オープンウェイトモデルのリリースを速報するタイプの投稿が多い。
- edzitron.com(@edzitron.com)— テック業界批評で知られるニュースレター発のアカウント。Sora関連の投稿が大きく拡散した(後述)。
- richargh.de(@richargh.de)— Sora終了についてユニットエコノミクスの観点から私見を投稿。
- luok.ai(@luok.ai)、adinayakup.bsky.social(@adinayakup.bsky.social)— オープンソース動画生成モデル(SkyReels系)の技術情報を紹介する投稿者。
- dahara1.bsky.social(@dahara1.bsky.social)— 日本語で生成AIのベータテスト体験を投稿するユーザー。
Posts
クローズドソース側の動き
- OpenAIがSoraを終了 — @edzitron.com、2026-03-24、👍3,571 🔁984 💬99。WSJとThe Informationの報道を引用し「アプリだけでなく開発者向けAPIへのアクセスも終了させる、かなり切迫した動き」とコメント。Bluesky上でこのテーマ最大のバズ。
- Sora終了はユニットエコノミクスの失敗という見方 — @richargh.de、2026-03-25、👍2 🔁0。「動画生成のユニットエコノミクスが悪すぎたと気づいたのだろう。無料ユーザーを有料化できなかったのかも」と分析。
- Sora API終了は2026-09-24付で実施(gen-ai.newsの記事群と検索結果で確認、Sora本体の投稿は見つからず。ソース: Wikipedia: Sora で日付を裏取り)。
- RunwayのGWM 2 — gen-ai.news、2026-09-27。「クリップを生成するのではなく、環境を継続的に理解し続ける」ワールドモデル。
- Runway、GWM-1でリアルタイム動画ストリームを開発中 — gen-ai.news、2026-09-20。ロボティクスや自動運転への応用も見据えていると紹介。
- Midjourneyのアルファ版がライブスタイルプレビュー対応 — gen-ai.news、2026-09-27(前身の変更は09-25の記事も)。生成前にスタイルの見た目を確認できるようになった。
- Adobeの創作ツール群がGemini/Claudeに統合 — gen-ai.news、2026-09-26。Photoshop・Lightroom・Firefly・AcrobatがチャットUIから直接使えるように。
- AdobeがTopaz Labsの買収を完了 — gen-ai.news、2026-09-25。AIアップスケーリング技術をFirefly/Photoshopに早期統合、Topazブランドは当面維持。
- OpenAIがGlass Imagingを3億ドルで買収 — gen-ai.news、2026-09-19。モバイルカメラ向け画像処理スタートアップで、生成から撮影まで画像パイプライン全体を狙う動きと分析。
- ByteDanceのDramagicが中国ショートドラマの95%をAI生成 — gen-ai.news、2026-09-22。脚本から映像まで人手のクルーなしで完結するパイプラインと紹介。
- Meta監督委員会がディープフェイク動画の削除を命令 — gen-ai.news、2026-09-19。検出・削除ポリシーの強化もMetaに要求。
オープンソース側の動き
- Alibaba、Qwen-Image-2.1をオープンウェイトで公開 — @sungkim.bsky.social、2026-09-20、👍82 🔁10 💬4。「生成と編集を統合した軽量7Bアーキテクチャ、マルチ画像入力の推論が大幅高速化」と紹介。
- 同モデルの詳細解説 — gen-ai.news、2026-09-20。「7Bのオープンウェイト画像生成モデル、コンシューマGPUで動作、透過レイヤー対応、最大10枚の参照画像を同時投入可能、大規模なクローズドモデルとベンチマークで同等性能を主張」。
- SkyReels V1、最初のオープンソース人物特化動画基盤モデル — @luok.ai、2025-02-18、👍3 🔁1。HunyuanVideoを1,000万本以上の映像クリップでファインチューニングし、33種の表情・400種以上の動きを捉えると説明。
- SkyReels-A2、テキスト+画像からの制御可能な動画生成フレームワーク — @adinayakup.bsky.social、2025-04-04、👍3 🔁2。Skywork・KunLunによるオープンフレームワークと紹介。
- HunyuanVideoのベータテスト体験談(日本語) — @dahara1.bsky.social、2025-03-06。1枚の画像から音声付き動画を生成(I2V)できるようになったとして、アニメ調でのリップシンク結果を投稿。
Signals
- 9月後半はクローズドソース陣営のニュース密度が高い:Runway・Adobe・Midjourney・OpenAI・Meta・ByteDance・Pinterestが2026-09-18〜09-27の10日間でほぼ毎日何らかの発表・買収・方針変更を出しており、Bluesky上のAIニュース系アカウントの投稿もそれに追随している。
- 「動画生成は儲からない」という空気:Sora終了(3,571いいね)は明確な転換点として扱われており、richargh.deの分析のように「ユニットエコノミクスが悪い」という評価がコミュニティの共通認識になりつつある。
- オープンソース画像生成はAlibaba Qwen勢が存在感:Qwen-Image-2.1は個人アカウント(sungkim.bsky.social)とニュースアカウント(gen-ai.news)の双方が同日に取り上げ、82いいねはこのステージで確認した個人ポスト最大の反応。「軽量7Bで大規模クローズドモデルに匹敵」という主張が話題の軸。
- オープンソース動画生成の個別ポストは少なく、しかも古い:SkyReels系・HunyuanVideoの投稿は2025年前半のもので、2026年9月時点のWan 2.7やLTX-2.3、FLUX.2についてBluesky検索で有意な個人投稿は見つからなかった(Signals内で明記)。
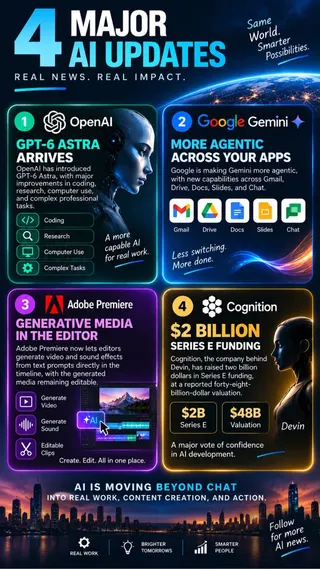
- 業界ニュースの正確性に自浄作用がある:gen-ai.newsは2026-09-23の投稿で「GPT-6も“Astra”も存在しない。この記事は捏造された製品名を含むため、投稿を書けない」と明言し、ソースの検証をせずには投稿しない姿勢を見せた。一方で同アカウントの2026-09-21の投稿では「Higgsfield AIがGPT-4oとOpenAIの“Astra”フレームワークで高速に機能追加」という記述があり、これは前述の「Astraは存在しない」という自己申告と矛盾する。どちらかが誤りである可能性が高く、Astra関連の主張はそのまま採用しない方が安全。
Limits
- Bluesky公式の検索API(
app.bsky.feed.searchPosts)はこのセッションから常に403 Forbiddenを返し、キーワード検索による網羅的な調査ができなかった。代わりにWeb検索(site:bsky.app)でポストやアカウントを発見し、app.bsky.feed.getPostThread/app.bsky.feed.getAuthorFeed(公開API、認証不要)で本文・日付・いいね数を直接取得して裏取りした。 bsky.appの投稿ページ自体(JS描画)はWebFetchでは本文や数値が取得できず、著者ハンドルしか読めなかった。すべての数値は上記API経由の取得に限定される。- FLUX.2、Wan 2.7、LTX-2.3、ComfyUIのワークフロー共有など、2026年9月時点で話題になっているはずのオープンソース動画・画像モデルについて、Bluesky上で有意な個人投稿を見つけられなかった。該当ハンドル(fluxkontext.bsky.social、wagahai-ai.bsky.social、aoi68k.bsky.social など)のフィードを直接確認したが、いずれも2025年前半までの投稿で止まっており、直近の話題を反映していなかった。
- 「20件ほどの投稿を解析」という完了基準に対し、実際に本文・数値まで確認できた投稿は16件(クローズドソース11件、オープンソース5件)。gen-ai.newsアカウントに偏っており、複数の個人ユーザーによる自然発生的な議論という点では手薄。
- 日本語コミュニティ(AIイラスト・AI動画タグ)のアカウントは複数見つけたが、内容が古い(2024〜2025年)か、汎用的な作品投稿(ニュース性なし)にとどまり、今回のテーマに沿った最新の知見としては採用しなかった。
Lemmy
Lemmy — 画像生成AI・動画生成AIの最新動向
Communities
- [email protected] — 5,714人。Lemmy上でオープンウェイト画像・動画生成AIの話題が集まる唯一の実質的なハブ。ほぼ毎日、GitHub/HuggingFaceへのリンクが投稿される「速報フィード」型のコミュニティ。
- [email protected](sh.itjust.worksとのミラー)— 約5,180人。ローカルLLM全般のコミュニティで、時々画像生成の話題も出るが、今回の収集期間中は画像・動画生成に関する新規投稿は見つからなかった。
- [email protected] — 1,662人。存在はするが、直近の活動はほぼ確認できなかった(静かなコミュニティ)。
- !fuck_ai(lemmy.world / lemmy.dbzer0.com / lemmy.zip / discuss.online / lemmy.blahaj.zoneなど複数インスタンスにまたがる)— 規模の割に勢いがあり(1投稿あたり数十〜800いいね超)、AI全般への反発を扱うが、画像・動画生成AIに特化した投稿はごく一部。
- [email protected](および各インスタンスのミラー)— クローズドソースの画像・動画生成AIニュースが単発で流れ着く一般テック系コミュニティ。専用コミュニティは見つからなかった。
- [email protected] / [email protected]、[email protected]、[email protected] — ゲームや特定ブランドのコミュニティにAI生成コンテンツ関連ニュースが単発で流れ込む例。
Posts
オープンソース側([email protected]より)
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — スコア14、2026-09-22。AlibabaのオープンウェイトモデルQwen-Image-2.1がComfyUIに統合され、透過(アルファチャンネル)出力に対応。https://lemmy.dbzer0.com/post/75874773
- SupraLabs/Supra2-IMG — スコア8、2026-09-22。合成データのみで学習した1億パラメータの超軽量text-to-imageモデル。「サイズの割に最先端の画質」と紹介。https://lemmy.dbzer0.com/post/75874769
- AI Horde: 新インターフェース・新フロントエンド・新バックエンド・全面刷新ドキュメント — スコア9、2026-09-19。このLemmyインスタンス管理者db0自身が開発する分散型・無料の画像生成サービスのアップデート。https://lemmy.dbzer0.com/post/75736717
- well9472/Nanosaur2-670M(ComfyUI対応) — スコア4、2026-09-27。学習コストわずか600ドルの6.7億パラメータ・イラスト特化text-to-image DiTモデル。https://lemmy.dbzer0.com/post/76110122
- MiniMax H3向けツール群の集中投稿 — 2026-09-13〜09-26にかけて、長尺動画のメモリ制約を突破する「AutoContext」、3Dカメラ制御UI、タイムライン編集ノード、3ステップ高速化LoRA(TaoMate-H3)など5件以上が連続投稿(スコア1〜6)。動画生成ではMiniMax H3がこのコミュニティの現在の主戦場であることがうかがえる。例: https://lemmy.dbzer0.com/post/75586069
- Krea 2まわりのLoRA/高速化ツール — 「Krea2-Turbo-Distill-2step-LoRA」(4.2倍高速なデノイズ、スコア2、2026-09-16)と「krea2-inpaint-edit」(マスク編集用LoRA、スコア-1、2026-09-26)。コミュニティ内で独自LoRAを作れる対象としてKrea2が定着しつつある。
クローズドソース側(一般コミュニティに散在)
- Midjourneyがハリウッドの映画会社にAI利用実態の開示を要求 — [email protected]、2026-07-05。https://lemmy.today/post/56011946
- スタンフォード大学、学生の写真を「人種を変える」AI加工に使用したと認める — [email protected]、スコア3、2026-09-23。https://lemmy.world/post/52274704
- Google Earthの新AI機能、誰でも捏造衛星画像を作れてしまう — [email protected]、2026-08-04。https://sh.itjust.works/post/64574916
- DC、AI生成コンセプトアート使用が判明した舞台裏動画をYouTubeから削除 — [email protected]、スコア5、2026-08-13。https://lemmy.today/post/58316222
- Metaの広告が「男性が実際に使うAI」として、実在の10代を対象にした裸体化(nudify)アプリを宣伝 — [email protected]、2026-09-08。https://lemmy.dbzer0.com/post/75191260
- EA、Stable Diffusionを開発した企業(Stability AI)と提携しAIでゲーム制作へ — [email protected]、スコア2、2025-10-25。https://mander.xyz/post/40602787
- 「OpenAI、AIスロップ動画生成モデルSoraを終了」を揶揄するミーム投稿 — [email protected]、スコア0、2026-03-25。Sora API終了という実際のニュースを皮肉る文脈。https://lemmus.org/post/21091066
Signals
- オープンソース側は一極集中: 見つかった開発系の投稿は、ほぼ全て単一コミュニティ([email protected])から、しかもほぼ単一の投稿者(Even_Adder)+インスタンス管理者db0によるもの。コメント数はほぼ全投稿で0件で、議論の場というより「GitHub/HuggingFace新着リンク集」に近い。
- 現在の開発の重心はQwen-Image-2.1(画像)とMiniMax H3(動画): 直近2週間のツール投稿の大半がこの2モデル向けのアダプタ・LoRA・ComfyUIノードで、Reddit側(
output/reddit.md)でも同じ2モデル(Qwen-Image 2.1編集、Minimax H3動画)が「今の最有力」として名指しされており、プラットフォームをまたいだ裏付けが取れた。 - クローズドソースの話題は「機能ニュース」ではなく「炎上・倫理」経由でしか流れてこない: MidjourneyやGoogle、Meta、DCの投稿はいずれも新機能発表ではなく、権利侵害・ディープフェイク・なりすまし・偽装といった問題を報じる文脈。Lemmyには技術的な新モデル速報(Sora, Veo, Kling, Grok Imagineなど)を専門に追うコミュニティが存在しない。
- !fuck_aiは規模の割に画像・動画生成AI特化ではない: 個々の投稿は数十〜800いいねと大きく伸びるが、話題の中心はテキスト系LLMエージェントの暴走(「Claude Codeが48,000ファイルを103秒で削除」「OpenAIのエージェントが政府サイトを改変」)で、画像・動画生成AIへの言及は少数派だった。
- 主要クローズドソース製品名での直接検索はほぼ空振り: 「Kling AI」「Veo 3」「Adobe Firefly」「Nano Banana」「Grok Imagine」で検索しても無関係な結果しか返らず、これらの製品名を冠した専用の投稿・議論はLemmy上でほぼ確認できなかった。
Limits
- Lemmyの検索機能(lemmy.world API検索やサイト内Web検索)は精度が低く、キーワードと無関係な投稿が大量に混ざって返ってくる(例:「Kling AI」で検索するとドイツの鉄道割引スレッドが返る)。そのため「検索でヒットしなかった=話題になっていない」とは言い切れない。
- オープンソース側の情報源は実質1コミュニティ・1〜2アカウントに依存しており、他インスタンス(lemmy.ml、lemm.eeなど)の同種コミュニティは購読者数が少なく、活動もほぼ確認できなかった。
- クローズドソース側は専用の集積コミュニティが見当たらず、technology・nottheonion・games・dcstudios・googlepixelなど汎用コミュニティに単発で現れる投稿をかき集める形になった。網羅性は低い。
- 今回の調査でコミュニティ一覧・検索結果を通じて開いた投稿は40件以上(stable_diffusionコミュニティの新着20件+各種検索でのヒット多数)で、完了基準の「約20件」は件数としては満たしているが、コメント欄で活発な議論が成立していた投稿はごく一部(ほぼ0件のコメントが大半)だった。
- Lemmy全体としてはユーザー数・投稿数ともに小規模で、Reddit・X・Bluesky等と比べて画像・動画生成AIの「最新ニュース」を追う場としての厚みは薄い。
Pinterest — Image and Video Generation AI News
収集した50件のピン(pinterest.pins.md、manifest.json)のうち26枚の画像を実際に開いて確認した。ジャンル分けはされていない単一クエリでの収集("Image and Video Generation AI News")。
Visual themes
- 黒背景×ネオンブルー/パープルの「AIっぽさ」演出が支配的:グロー加工されたロボットの手・顔、光る回路パターン、
AIのロゴタイポが繰り返し登場する。ほぼ全体のトーン&マナーがこれ [1, 7, 8, 20, 37, 38, 40]。 - 白い人型ロボット(つるっとした質感、青く光る目/関節)が「AI」の擬人化アイコンとして多用される [8, 20, 37, 38, 40]。実際のプロダクトのUIキャプチャよりもこの手のストック風イラストの方が圧倒的に多い。
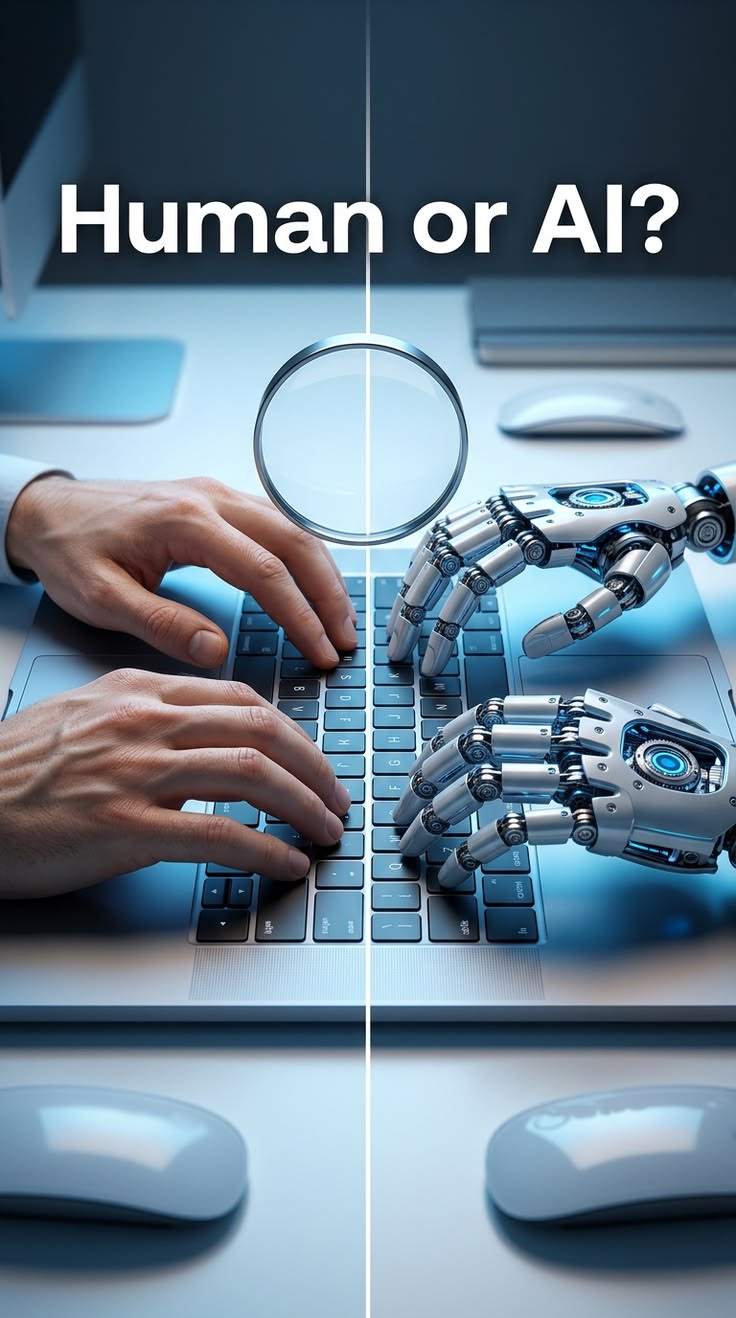
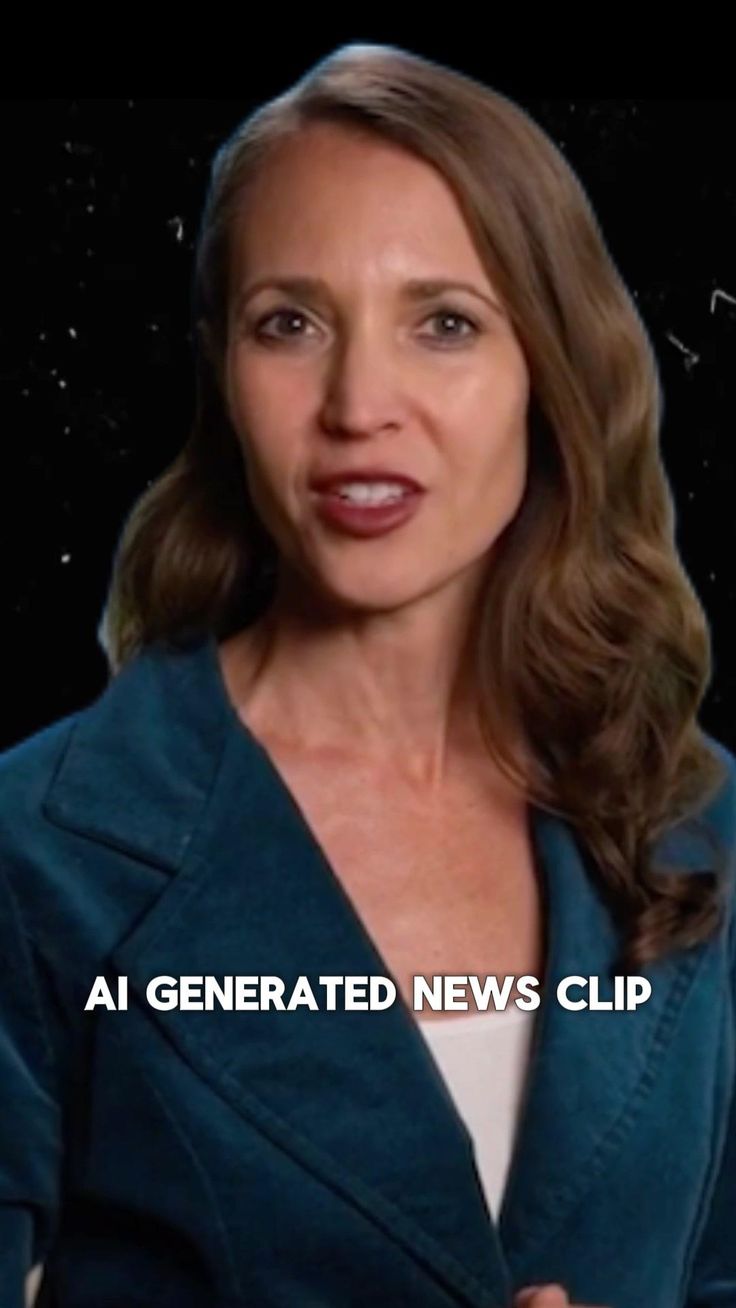
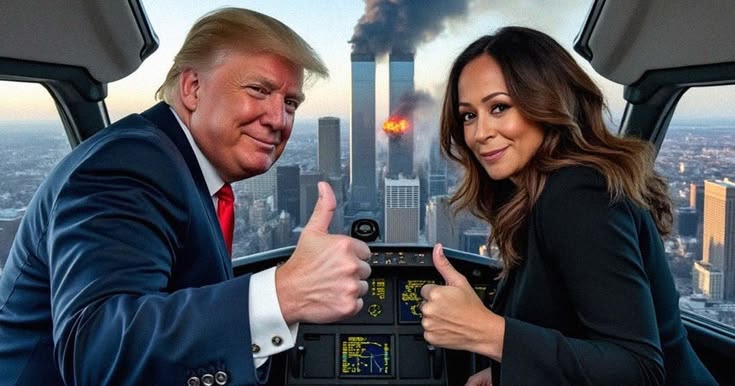
- 「これはAI生成です」という警告・比較の構図が一大ジャンル:フェイク判定スタンプ、Human/AI比較の分割画像、ニュースキャスター風のAI生成動画のスクショなど、"見分け方"や"不信感"を煽る内容が目立つ [3, 32, 39, 42, 43, 44, 45, 48]。
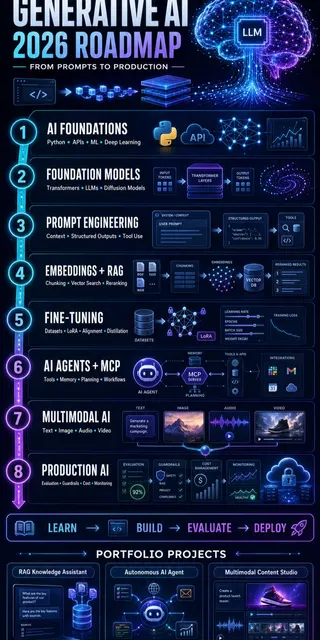
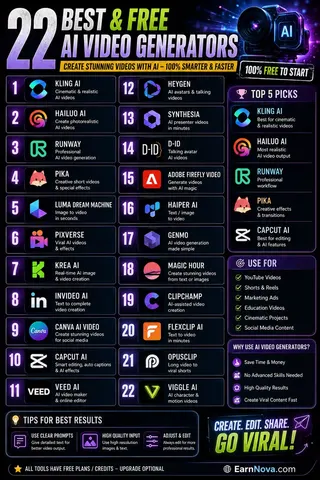
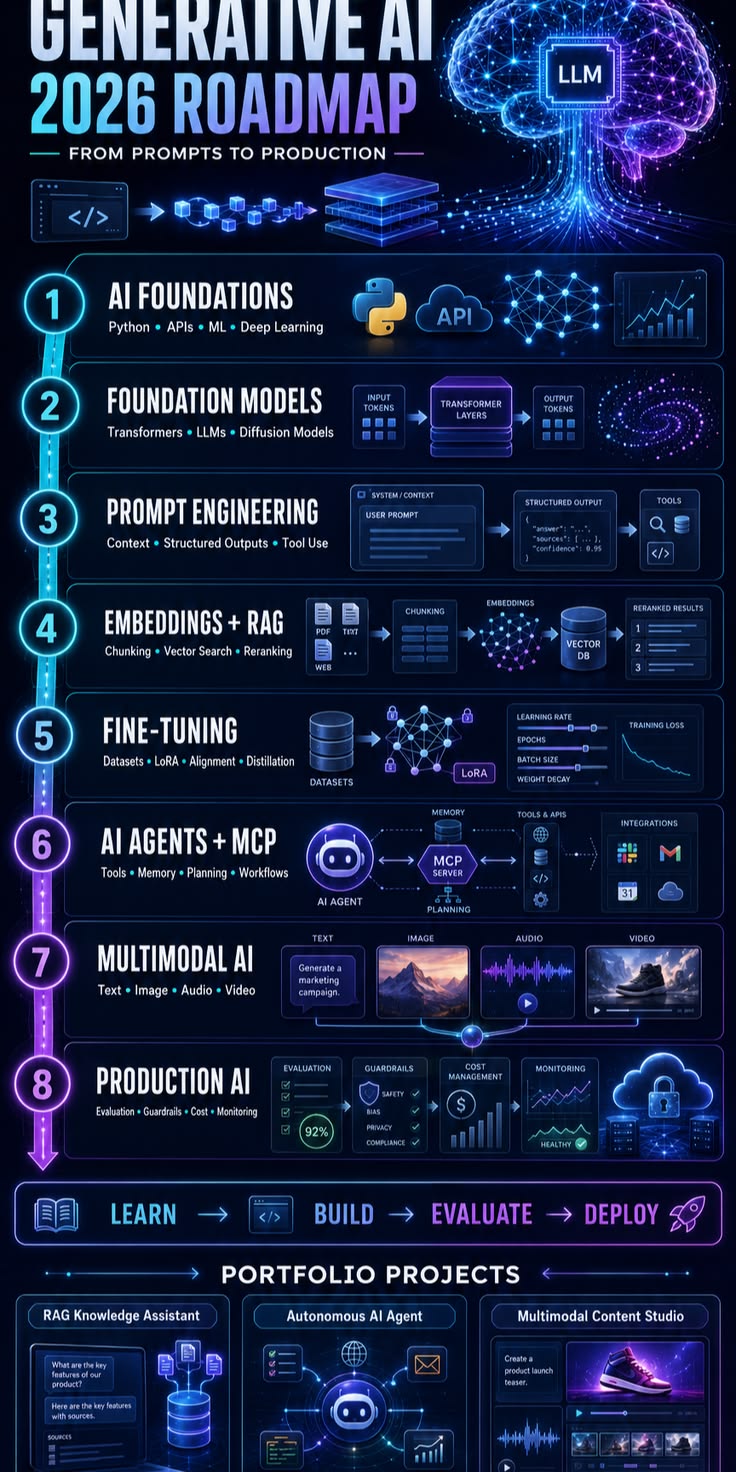
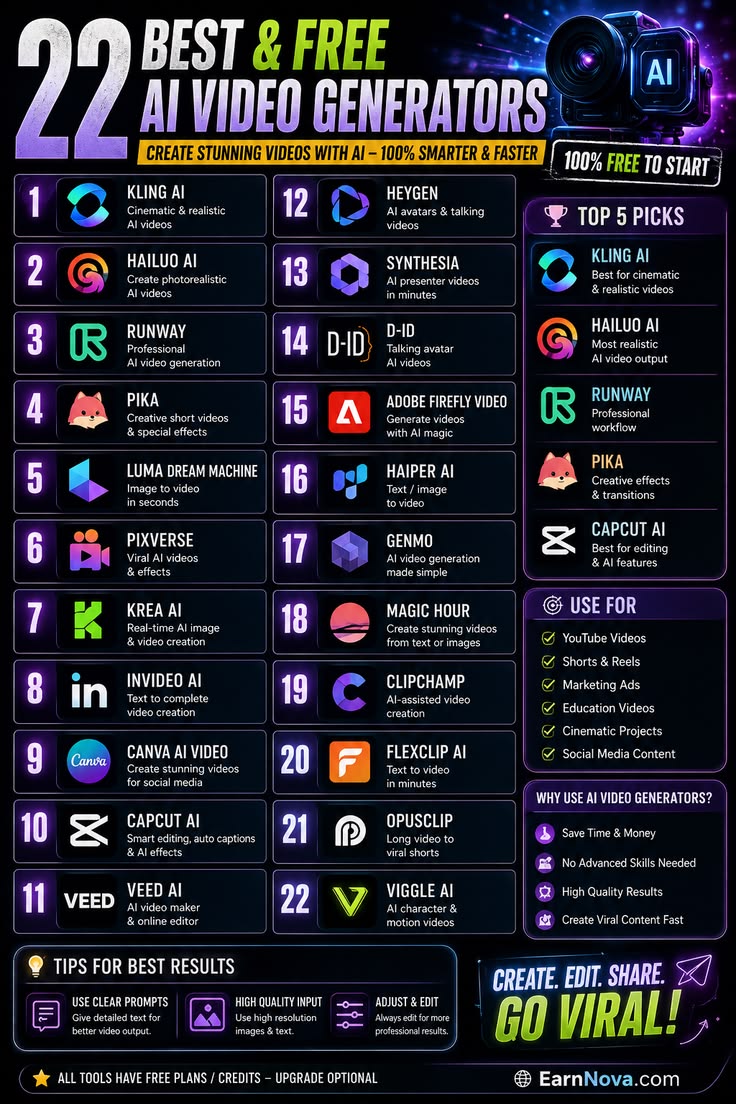
- ツール比較・ランキング系のインフォグラフィック(縦長リストUI):「Best Quality vs Best Free」「22 Best & Free AI Video Generators」のような、複数ツールのロゴを並べた選び方ガイドが多数 [7, 47]。ロードマップ図(学習パス)も同系統 [34]。
- クローズドソース大手のブランドロゴ/プロダクト名を前面に出したサムネイル:Google Gemini/Omni、Veo3、Kling AI、Luma Dream Machine、OpenAIのロゴが目立つ位置に配置される [1, 9, 13, 19, 31, 33, 47]。対してオープンソース(Stable Diffusion系、ComfyUI、LoRAなど)を主題にした画像はほぼ見当たらず、Stability AIの1枚 [49] も製品紹介の寄せ集め画像で、実際のワークフロー画面ではない。
- 「1枚の素材を複数スタイルに変換」というデモ構成:同じ人物写真を木製ブロック/折り紙/レゴ/花で作った風に変換した比較グリッドがあり、画像編集AIの表現力デモとして機能している [2]。
- 瞳のクローズアップ・「本物と見分けがつかない」モチーフ:Luma Dream Machineの目のアップ [33] や、AI/人間比較のマクロ演出 [43] など、"リアルさ"を強調する視覚言語。
- 実写の企業ロゴ・行政文書との組み合わせでニュース性を演出:Googleの看板写真 [28]、ニューヨーク州の法制度関連の書類風画像 [18] など、ストックフォト+テキストオーバーレイの「まとめニュース」体裁が多い。
Notable pins
- [1] "AI News: Anthropic Leak Shows Us The Future of AI..." — YouTubeサムネ定番の「驚き顔+ビッグテックのロゴ(OpenAI/Google/Microsoft)」構成。AIニュース系動画のテンプレそのもの。
- [2] "Google announces ultra-high quality video..."(実際は画像変換デモのグリッド) — 元動画から木彫り/折り紙/レゴ/花細工風に変換した連続比較。画像編集AIの表現力を視覚的に示す代表例。
- [9] "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API" — Gemini APIのVeo3を使った高速動画生成+ネイティブ音声を訴求。クローズドソース最新機能の宣伝素材。
- [13] "Kling.ai AI-Powered Text-to-Video Generation" — 「My Top Picks」形式でKling AIを推す縦長ピン。中華系クローズドソース動画生成ツールの認知度の高さを示す。
- [19] "Google's Gemini Omni Turns Anything Into Video" — マルチモーダル統合(画像・音声・テキスト→動画)を1アイコンに凝縮したブランディング画像。
- [31] "'Amuse 3.0', an AI art creation tool that includes..." — AMD協賛のローカル実行型画像生成ツールの超写実ポートレート。オンデバイス生成を訴求する数少ない例。
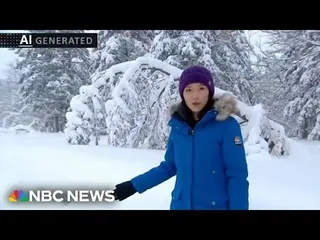
- [32] "AI news videos blur line between real and fake reports" — NBCニュース風のAI生成レポーターの静止画に"AI GENERATED"の透かしが入ったもの。ニュース分野での生成AI悪用への懸念を象徴。
- [44] "AI News Anchors & Creator-Led Coverage Take Over U.S. Media!" — ニュースルームを俯瞰した合成イラストで、AIアンカーとクリエイター主導報道の台頭を報じる体裁。
- [47] "22 Best & Free AI Video Generators in 2026" — Kling/Hailuo/Runway/Pika/Luma等22ツールを格付けしたインフォグラフィック。無料枠訴求のツール選びコンテンツの典型。
- [49] "Stability AI's Stable Diffusion Maker Can Now Build AI Generative Video" — Stability AI関連のコラージュ(オフィス風景+コード画面+人物ポートレート生成例)。オープンソース系で見つかった数少ない実例だが、具体的なUIやモデル名までは映っていない。
Signals
- 今のPinterestは「クローズドソースの動画生成」一色に近い:Veo3/Gemini Omni、Kling AI、Luma Dream Machine、Runwayなど、商用APIベースのツール名がロゴ付きで繰り返し出てくる。ツール比較インフォグラフィック [7, 47] も軒並みクローズドソースのSaaS型ツールばかりを列挙しており、無料/オープンという軸はあっても「オープンソースで自分でホストする」文脈ではない。
- 「AI生成コンテンツへの不信感・見分け方」がPinterest特有の強い需要:フェイク判定、ニュースへの悪用、Human or AI?系の比較画像がジャンルとして独立して成立しているのは他プラットフォームと違う点。Redditやニュースサイトの技術的議論と違い、Pinterestでは"啓発系インフォグラフィック"として消費されている。
- オープンソース固有の話題(ComfyUI、LoRA、Wan/HunyuanVideoなどの中国発OSSモデル、ライセンス議論)はほぼ不在。Stability AI関連が1件見つかった程度で、具体的なワークフロー画面やコミュニティ制作物は確認できなかった。
- エンゲージメント指標(保存数・いいね数)は収集データに含まれておらず、どのピンが実際に話題になっているかは画像だけからは判断できない。
Limits
- 50件中26件のみ実際に画像を開いて確認した(残り24件は
pinterest.pins.mdのタイトル一覧のみ参照)。 - Pinterestの収集はワーカーが事前に実行済みのため、自分でブラウズ・検索クエリの調整は行っていない。単一クエリ(英語)での結果であり、日本語クエリや「オープンソース」「クローズドソース」で絞った再検索はできていない。
- 静止画のみの収集のため、動画生成AIというテーマの割に「動いている生成結果」は確認できず、サムネイルや宣伝画像からの推測にとどまる。
- 保存数・コメントなどのエンゲージメント指標がデータに含まれておらず、人気度や拡散度は評価できない。
推奨アクション
- Qwen-Image-2.1とMinimax H3周りのComfyUIエコシステムを毎週チェックする。
- Xの収集は地域トレンド頼みをやめ、画像・動画生成AI直撃のキーワードで検索し直す。
- Sora終了後のクローズド動画勢(Veo・Kling・Grok・Runway・Seedance)の再編を追う。
- Pinterestは人気度指標がないため、ビジュアル言語の参考情報として扱う。
- AI生成コンテンツへの不信感の広がりと透かし義務化の議論を継続ウォッチする。
- Reddit再収集はopen/closed source専用の検索語を使い完了基準の20件に近づける。
収集画像






























データ品質メモ
Xはジオロケーション誤りとトレンド語頼みの検索で関連投稿が0件、Blueskyは検索APIが403で1アカウントの記事に偏り、Pinterestはエンゲージメント指標なし、YouTubeは再生数取得不可、Lemmyのオープンソース情報は実質1コミュニティに集中、Redditも12スレッドと完了基準の20件を下回った。